Офлайн-расшифровка встреч с разделением по спикерам прямо на вашем компьютере
Foxl Notes умеет расшифровывать встречу на вашем компьютере и отмечать, кто что сказал: Спикер 1, Спикер 2, без загрузки аудио и без входа в аккаунт. Это работает на Mac с Apple silicon и на ПК с Windows и Linux x64. В руководстве: как всё настроить, как метки спикеров справились с нашими тестовыми записями и почему они скорее сольют два близких голоса, чем разделят один, со снимками экрана из v0.9.2.
На этой странице
Foxl Notes умеет расшифровывать встречу прямо на вашем компьютере и помечать каждую реплику: Спикер 1, Спикер 2 и так далее. Выберите движок на устройстве в разделе «Настройки > Запись», затем запишите встречу или импортируйте её аудио. Для расшифровки запись никуда не загружается, ничего не списывается, и аккаунт Foxl не нужен. Это работает на Mac с Apple silicon и на ПК с Windows и Linux x64 после однократной загрузки около 1,3 ГБ.
Что делает диаризация спикеров
Диаризация спикеров делит запись по голосам, так что у каждой строки расшифровки указано, кто говорил. Она никого не опознаёт: она определяет, какие отрезки аудио принадлежат одному и тому же голосу, и присваивает этому голосу номер. В разговоре двух людей именно это помогает найти строку, где один из вас на что-то согласился.
Облачные сервисы расшифровки делают это на своих серверах, после того как вы загрузите запись. Notes делает это на том компьютере, где лежит запись, в том же движке, который распознаёт слова. Модели открытые: segmentation-3.0 от pyannote (лицензия MIT) находит, где сменяется говорящий, а CAM++ от 3D-Speaker сравнивает голоса в каждом отрезке. Обе работают через sherpa-onnx, поэтому не нужно ни устанавливать PyTorch, ни получать токен Hugging Face.
Настройка
- Установите Foxl на Mac с Apple silicon или на ПК с Windows или Linux x64.
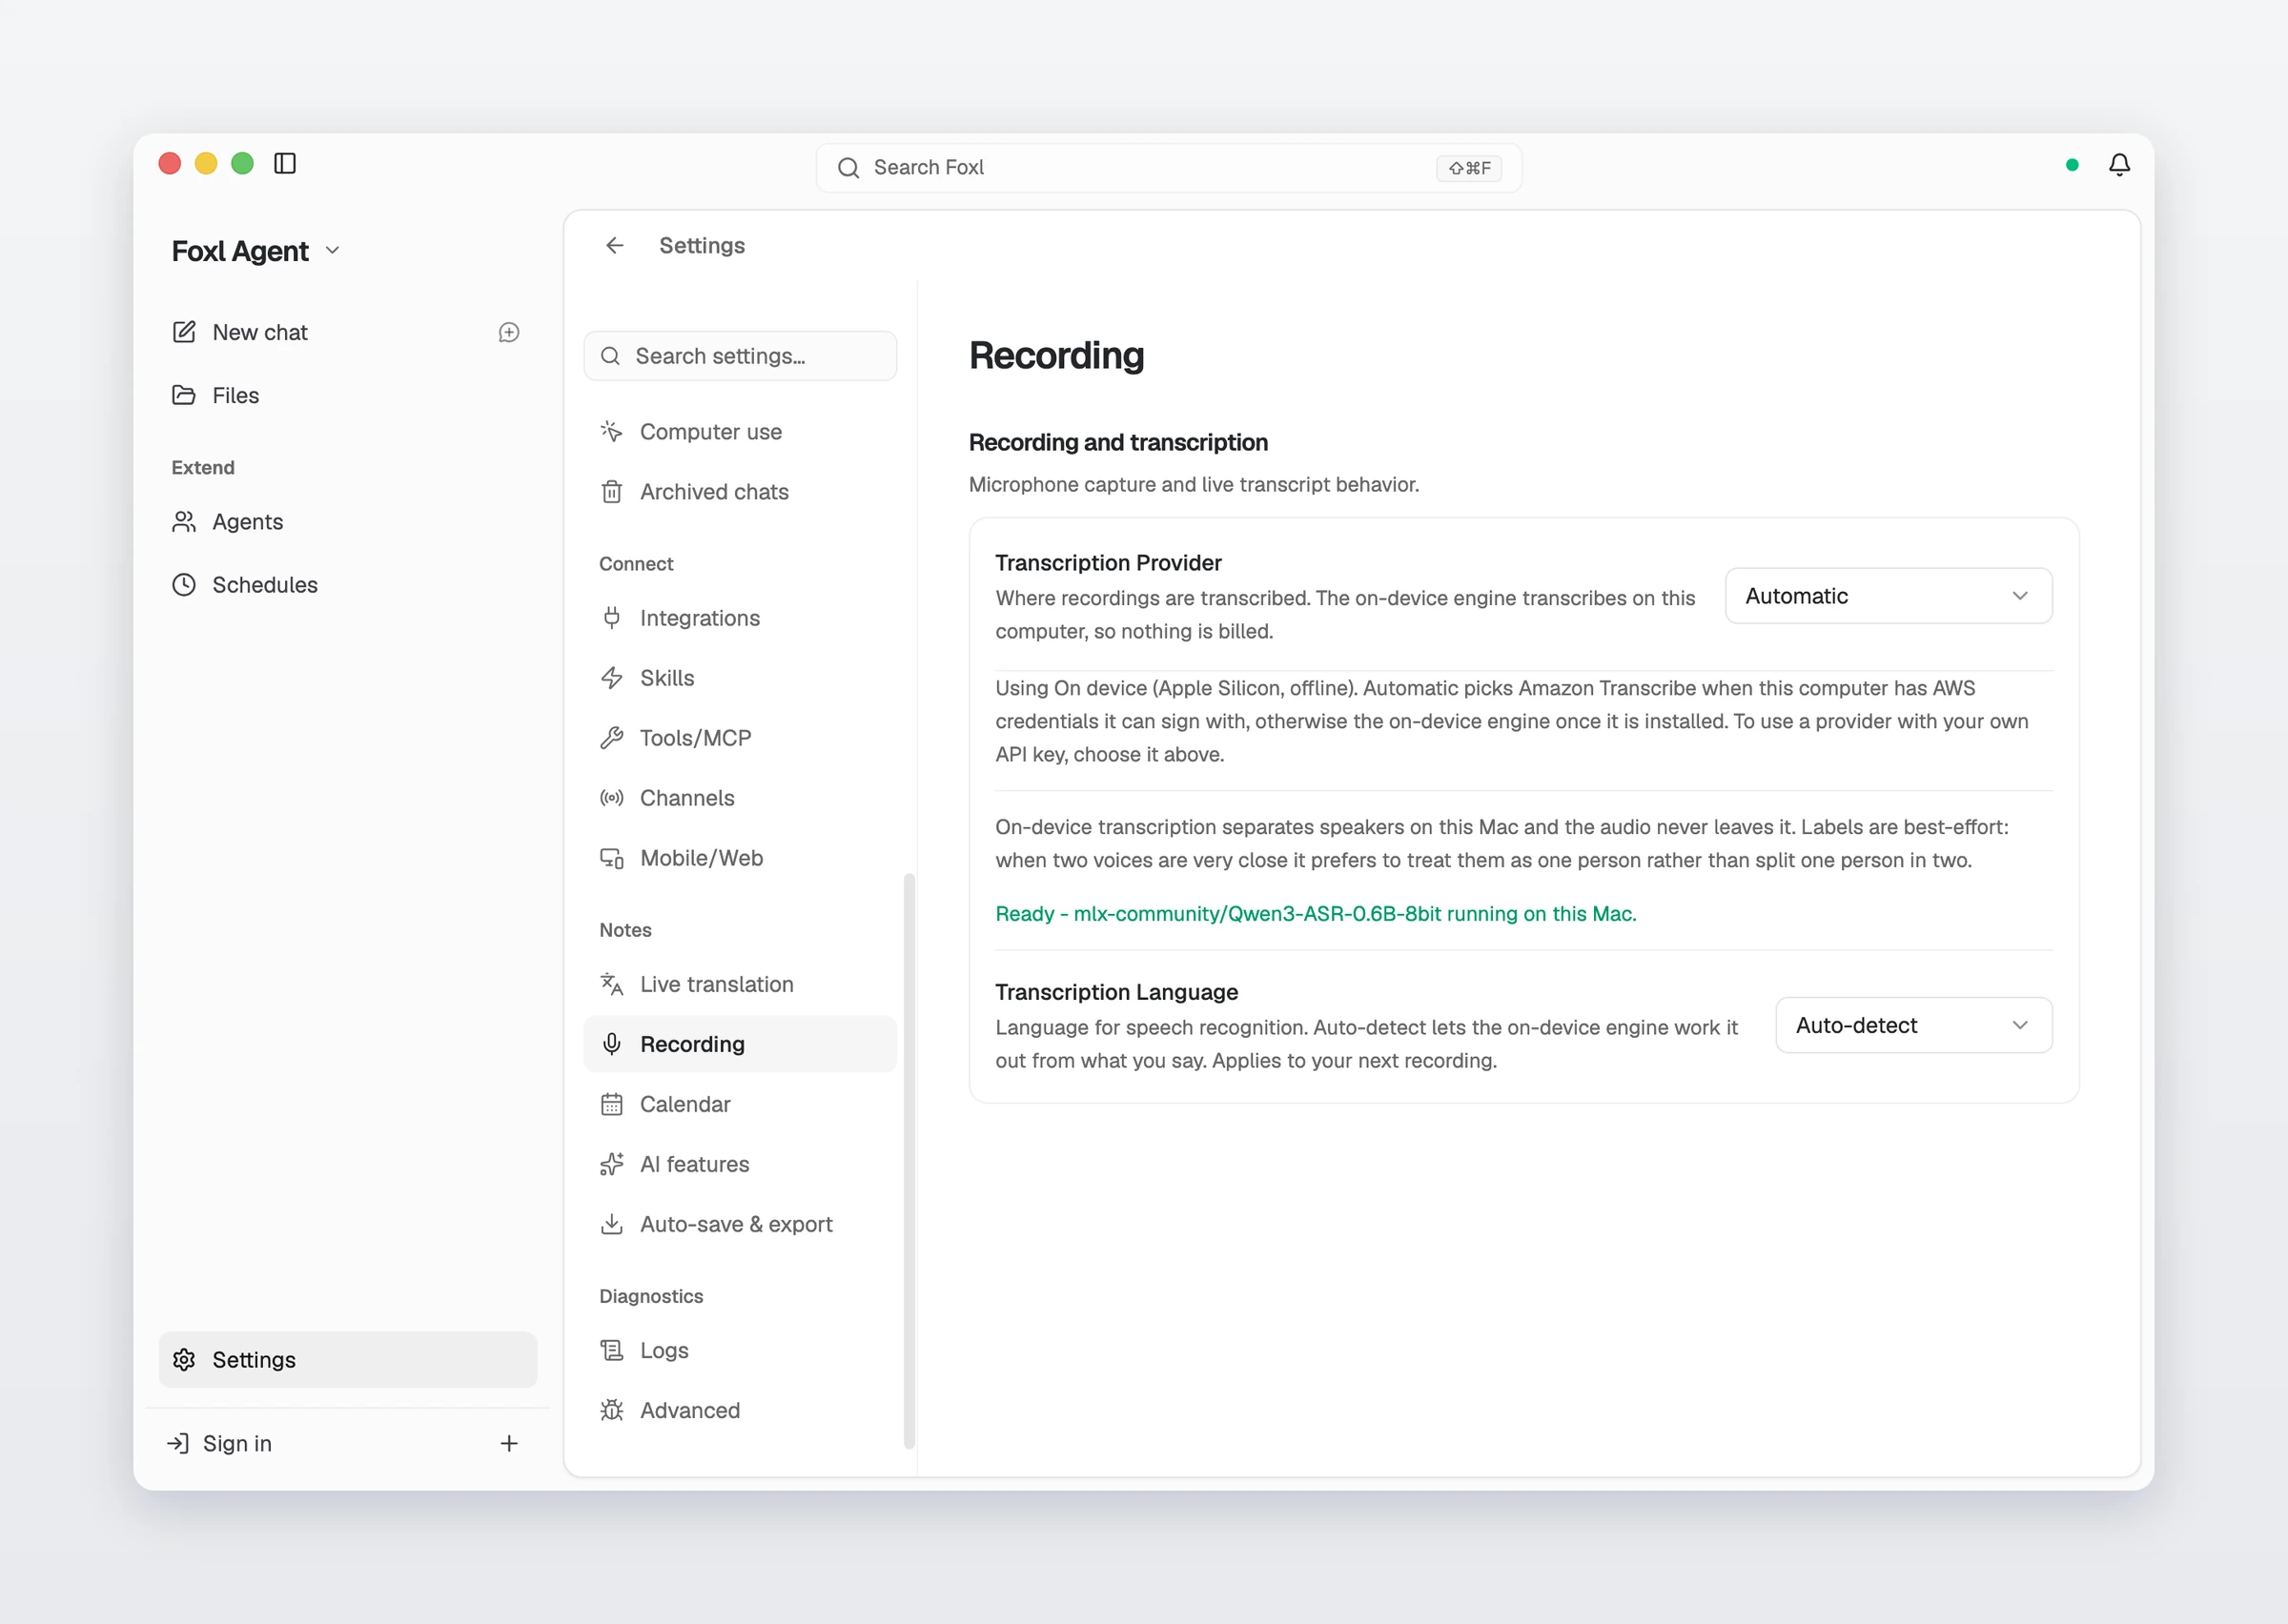
- Откройте «Настройки > Запись». Если в поле «Провайдер транскрипции» выбрано «Автоматически», после установки движка оно само переключится на движок на устройстве, если только на компьютере нет учётных данных AWS. Можно и самостоятельно выбрать «На устройстве».
- Если движок ещё не установлен, нажмите «Установить движок». Это однократная загрузка около 1,3 ГБ, и такую же кнопку предлагает первый экран Notes.
Когда всё готово, в настройках указана модель и сказано, что аудио остаётся на компьютере. На Mac это 8-битная сборка Qwen3-ASR, которая работает на GPU; на Windows и Linux та же модель работает в llama.cpp.
Расшифровка встречи
В Notes нажмите «Начать запись», когда встреча начнётся. Для уже готовой записи используйте «Импорт записи или расшифровки»: Notes принимает wav, mp3, m4a, mp4 и другие аудио- и видеофайлы и начинает расшифровку, как только файл добавлен. На вкладке «Транскрипция» каждая реплика показана с говорящим и временем, когда она началась.
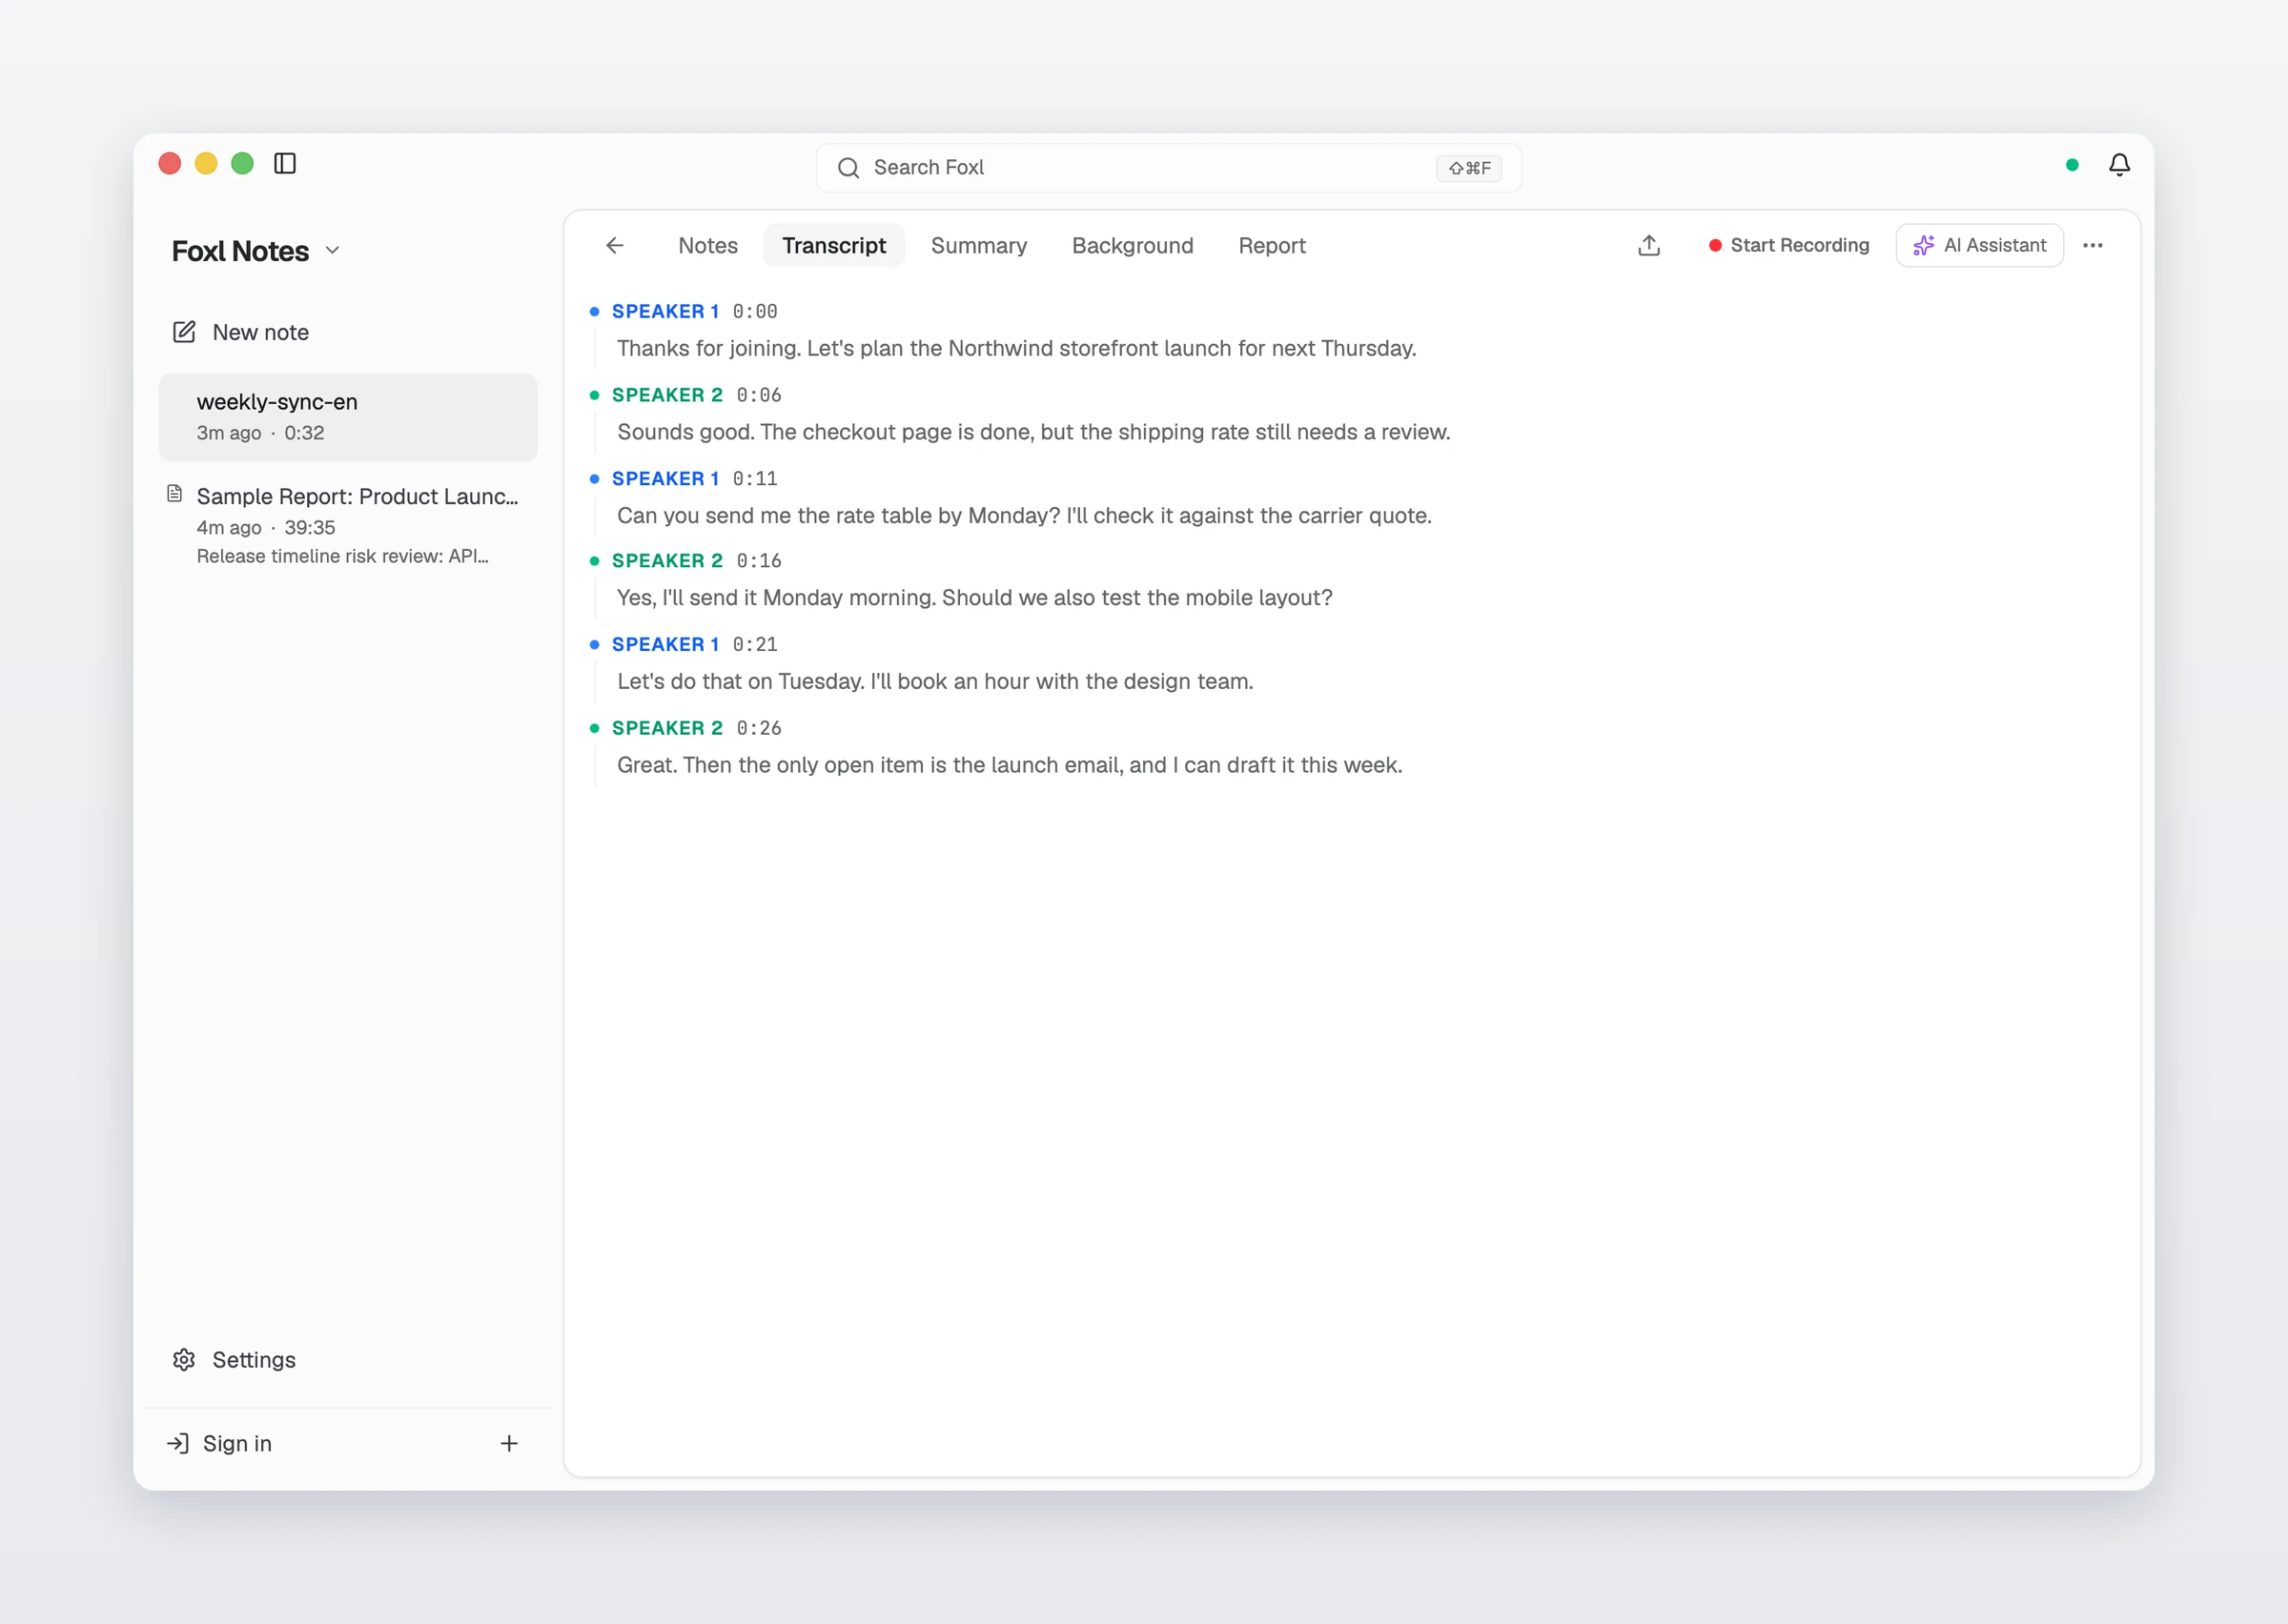
Метки - это номера. Нажмите на метку, чтобы дать этому говорящему имя.
Насколько точны метки?
На нашем собственном оценочном наборе из 10 синтетических разговоров движок в среднем отнёс к правильному говорящему 99,09% аудио. В каждом разговоре два или три синтетических голоса, подобранных так, чтобы они были похожи друг на друга не больше, чем реальные люди, поэтому правильный ответ известен точно. Это делает число результатом теста, а не прогнозом для вашей переговорной. На 14 оценочных файлах, четыре из которых - настоящие записи разговоров, он каждый раз правильно определил число говорящих. Для двух английских голосов одного пола, говорящих без пауз между репликами, верным оказалось 93,3%. Во встрече на снимке экрана выше, тоже из двух синтетических голосов, верно распределены все шесть реплик.
Когда два голоса очень похожи, движок скорее сочтёт их одним человеком, чем разделит одного человека на двоих. В заметках со встречи строка, приписанная не тому человеку, вредит больше, чем строка без явного автора. Мы столкнулись с этим, пока готовили это руководство: встреча одного синтетического голоса с тем же голосом, пониженным по тону, вернулась как один говорящий.
Ограничения
- Он не знает имён. Говорящих вы переименовываете в расшифровке сами.
- Для Mac с процессором Intel и для Linux на arm64 движка на устройстве нет.
- Он не пишет сводки. Для этого нужна модель: либо та, которую вы подключите, либо модель сводок Foxl на устройстве, которая скачивается отдельно.
Куда уходит аудио
Для расшифровки оно остаётся на компьютере. Когда выбран движок на устройстве, в настройках сказано, что расшифровка идёт на этом компьютере и ничего не списывается, а разделение говорящих работает в том же локальном процессе. Поскольку ничего не загружается, всё работает и без подключения к интернету. А то, что вы делаете дальше, например просите облачную модель о сводке, идёт через провайдера, которого вы для этого выбрали.
Источники и дополнительное чтение
- Документация Foxl: записьДокументация
- Документация Foxl: кредиты и конфиденциальность в NotesДокументация
- pyannote segmentation-3.0Справка
- Модели сегментации говорящих sherpa-onnxСправка
- 3D-Speaker (CAM++)Справка
- Qwen3-ASR 0.6B, 8-битная сборка MLXСправка
- Скачать FoxlСправка