화자 분리 프로그램: 회의 녹음을 내 컴퓨터에서 무료로 나누는 법
회의 녹음을 화자별로 나눠서 받아 적고 싶다면 Foxl Notes의 온디바이스 엔진을 고르면 돼요. 내 컴퓨터(Apple Silicon Mac, x64 Windows나 Linux PC)에서 받아 적고 발언마다 화자 1, 화자 2를 붙여 주는데, 아무것도 올리지 않고 요금도 계정도 필요 없어요. 설정하는 법, Foxl의 테스트 녹음에서 화자 라벨이 얼마나 맞았는지, 일부러 조심하는 지점까지 v0.9.2의 실제 화면으로 정리했어요.
이 페이지에서
회의 녹음을 화자별로 나눠서 받아 적고 싶다면, Foxl을 설치하고 설정 > 녹음에서 온디바이스 엔진을 고른 다음 Foxl Notes에서 회의를 녹음하거나 녹음 파일을 가져오면 돼요. 엔진이 내 컴퓨터에서 받아 적고, 발언마다 화자 1, 화자 2처럼 누가 말했는지 붙여 줘요. 음성은 전사하려고 어디로도 보내지 않고, 요금도 나가지 않고, 이 기능에는 Foxl 계정도 필요 없어요. Apple Silicon Mac, Windows x64 PC, Linux x64 컴퓨터에서 돌아가고, 처음 한 번 약 1.3GB를 내려받으면 돼요.
화자 분리가 뭔가요?
화자 분리는 녹음을 말하는 사람별로 나눠서, 전사의 각 줄에 어느 목소리가 한 말인지 표시하는 거예요. 이름까지 알아내지는 않아요. 같은 목소리에서 나온 구간을 묶고 그 목소리에 번호를 붙여요. 두 사람이 나눈 통화라면 줄글 한 덩어리와, 누가 무엇을 하기로 했는지 따라갈 수 있는 대화의 차이예요.
클라우드 전사 서비스는 녹음을 올린 뒤 자기 서버에서 화자를 나눠요. Foxl Notes는 녹음이 있는 그 컴퓨터에서, 글자를 받아 적는 엔진 안에서 화자를 나눠요. 쓰는 모델은 공개된 오픈소스예요. pyannote의 분할 모델(segmentation-3.0, MIT 라이선스)이 말하는 사람이 바뀌는 지점을 찾고, 3D-Speaker의 CAM++ 모델이 각 구간의 목소리를 비교해요. 둘 다 sherpa-onnx로 돌아가서 PyTorch도 Hugging Face 토큰도 필요 없어요.
어떻게 설정하나요?
- Apple Silicon Mac, Windows x64 PC, Linux x64 컴퓨터 중 하나에 Foxl을 설치해요.
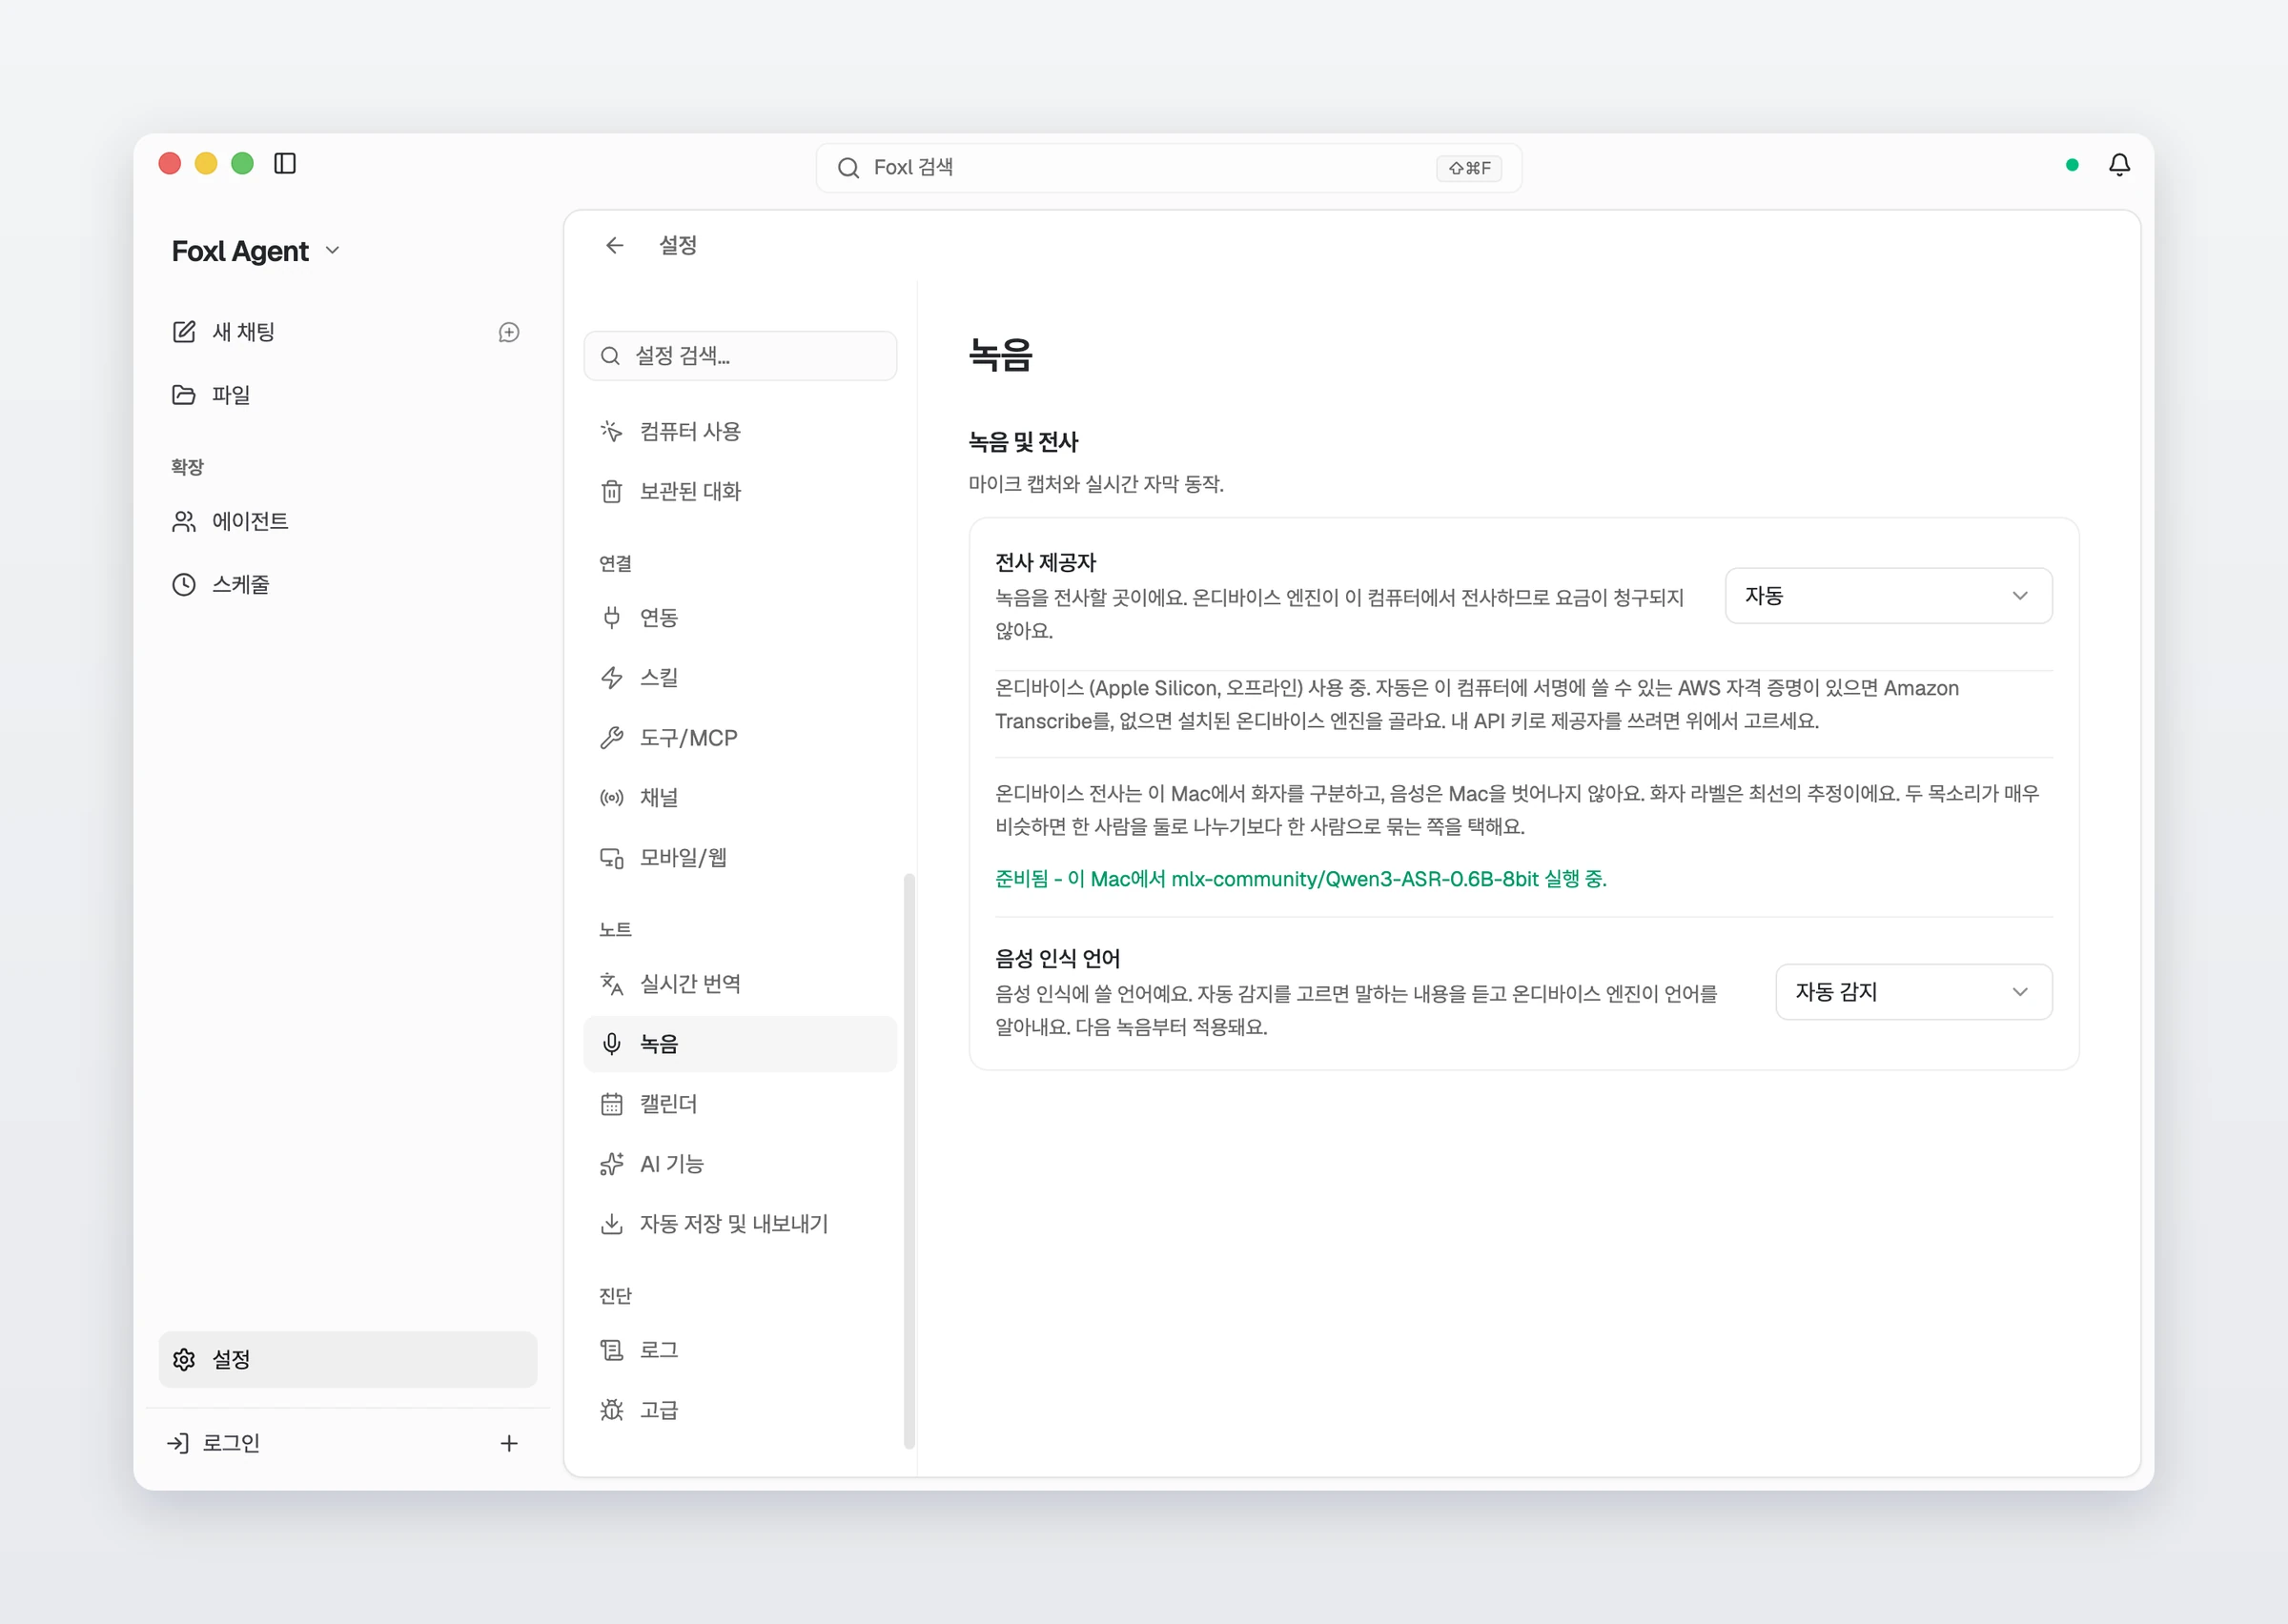
- 설정 > 녹음을 열어요. 전사 제공자가 자동이면, 컴퓨터에 AWS 자격 증명이 없는 한 엔진을 설치한 뒤 온디바이스 엔진을 써요. 확실하게 하려면 온디바이스를 직접 골라도 돼요.
- 엔진이 아직 없으면 엔진 설치를 눌러요. 약 1.3GB를 한 번만 내려받아요. Notes 첫 화면에서도 같은 설치를 할 수 있어요.
준비가 끝나면 설정에 모델 이름과 함께 준비됐다고 나오고, 음성이 컴퓨터를 벗어나지 않는다고 알려 줘요. Mac에서는 Qwen3-ASR의 8비트 빌드가 GPU에서 돌고, Windows와 Linux에서는 같은 모델이 llama.cpp로 돌아가요.
회의를 화자별로 받아 적으려면요?
Foxl Notes에서 회의 중에 녹음 시작을 누르거나, 이미 있는 녹음은 녹음이나 녹취록 가져오기로 넣으면 돼요. wav, mp3, m4a, mp4 같은 오디오와 영상 파일을 가져올 수 있고, 파일을 넣자마자 전사가 시작돼요. 전사 탭을 열면 발언마다 화자와 시작 시각이 붙어 있어요.
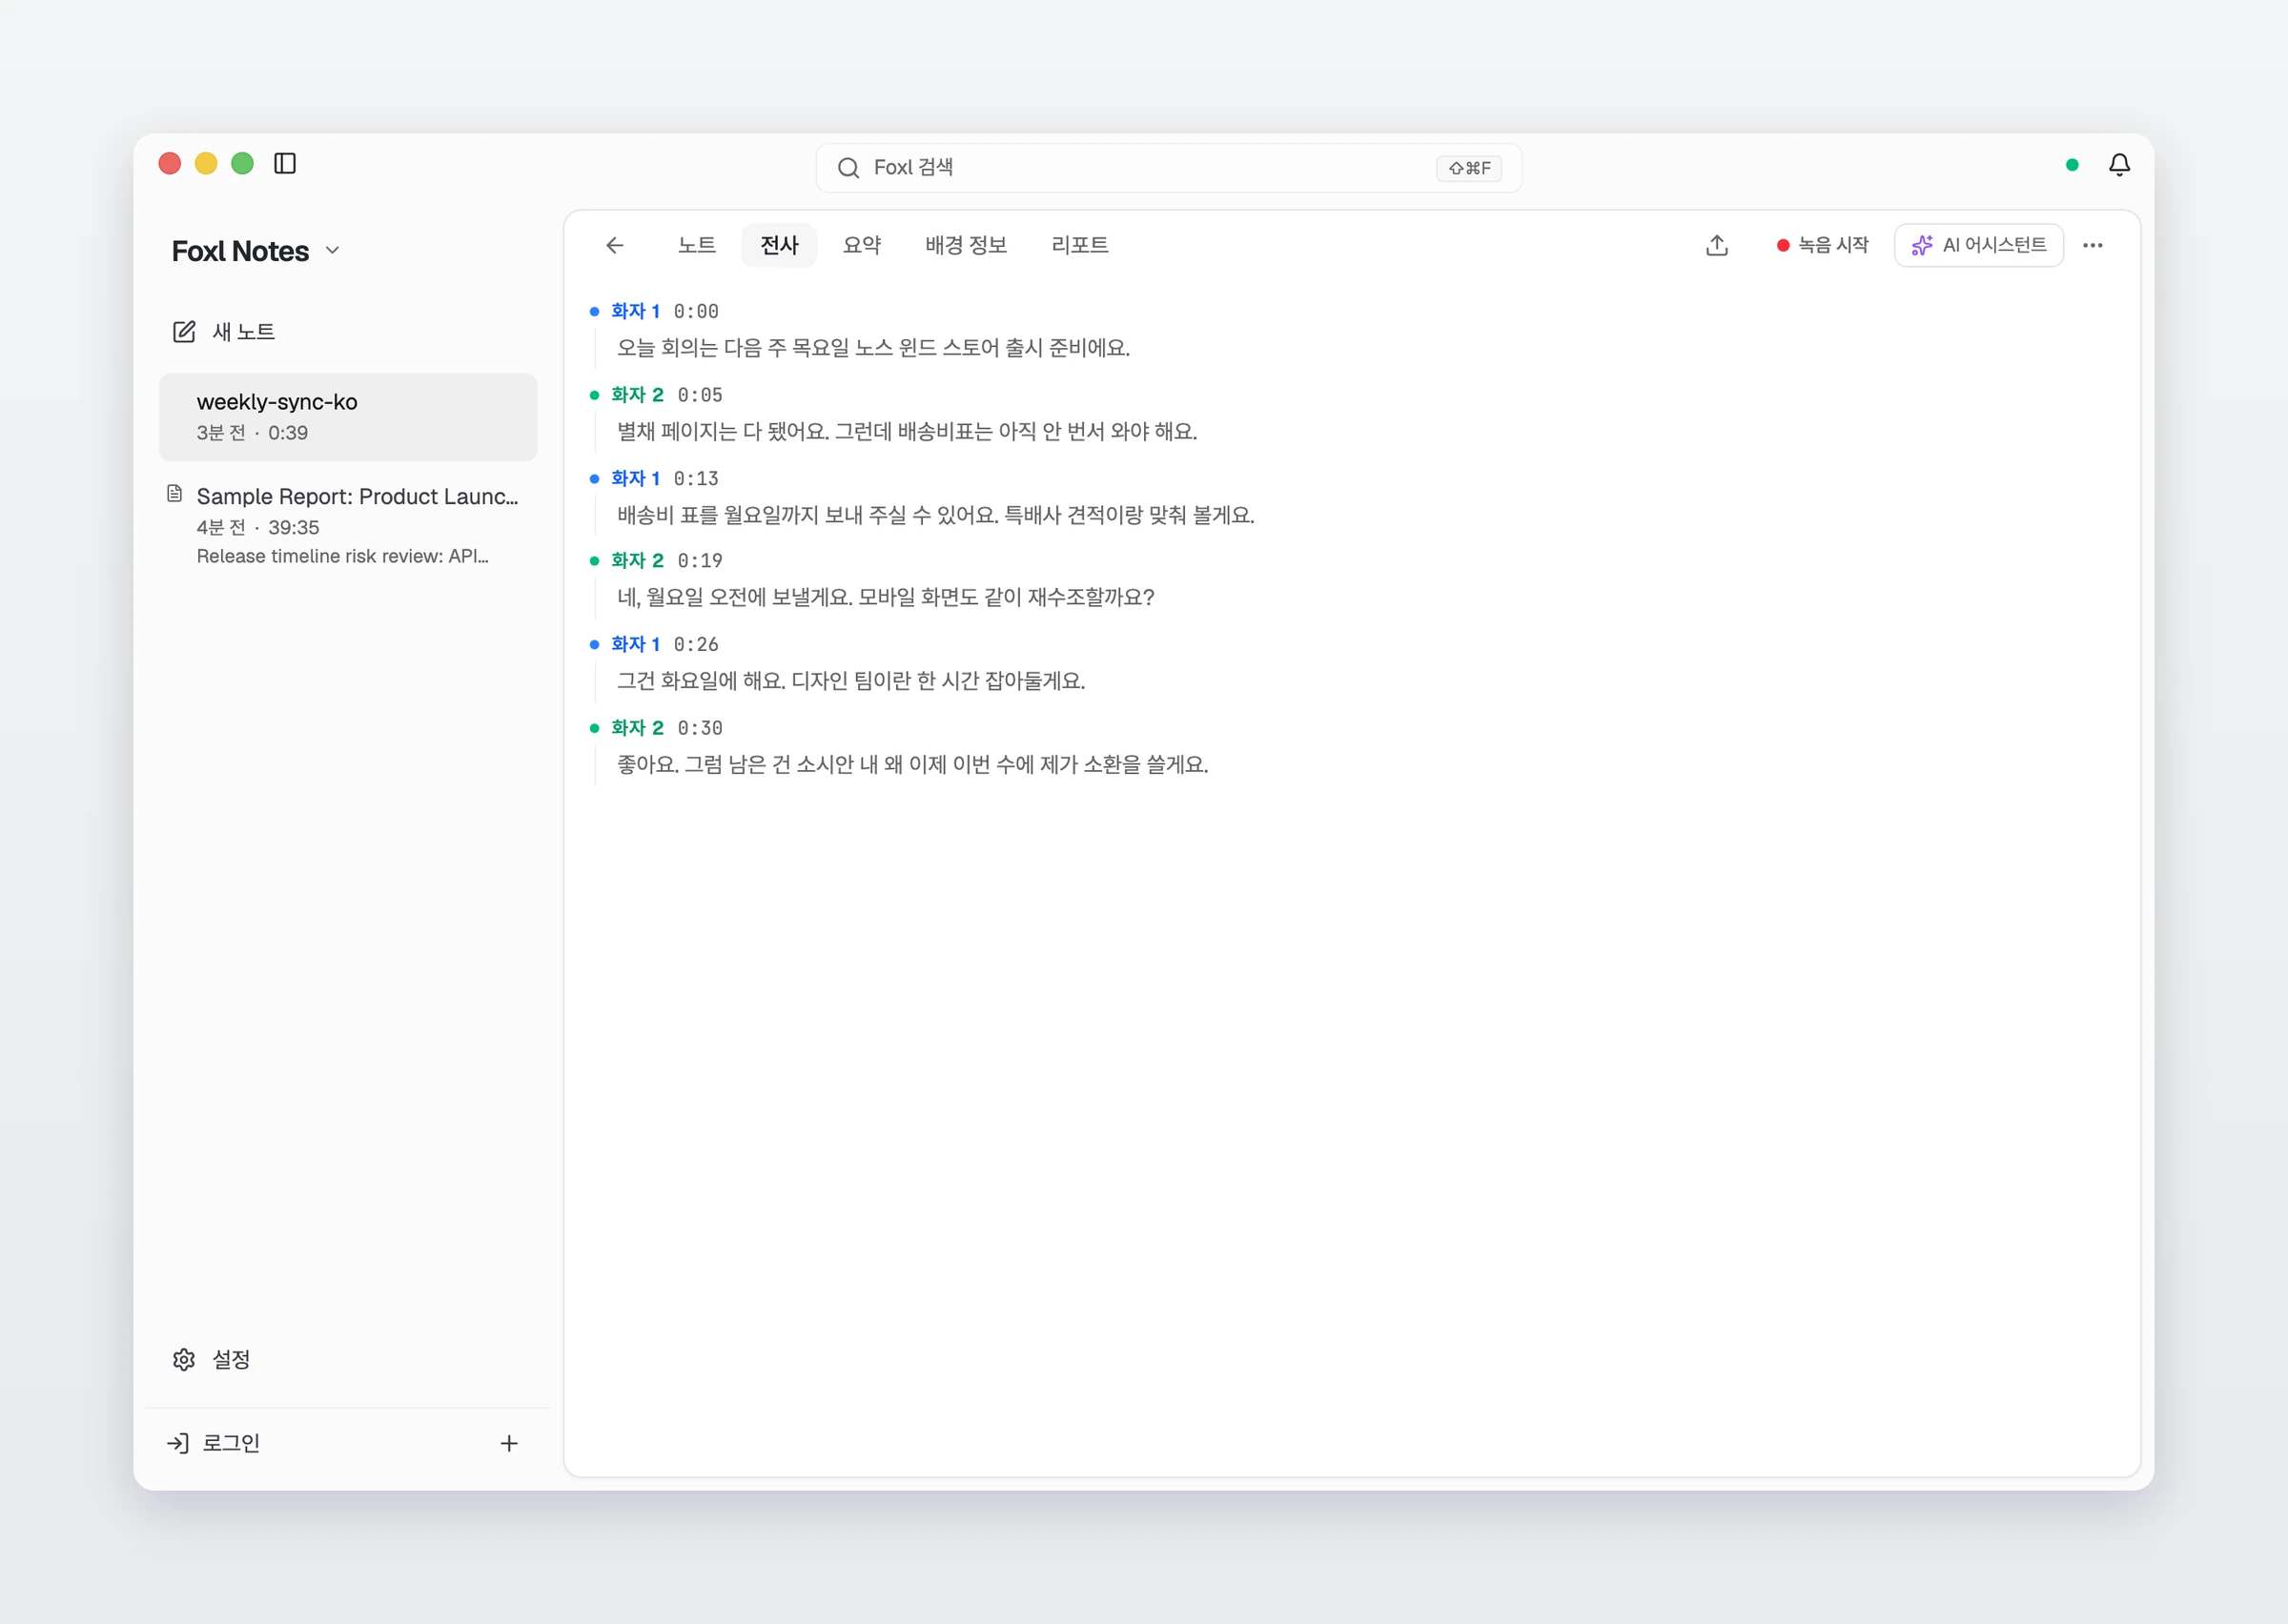
라벨은 이름이 아니라 번호예요. 라벨을 누르면 그 화자의 이름을 바꿀 수 있어요.
화자 라벨은 얼마나 정확한가요?
Foxl이 직접 만든 합성 테스트 대화 10개에서 평균 99.09%의 구간을 맞는 화자에게 붙였어요. 실제 사람들끼리보다 더 닮지는 않은 합성 음성 두세 개로 만들어서 정답을 정확히 아는 녹음이에요. 합성 음성은 실제 회의가 아니니까, 이 숫자는 테스트 결과로 읽어 주세요. 여러분의 회의실에서 나올 숫자는 아니에요. 실제로 녹음한 대화 4개를 포함한 평가 파일 14개에서는 모두 화자 수를 맞혔어요. 같은 합성 테스트에서 같은 성별의 영어 목소리 둘이 쉬지 않고 이어 말한 녹음은 93.3%를 맞혔고, 같은 성별의 한국어 목소리 둘의 대화는 모두 맞혔어요.
라벨은 일부러 최선의 추정으로 만들어요. 두 목소리가 아주 비슷하면 한 사람을 둘로 나누기보다 한 사람으로 묶는 쪽을 택해요. 회의 기록에서 다른 사람에게 잘못 붙은 말이, 누가 했는지 모호한 말보다 더 나쁘기 때문이에요. 이 글을 준비하면서도 그대로 확인했어요. 합성 음성 하나와 그 음성의 높낮이만 낮춘 목소리로 회의를 만들었더니 한 사람으로 묶었어요.
무엇은 안 되나요?
- 이름은 몰라요. 화자는 번호로 붙고, 이름은 전사에서 직접 바꿔요.
- Intel Mac과 Linux arm64 컴퓨터에는 온디바이스 엔진이 없어요.
- 요약은 하지 않아요. 요약에는 모델이 필요해요. 직접 연결한 모델이나, 따로 내려받는 Foxl의 온디바이스 요약 모델을 쓰면 돼요.
녹음은 정말 내 컴퓨터에만 있나요?
전사에 관해서는 그래요. 온디바이스 엔진을 쓰면 설정에서도 이 컴퓨터에서 전사하므로 요금이 청구되지 않는다고 안내하고, 화자 분리도 같은 로컬 프로세스 안에서 돌아요. 전사하려고 올리는 건 없어서 인터넷이 없어도 돼요. 그다음에 클라우드 모델로 요약을 받는 것처럼 무엇을 하든, 그건 그 일에 고른 제공자를 따라요.
참고 자료
- Foxl 문서: 녹음Documentation
- Foxl 문서: Notes의 크레딧과 개인정보Documentation
- pyannote segmentation-3.0Reference
- sherpa-onnx 화자 분할 모델Reference
- 3D-Speaker (CAM++)Reference
- Qwen3-ASR 0.6B, 8비트 MLX 빌드Reference
- Foxl 내려받기Reference