Transcrição de reuniões offline, com identificação de falantes, no seu próprio computador
O Foxl Notes consegue transcrever uma reunião no seu próprio computador e marcar quem disse o quê, Orador 1, Orador 2, sem enviar o áudio e sem login. Funciona em Macs com Apple silicon e em PCs x64 com Windows ou Linux. Este guia mostra como configurar, como os rótulos de falante se saíram nas nossas gravações de teste e por que eles preferem juntar duas vozes parecidas a dividir uma em duas, com capturas de tela da v0.9.2.
Nesta página
O Foxl Notes consegue transcrever uma reunião no seu próprio computador e marcar cada fala como Orador 1, Orador 2 e assim por diante. Escolha o motor no dispositivo em Configuração > Gravação e depois grave a reunião ou importe o áudio dela. A gravação não é enviada a lugar nenhum para ser transcrita, nada é cobrado e você não precisa de uma conta Foxl. Funciona em Macs com Apple silicon e em PCs x64 com Windows ou Linux, depois de um download único de cerca de 1,3 GB.
O que a diarização de falantes faz
A diarização de falantes divide uma gravação por voz, para que cada linha da transcrição diga quem estava falando. Ela não identifica ninguém. Ela descobre quais trechos do áudio vêm da mesma voz e dá um número a essa voz. Numa ligação entre duas pessoas, é isso que permite achar a linha em que uma de vocês concordou com alguma coisa.
Os serviços de transcrição na nuvem fazem isso nos servidores deles, depois que você envia a gravação. O Notes faz isso no computador em que a gravação está, no mesmo motor que escreve as palavras. Os modelos são abertos: o segmentation-3.0 do pyannote (licença MIT) encontra onde o falante muda, e o CAM++ do 3D-Speaker compara as vozes de cada trecho. Os dois rodam pelo sherpa-onnx, então não há PyTorch para instalar nem token do Hugging Face para conseguir.
Como configurar
- Instale o Foxl num Mac com Apple silicon ou num PC x64 com Windows ou Linux.
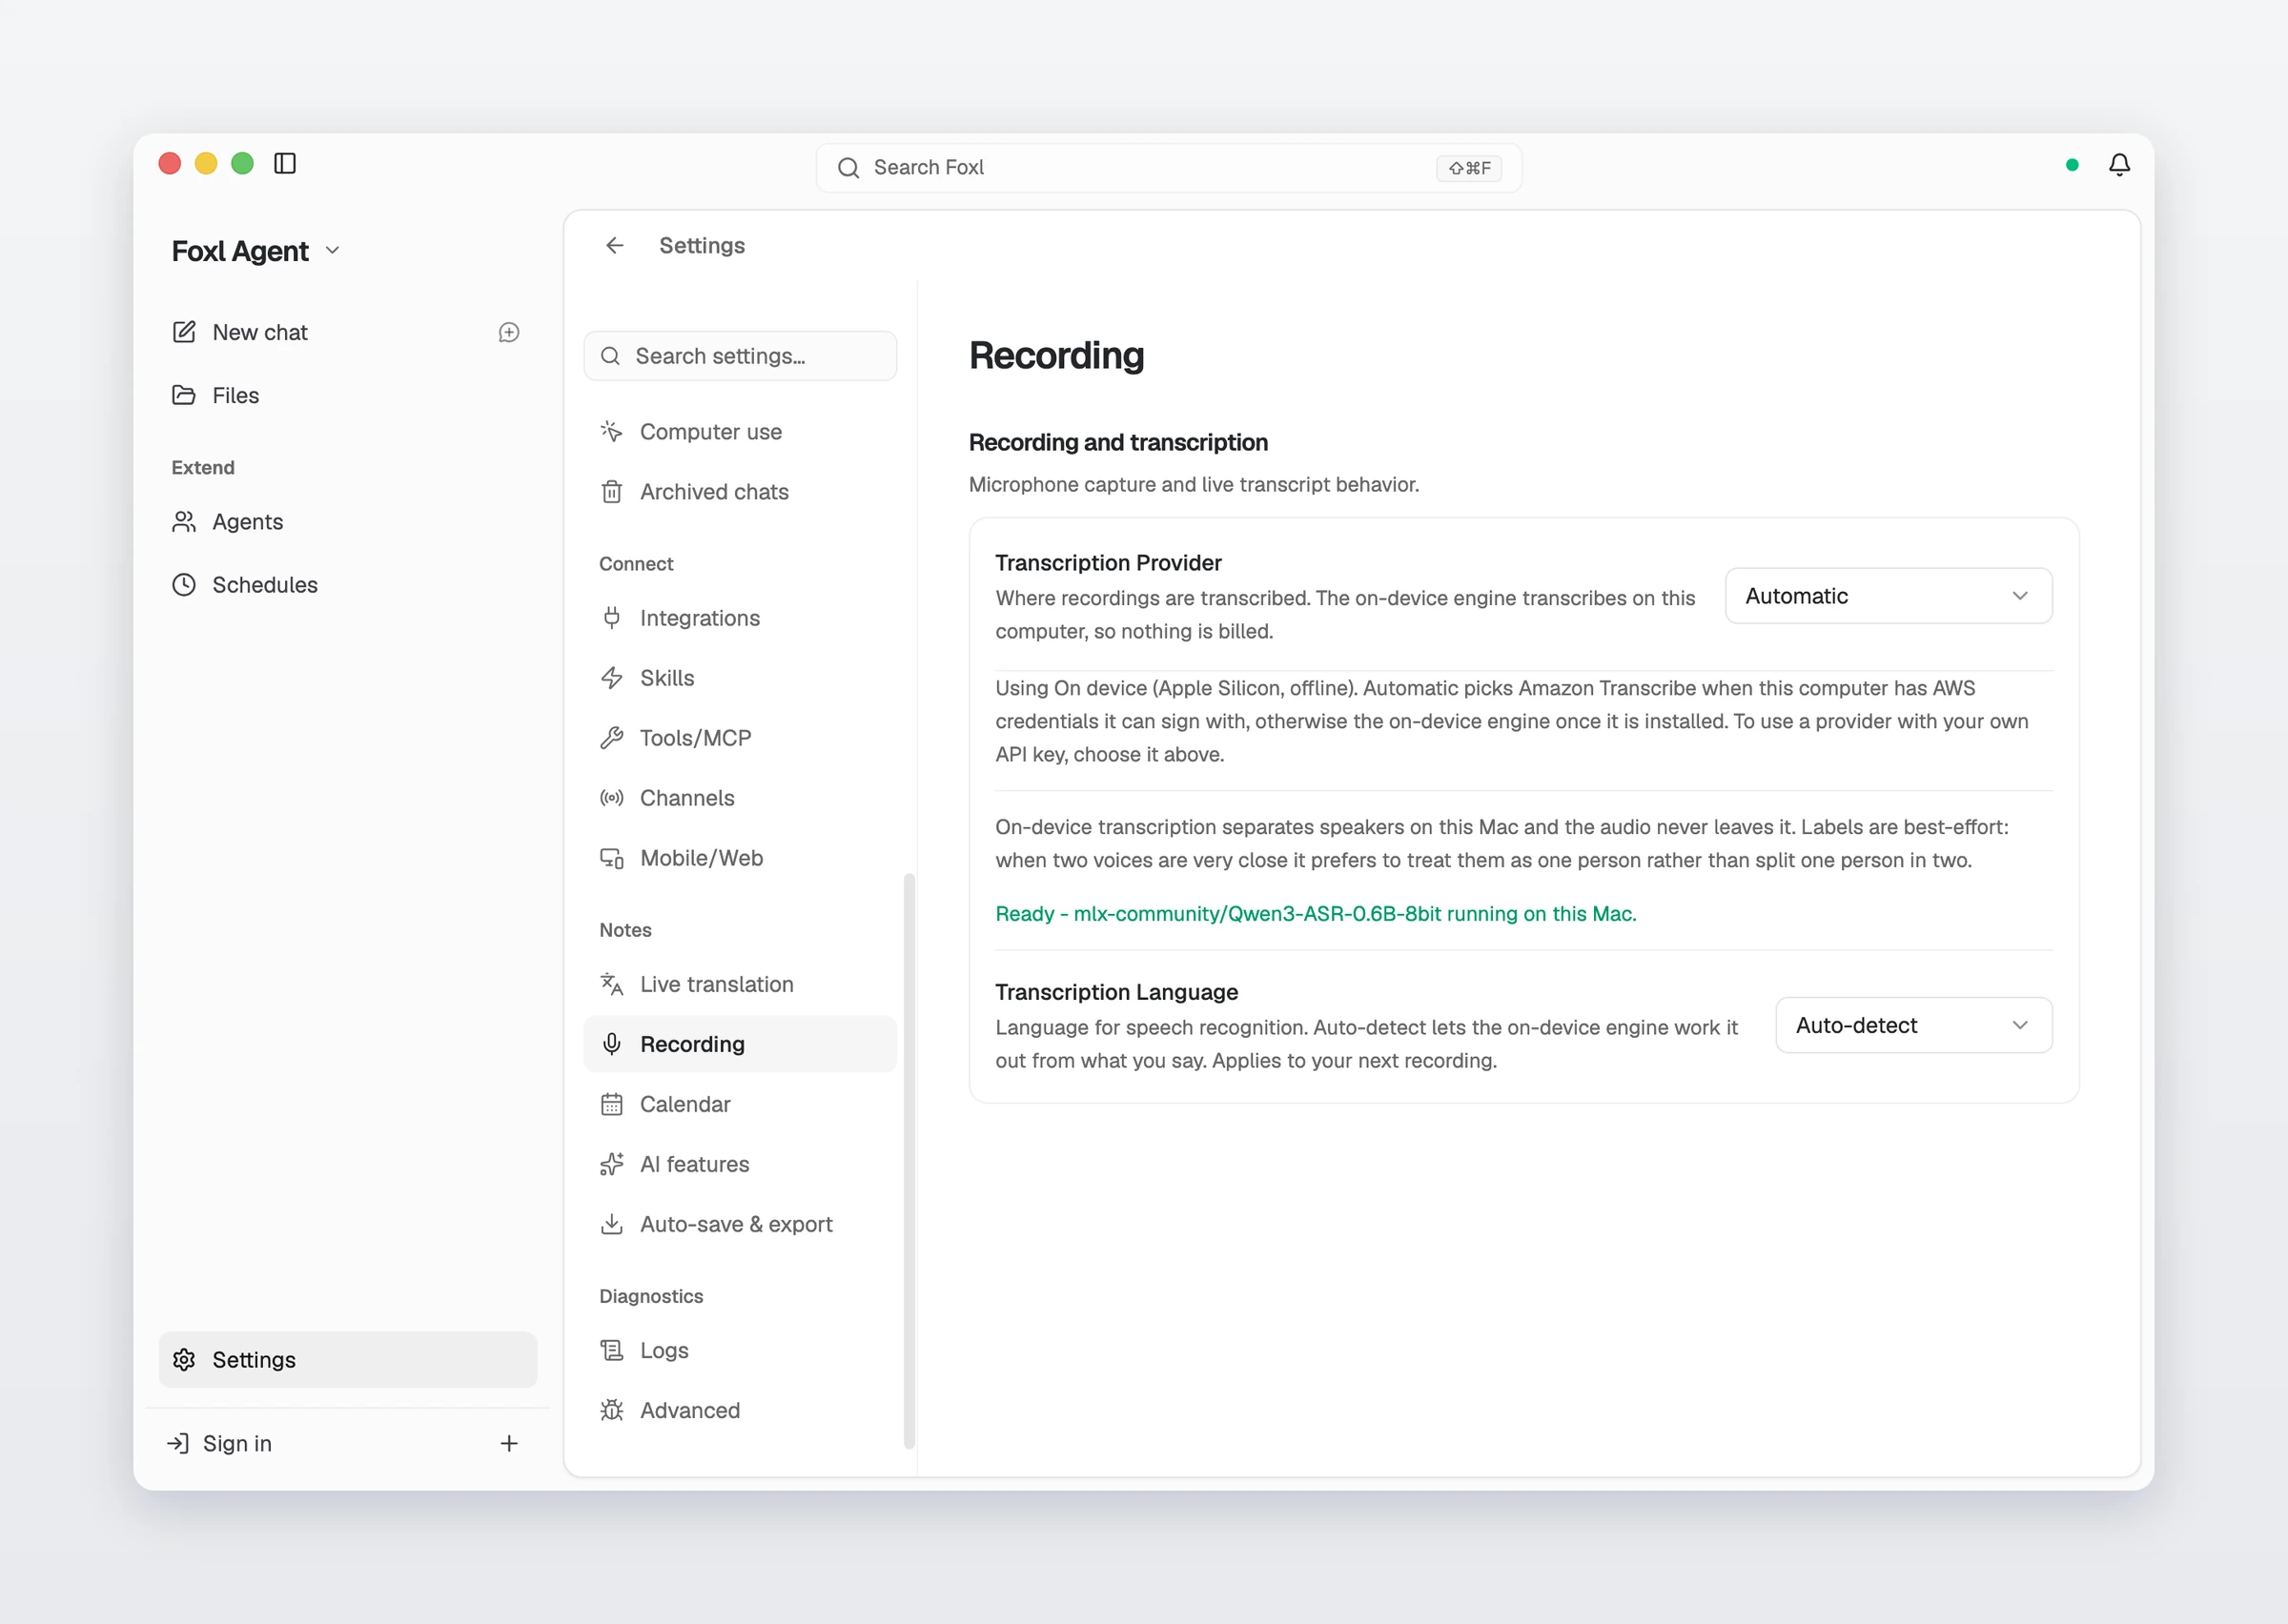
- Abra Configuração > Gravação. Se o Provedor de transcrição estiver em Automático, ele passa para o motor no dispositivo assim que o motor for instalado, a não ser que o computador tenha credenciais da AWS. Você também pode escolher No dispositivo por conta própria.
- Se o motor ainda não estiver instalado, escolha Instalar motor. É um download único de cerca de 1,3 GB, e a primeira tela do Notes oferece o mesmo botão.
Quando ele estiver pronto, a Configuração mostra o nome do modelo e diz que o áudio fica no computador. No Mac, o modelo é uma versão de 8 bits do Qwen3-ASR rodando na GPU; no Windows e no Linux, o mesmo modelo roda no llama.cpp.
Como transcrever uma reunião
No Notes, aperte Iniciar gravação quando a reunião começar. Para uma gravação que você já tem, use Importar gravação ou transcrição: o Notes aceita wav, mp3, m4a, mp4 e outros arquivos de áudio e vídeo, e começa a transcrever assim que o arquivo entra. A aba Transcrição lista cada fala com o falante e o momento em que ela começou.
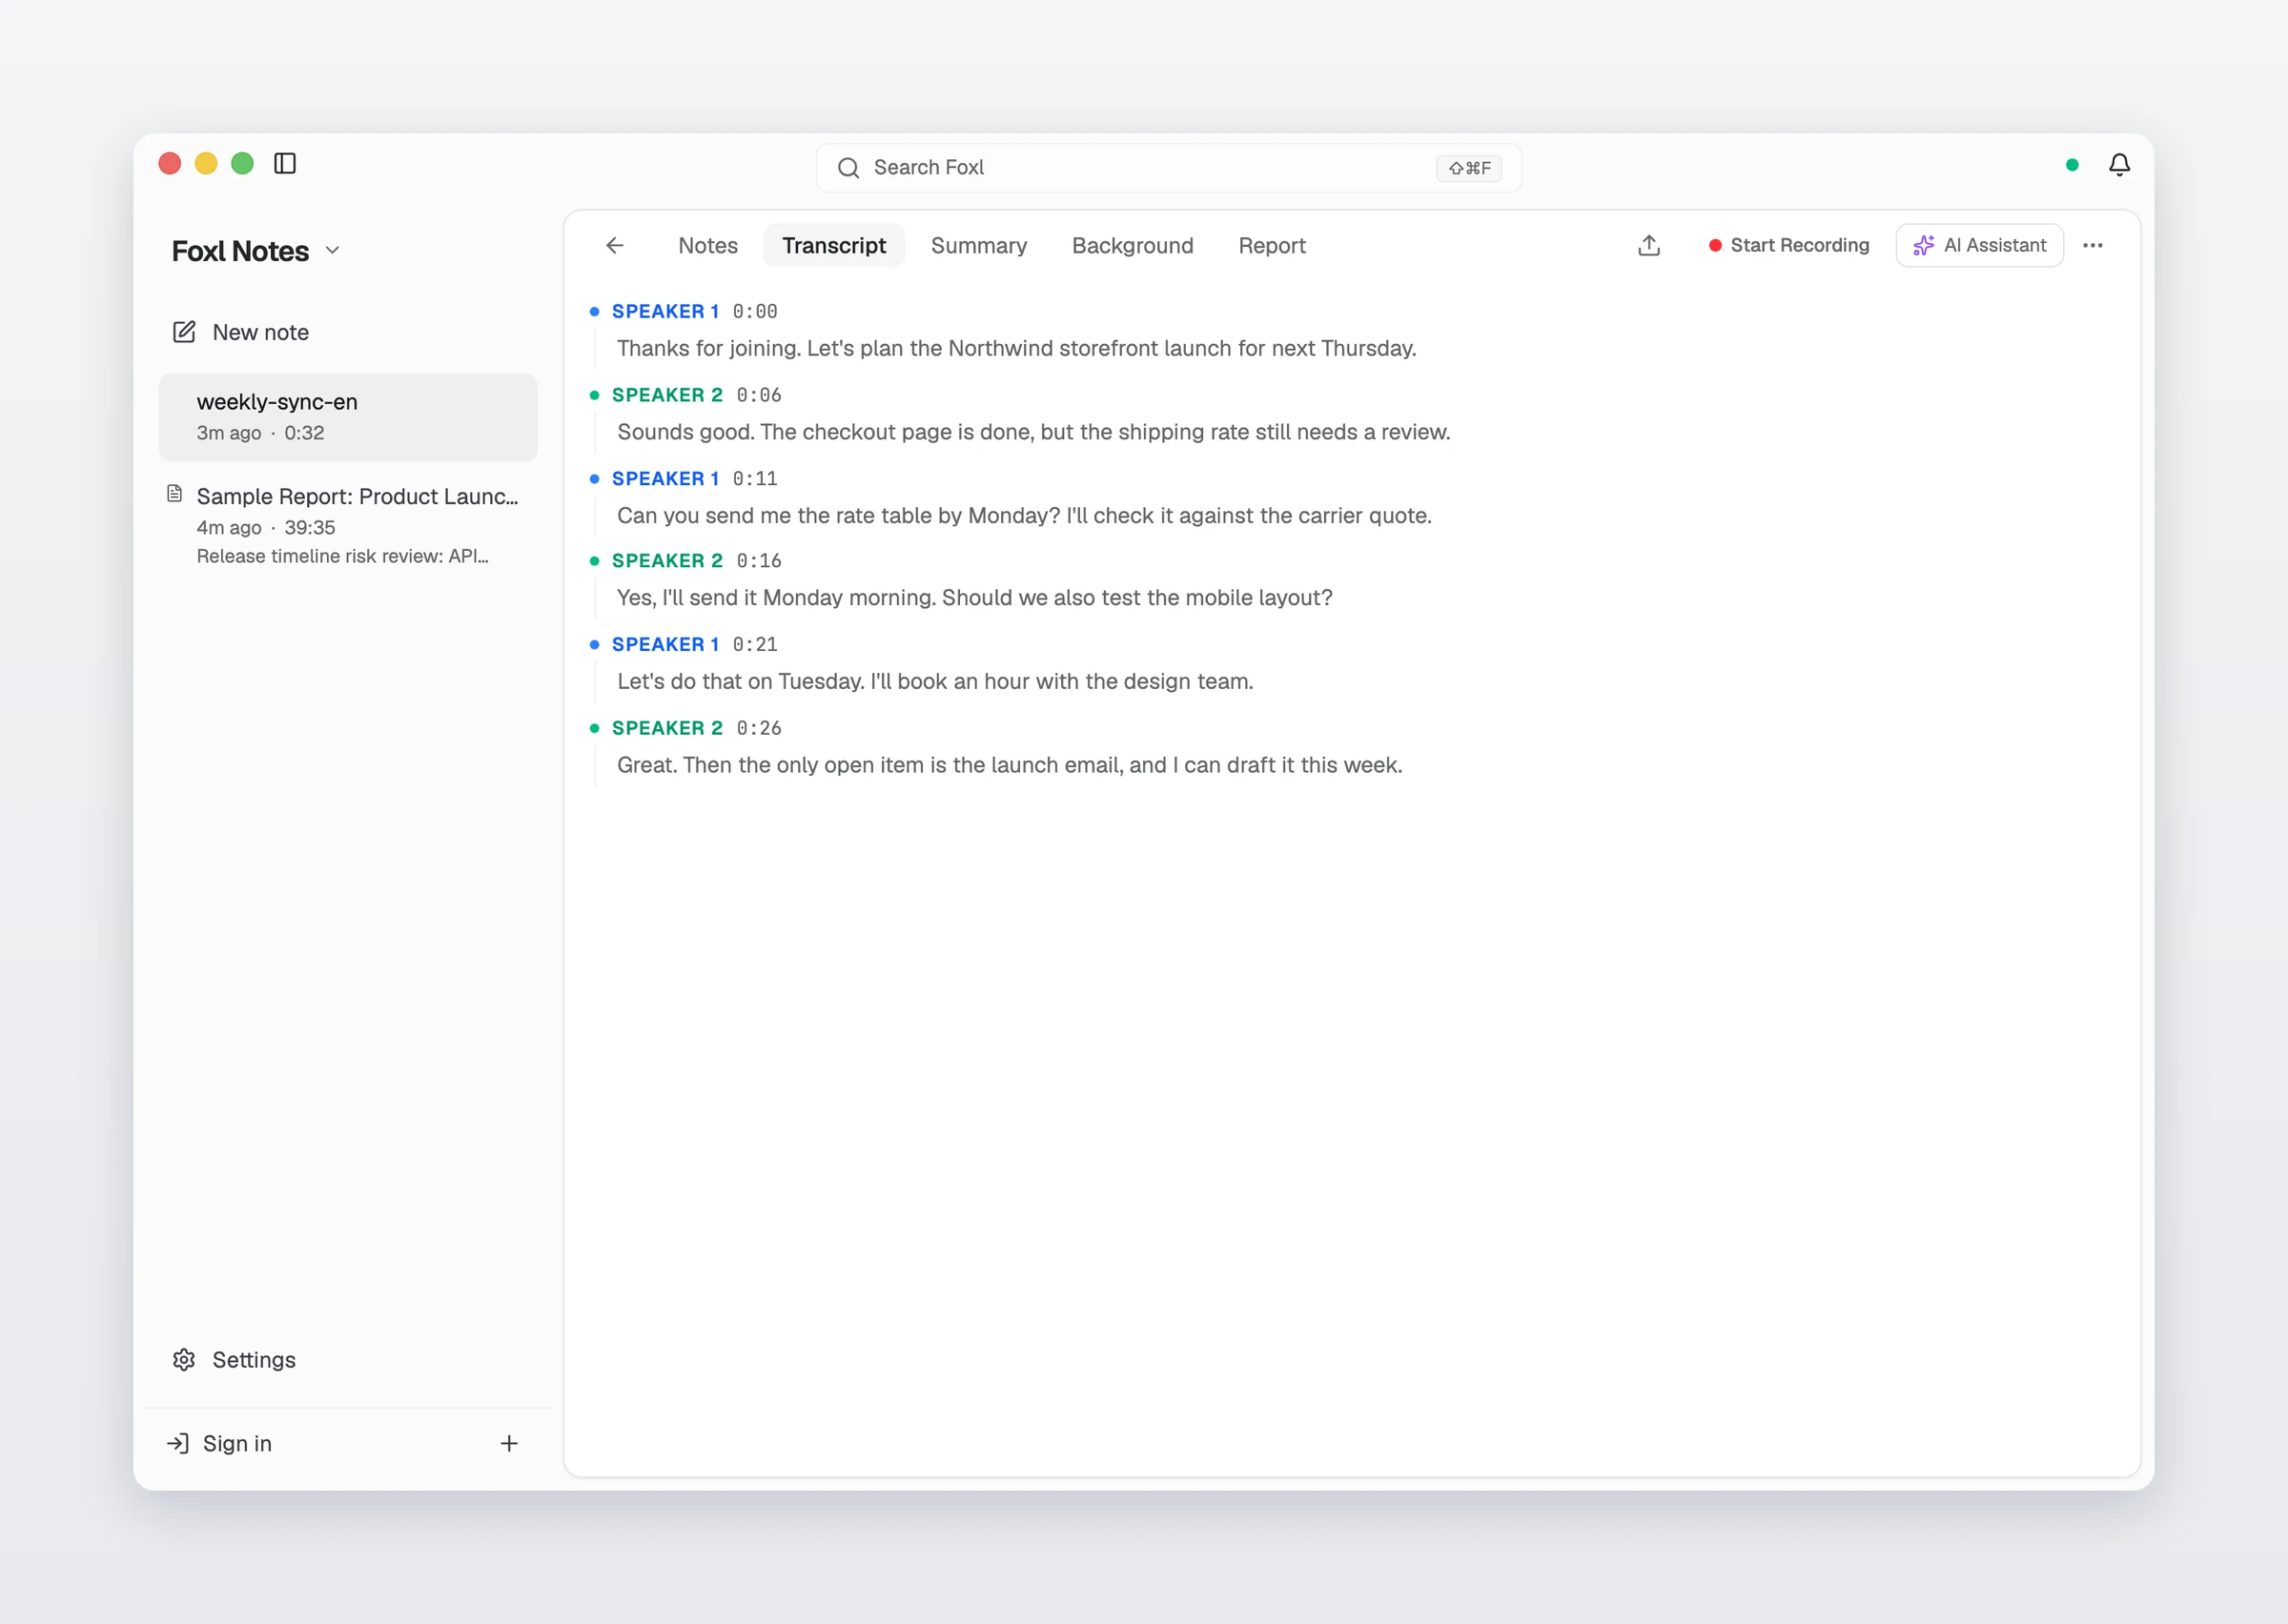
Os rótulos são números. Clique em um deles para dar um nome a esse falante.
Qual é a precisão dos rótulos?
No nosso próprio conjunto de avaliação de 10 conversas sintéticas, o motor colocou em média 99,09% do áudio no falante certo. Cada conversa tem duas ou três vozes sintéticas, escolhidas para não serem mais parecidas entre si do que pessoas reais, então a resposta certa é conhecida com exatidão. Isso faz do número um resultado de teste, não uma previsão para a sua sala de reunião. Em 14 arquivos de avaliação, quatro deles conversas reais gravadas, ele achou o número certo de falantes todas as vezes. Duas vozes em inglês do mesmo gênero, falando sem pausa entre as falas, saíram 93,3% certas. A reunião da captura acima, também com duas vozes sintéticas, acertou as seis falas.
Quando duas vozes são muito parecidas, o motor prefere tratá-las como uma pessoa só a dividir uma pessoa em duas. Em notas de reunião, uma linha atribuída à pessoa errada faz mais estrago do que uma linha sem dono claro. Topamos com isso ao fazer este guia: uma reunião entre uma voz sintética e a mesma voz com o tom mais grave voltou como um único falante.
Limitações
- Ele não sabe nomes. Você renomeia os falantes na transcrição.
- Não há motor no dispositivo para Macs Intel nem para Linux em arm64.
- Ele não escreve resumos. Para isso você precisa de um modelo, seja um que você conecte, seja o modelo de resumo no dispositivo do Foxl, que é um download separado.
Para onde vai o áudio
Para a transcrição, ele fica no computador. Com o motor no dispositivo selecionado, a Configuração diz que a transcrição acontece neste computador e que nada é cobrado, e a separação de falantes roda no mesmo processo local. Como nada é enviado, também funciona sem conexão com a internet. O que você fizer depois, como pedir um resumo a um modelo na nuvem, passa pelo provedor que você escolher para isso.
Referências e leituras complementares
- Documentação do Foxl: gravaçãoDocumentação
- Documentação do Foxl: créditos e privacidade no NotesDocumentação
- pyannote segmentation-3.0Referência
- Modelos de segmentação de falantes do sherpa-onnxReferência
- 3D-Speaker (CAM++)Referência
- Qwen3-ASR 0.6B, build MLX de 8 bitsReferência
- Baixar o FoxlReferência