Lo que aprendimos construyendo una fábrica de software con IA
El equipo de Foxl publica decenas de versiones al mes desde una fábrica de software con IA en la que trabajan a la vez entre 15 y 20 agentes de programación. Escribir el código fue lo fácil; saber si era correcto, mucho más difícil. Esto es lo que aprendimos construyendo las comprobaciones.
En esta página
El equipo de Foxl publica decenas de versiones al mes. En octubre fueron 66: 22 estables y 44 beta. Cada versión lleva la app de escritorio para Windows, macOS y Linux, y cada versión estable lleva además las apps de iOS y Android y la app web. Cada vez hay que comprobar que todo eso funciona.
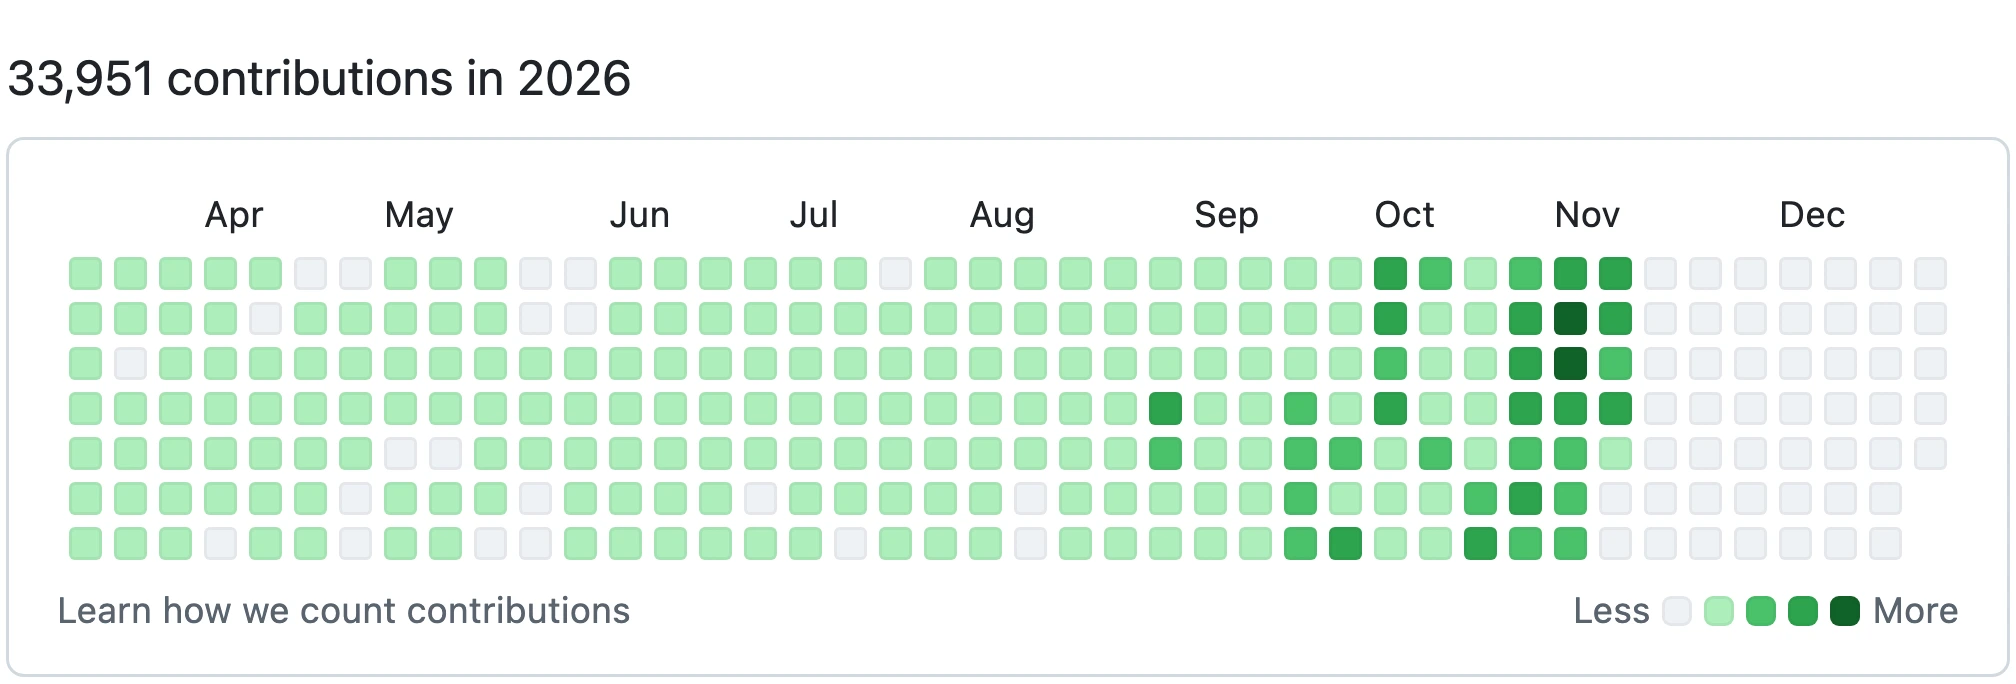
Ese mismo mes se abrieron 2140 pull requests en nuestro repositorio y se fusionaron 2040, casi 70 abiertos al día. La mayor parte de ese código no lo escribieron personas, sino agentes de programación: entre 15 y 20 sesiones de Claude Code en marcha a la vez en un Mac, cada una en su propia rama. El gráfico de contribuciones de la cuenta de GitHub con la que hacen commit esas sesiones muestra el cambio de un vistazo. En cada uno de los dos años anteriores sumó unos pocos cientos de contribuciones. Este año supera las 30.000.
Al desarrollo en el que los agentes planifican el trabajo, escriben el código, lo prueban y lo revisan se le ha empezado a llamar fábrica de software con IA. Las personas deciden qué construir y tienen la última palabra sobre qué sale. La nuestra funciona así. Pero cuando en marzo dejamos el código en manos de los agentes, lo difícil resultó no ser escribirlo. Lo difícil era saber si el código que escribían los agentes era de verdad correcto, y si aguantaba en las cinco plataformas.
Este artículo recoge lo que aprendimos construyendo las comprobaciones para eso. En pocas palabras: todas las reglas que solo dejamos por escrito para los agentes se rompieron. La mayoría duró unos pocos días. Lo que aguantó fueron comprobaciones colocadas justo en el camino por el que había entrado un error, y el siguiente error casi siempre entraba por un camino que aún no tenía ninguna.
De una sesión a veinte
Durante los primeros cuatro meses teníamos una sesión abierta todo el día, y una persona leía cada diff en cuanto aparecía. Casi todo iba directo a main; el repositorio tiene un solo pull request de todo junio. El límite era la atención humana. Una sesión era más o menos todo lo que alguien podía seguir como es debido.
En julio apuntamos Foxl Code, nuestro agente de programación en la nube, al propio repositorio de Foxl. Cada tarea tenía su propia VM en la nube, y el 22 de julio esa configuración sacó cinco versiones a producción en un día. Esas VM no llevan macOS, eso sí, así que todo lo que necesitaba Xcode o el simulador de iPhone seguía teniendo que volver al Mac.
En agosto cambiamos la forma de trabajar: un git worktree por sesión y un pull request por cambio. Las sesiones dejaron de pisarse el trabajo, así que varias podían trabajar a la vez, y los pull requests pasaron de 598 en agosto a 946 en septiembre y 2140 en octubre.
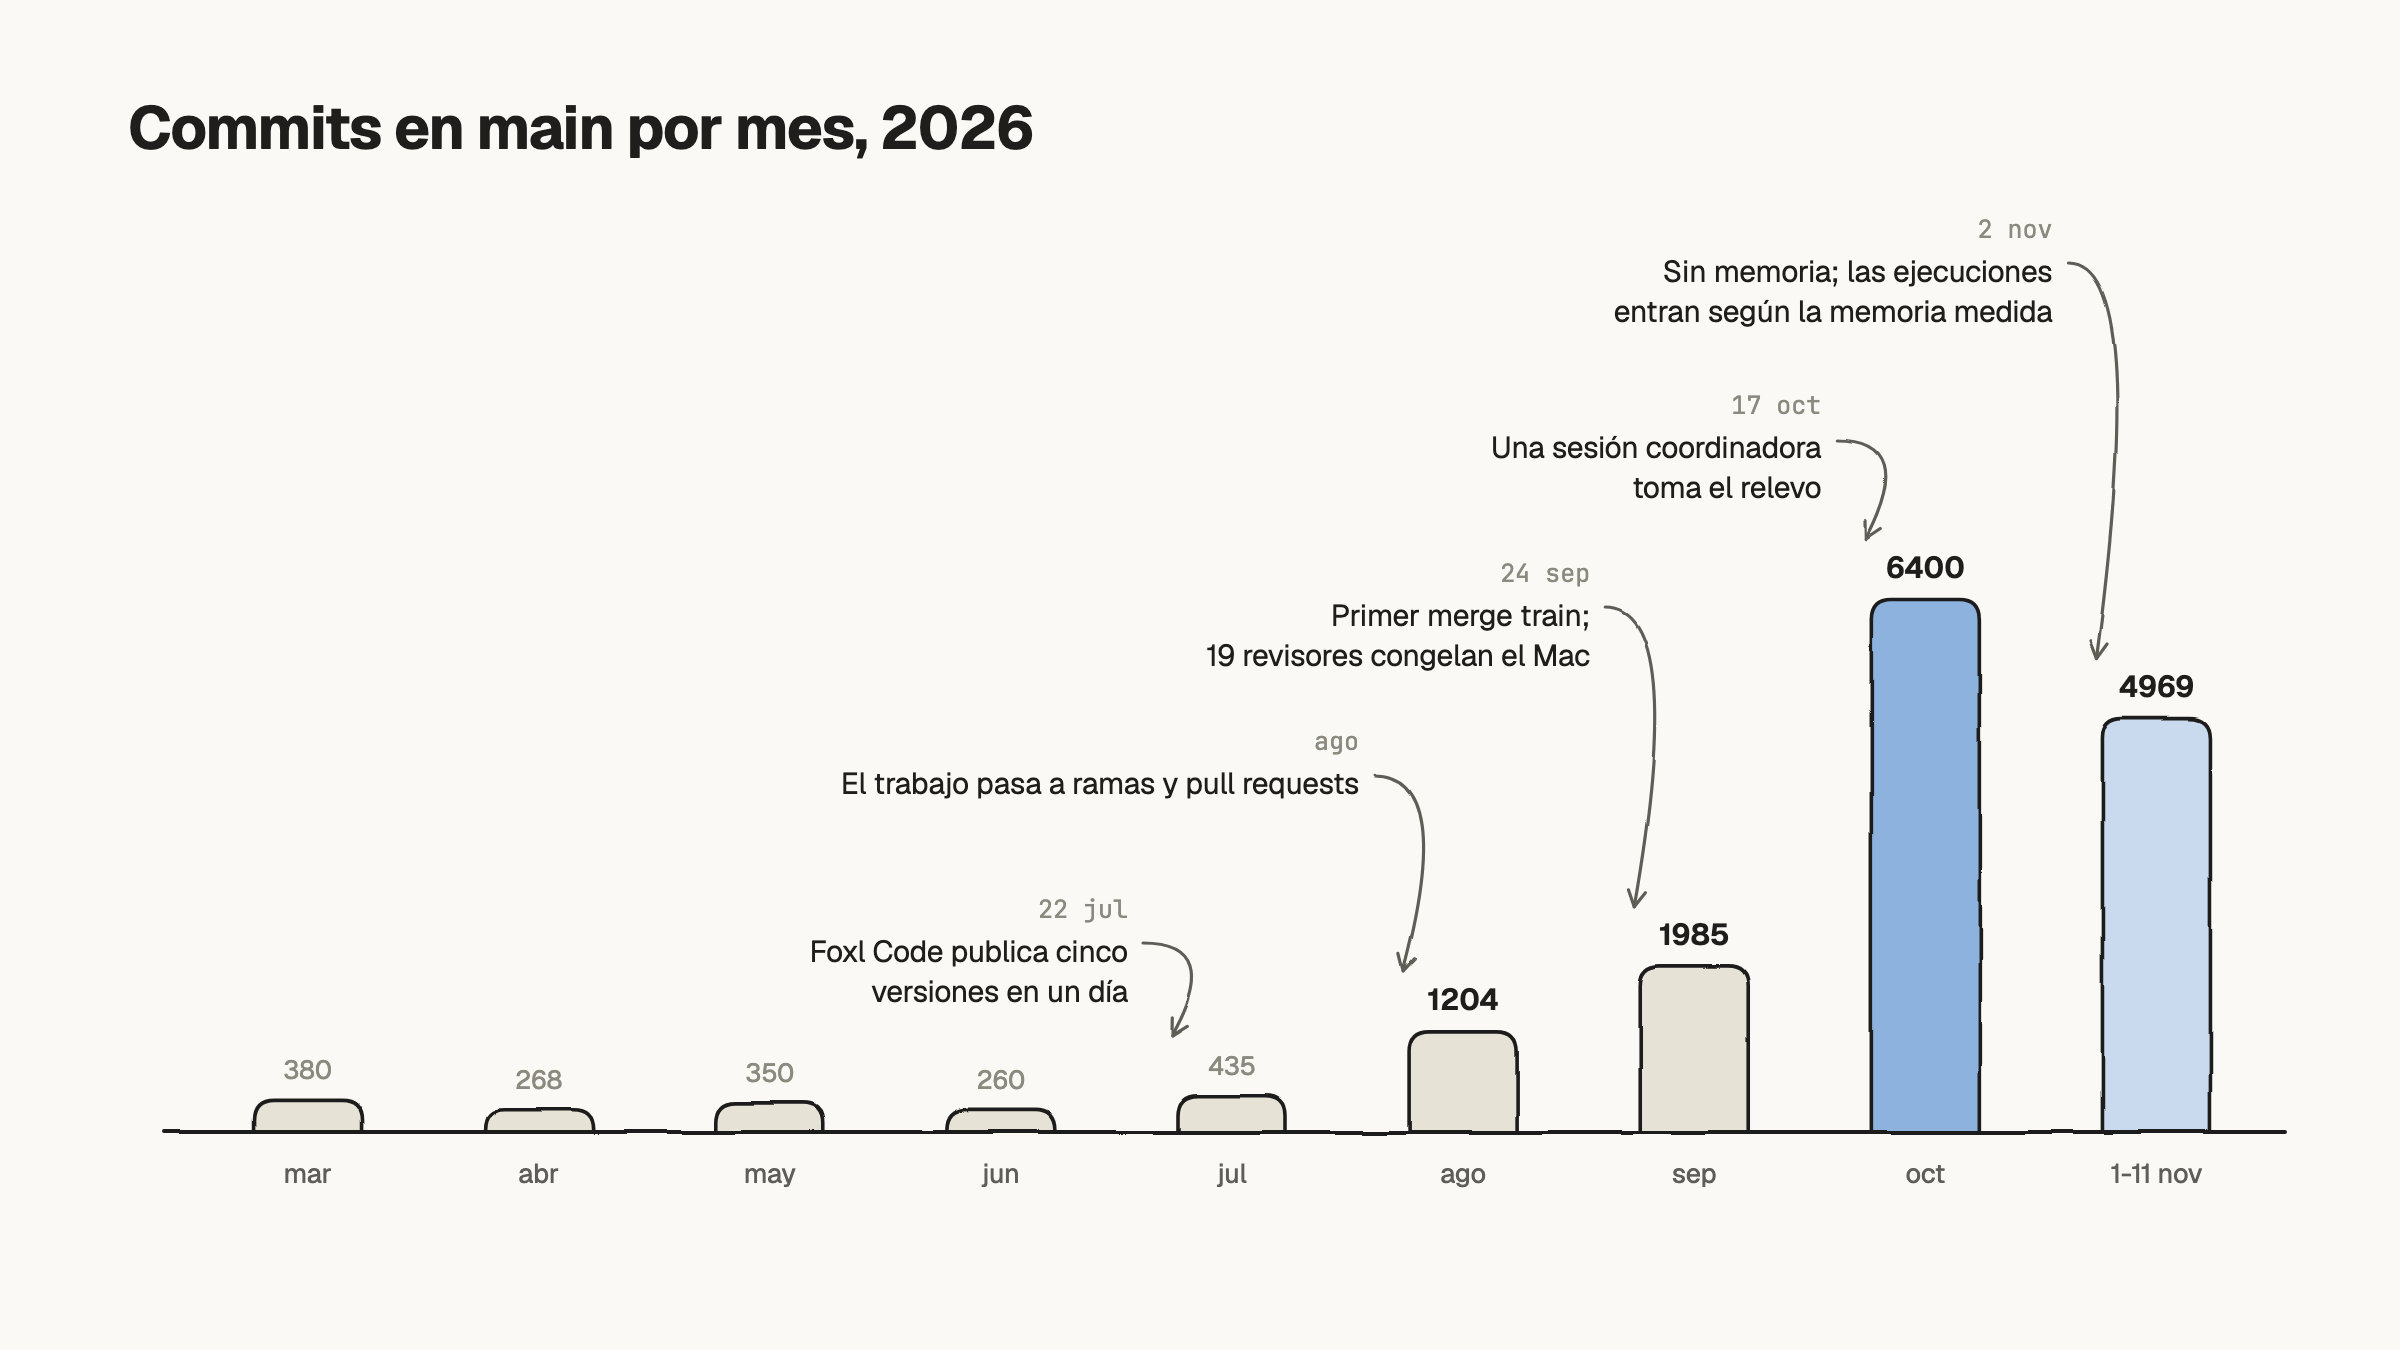
A medida que crecían las cifras, aparecieron problemas nuevos. Las sesiones editaban los mismos archivos a la vez, y al Mac le faltaba memoria. Sobre todo, el primer merge train, el 24 de septiembre, demostró que una CI en verde no significa que un pull request sea correcto. Volveremos a eso más abajo.
Dónde podemos comprobar decide dónde trabajamos
Comprobar cinco plataformas empieza por tener máquinas que puedan ejecutarlas. Usamos tres tipos, y cada uno puede comprobar cosas distintas.
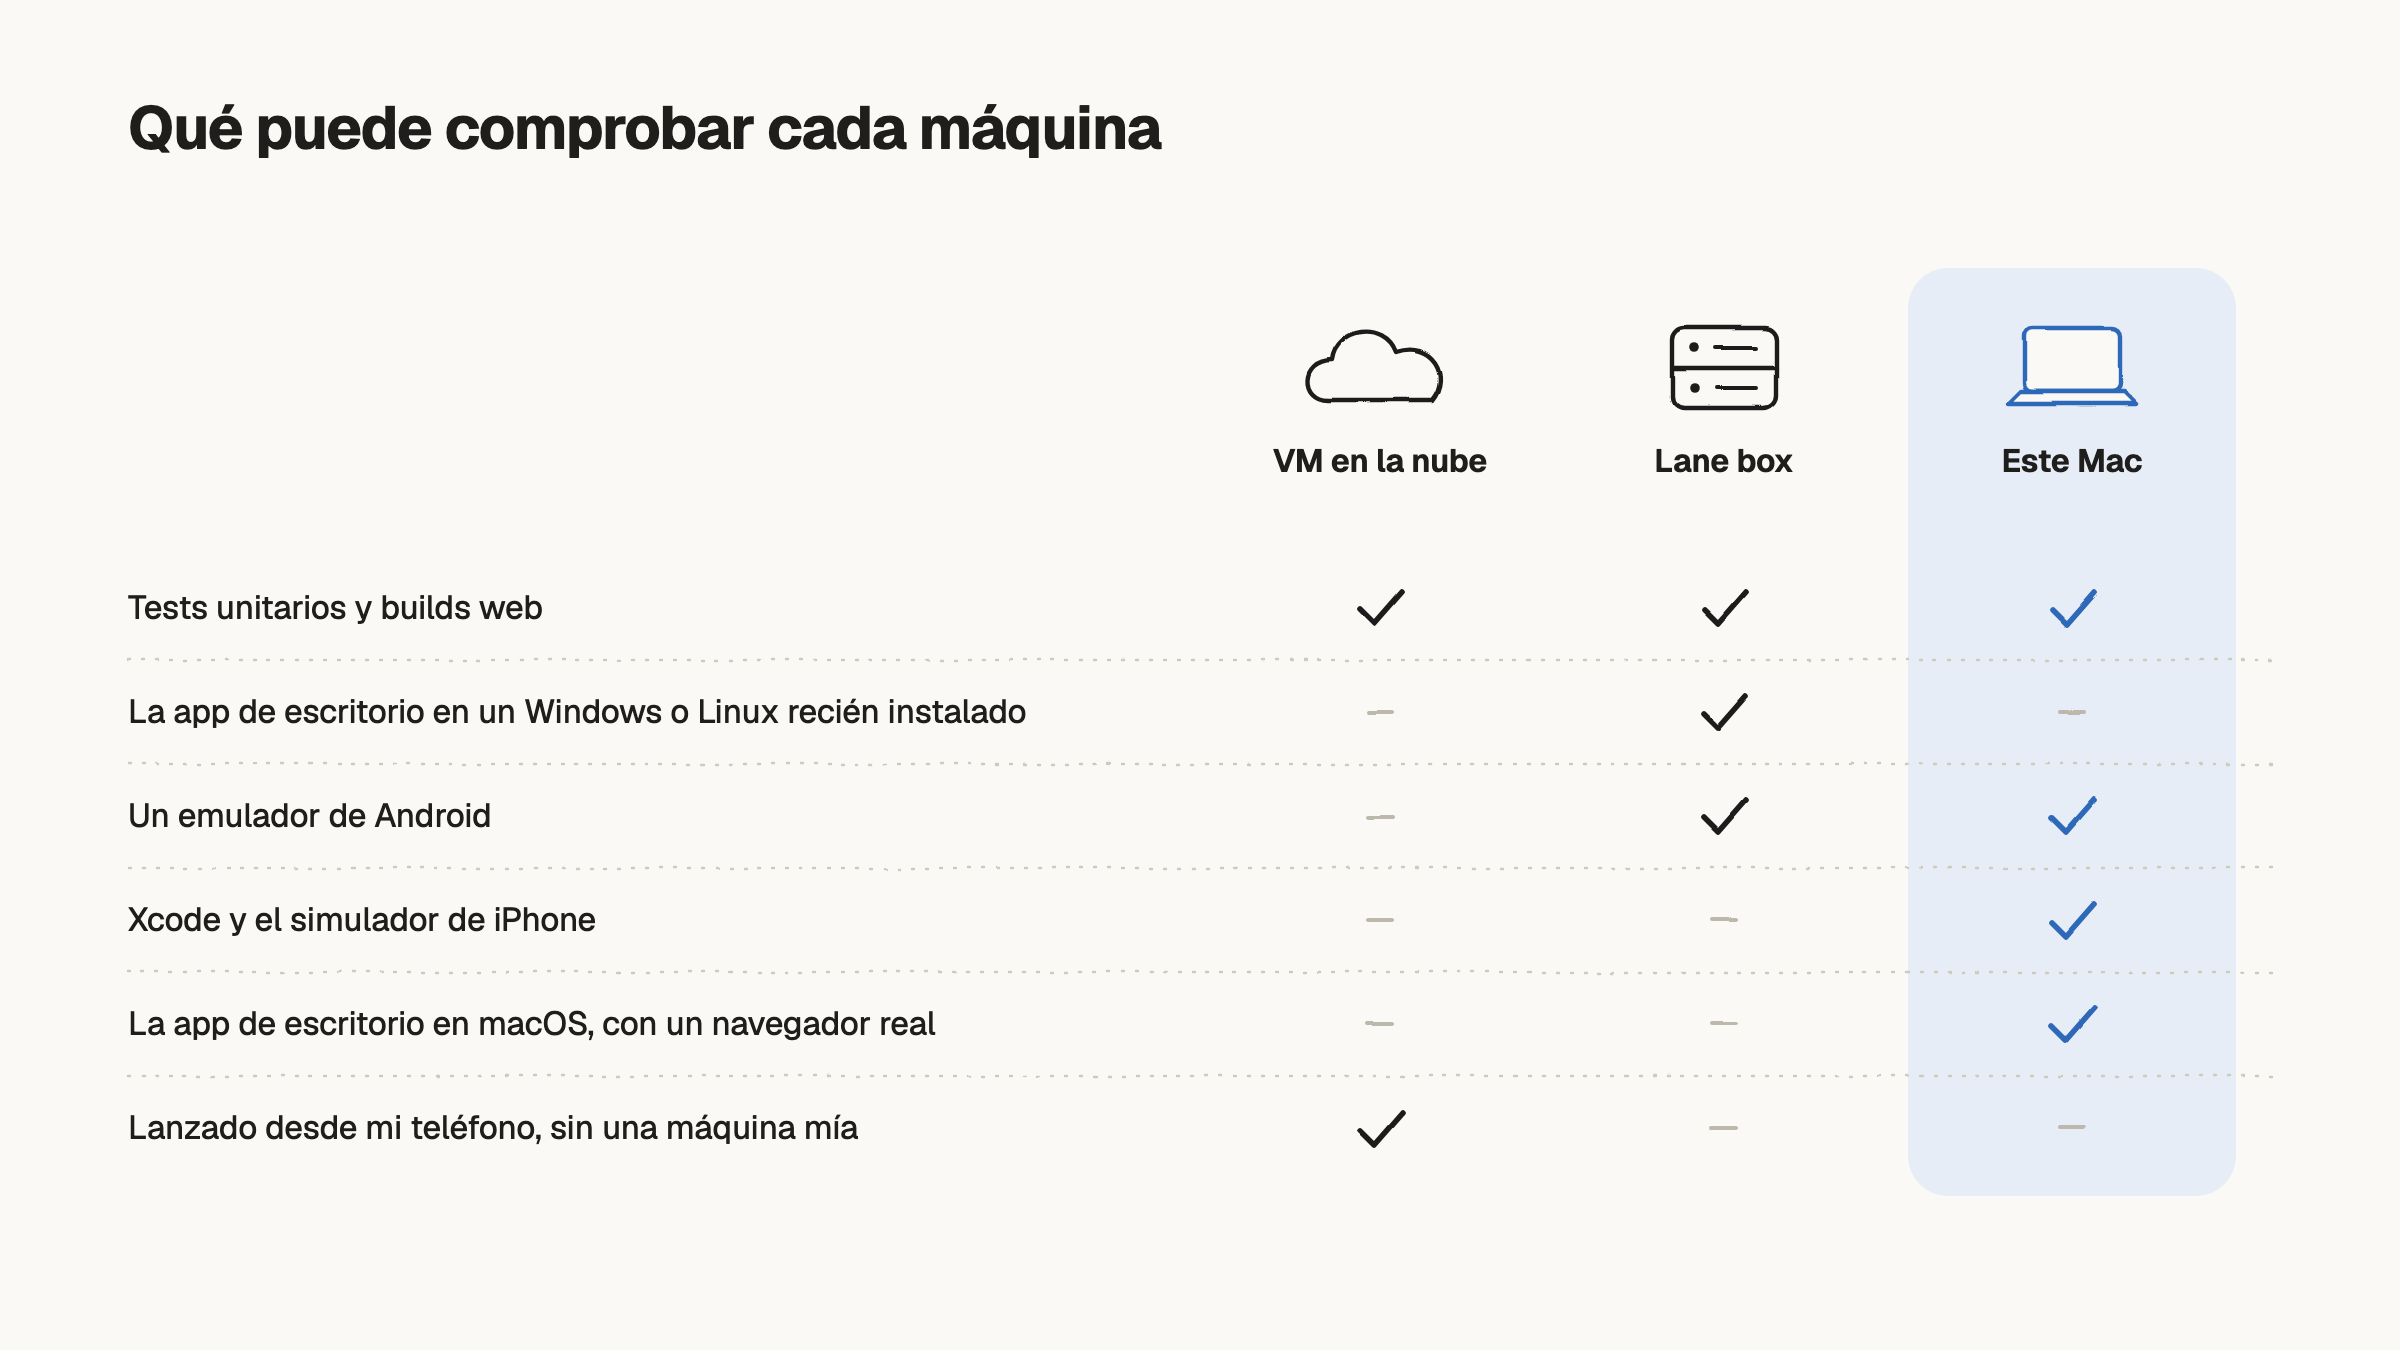
Las VM en la nube van bien para trabajo aislado en Linux, y se pueden lanzar directamente desde el teléfono. Cuando una sesión necesita la app de escritorio en un Windows o Linux recién instalado, o un emulador de Android, recibe una instancia EC2 desechable que llamamos lane box. Y solo el Mac puede comprobar todo lo demás: Xcode, el simulador de iPhone, un Chrome real y la app de escritorio en macOS.
Así que la mayoría de las sesiones acabaron en un solo Mac. Es además un ordenador que usamos a diario, lo que significa que todas las sesiones comparten la memoria de una sola máquina y trabajan justo al lado de datos reales.
Lanzar agentes es la parte resuelta
Hay muchas herramientas para ejecutar muchos agentes a la vez. Todas las que miramos facilitan las ejecuciones en paralelo, y algunas permiten que los agentes hablen entre sí. En lo que se diferencian es en dónde corren los agentes y en cuánto de la comprobación de sus resultados asumen.
Claude Code y Codex
Estos dos son los agentes en sí. Claude Code ejecuta sesiones en segundo plano que siguen en marcha cuando se cierra el terminal, cada una en su propio worktree (claude --bg --worktree), y las sesiones pueden enviarse mensajes entre sí o lanzar subagentes. También hay sesiones en la nube, que se inician desde la web o el móvil. Codex viene como CLI, app de escritorio y extensiones de IDE, y Codex Web ejecuta tareas en contenedores Linux en la nube de OpenAI.
Orca
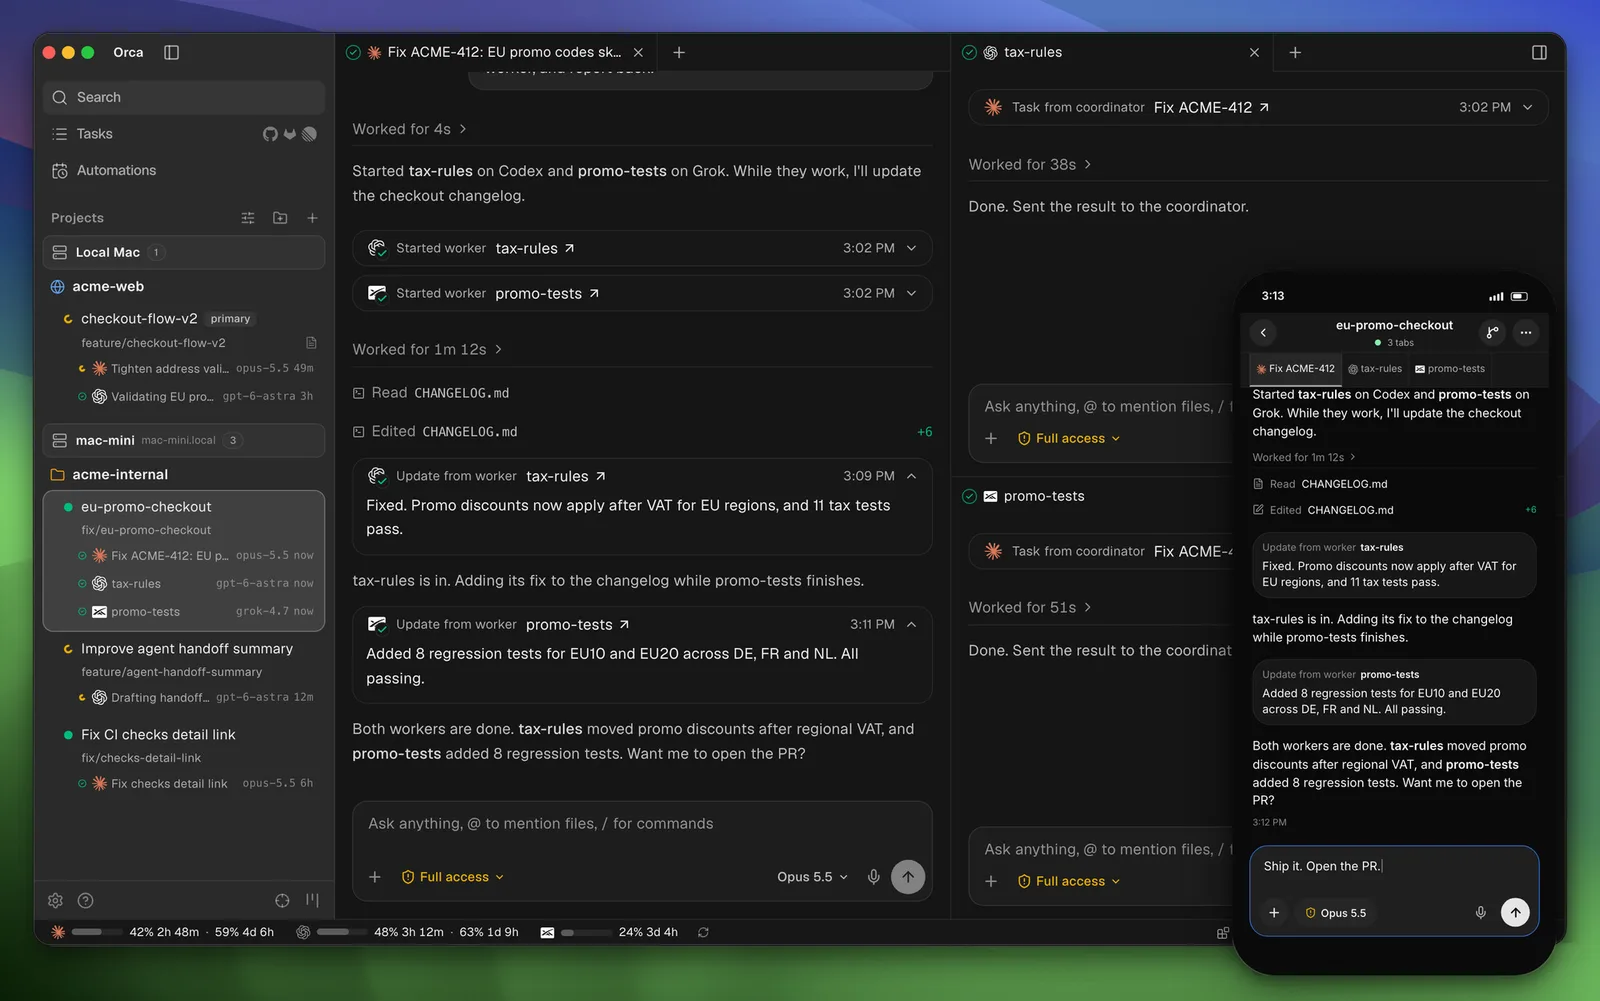
Orca es una app de escritorio para macOS, Windows y Linux. Ejecuta agentes de CLI como Claude Code o Codex en paralelo, cada uno en su propio worktree, y cuando le das una tarea grande, un agente coordinador reparte el trabajo entre workers y recoge sus resultados, que es la escena de la captura de arriba. Los agentes también pueden correr en un host SSH o en una VM en la nube por worktree, y los checks que fallan y los comentarios de revisión vuelven al agente para que los arregle.
herdr
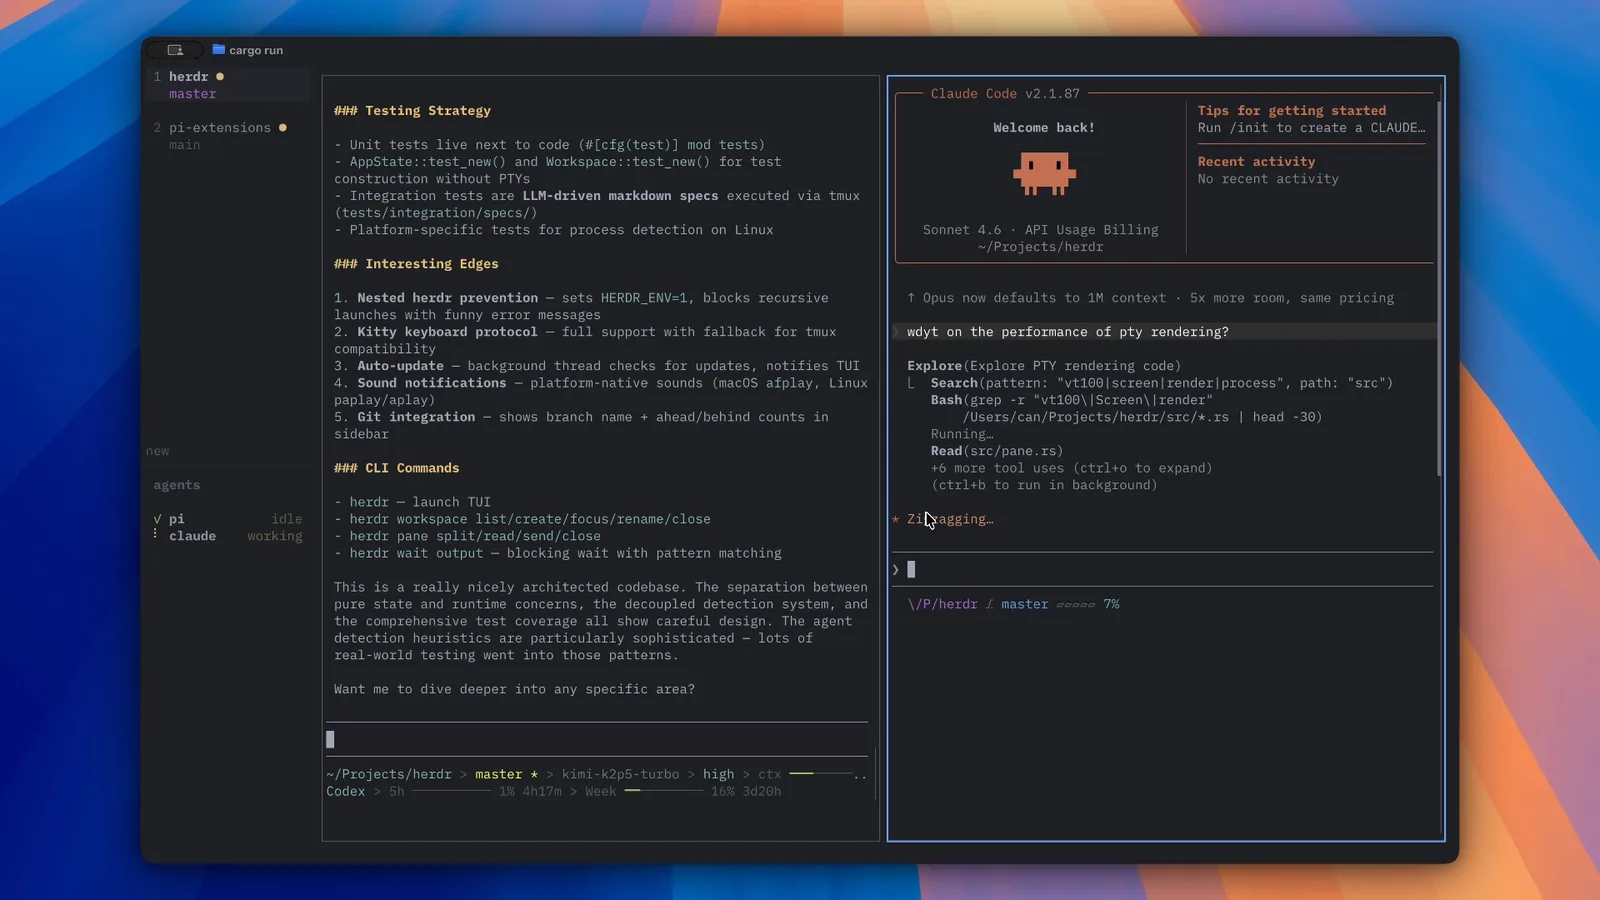
herdr es un runtime de terminal en un único binario de Rust. Se queda con los terminales en lugar de envolver a los agentes, así que funciona igual con Claude Code, Codex u OpenCode. Los terminales siguen en marcha en segundo plano cuando se cae una conexión SSH, cada panel muestra si su agente está working, blocked o idle, y los agentes pueden mandarse prompts entre sí mediante su CLI y su API de sockets.
Kiro Crew
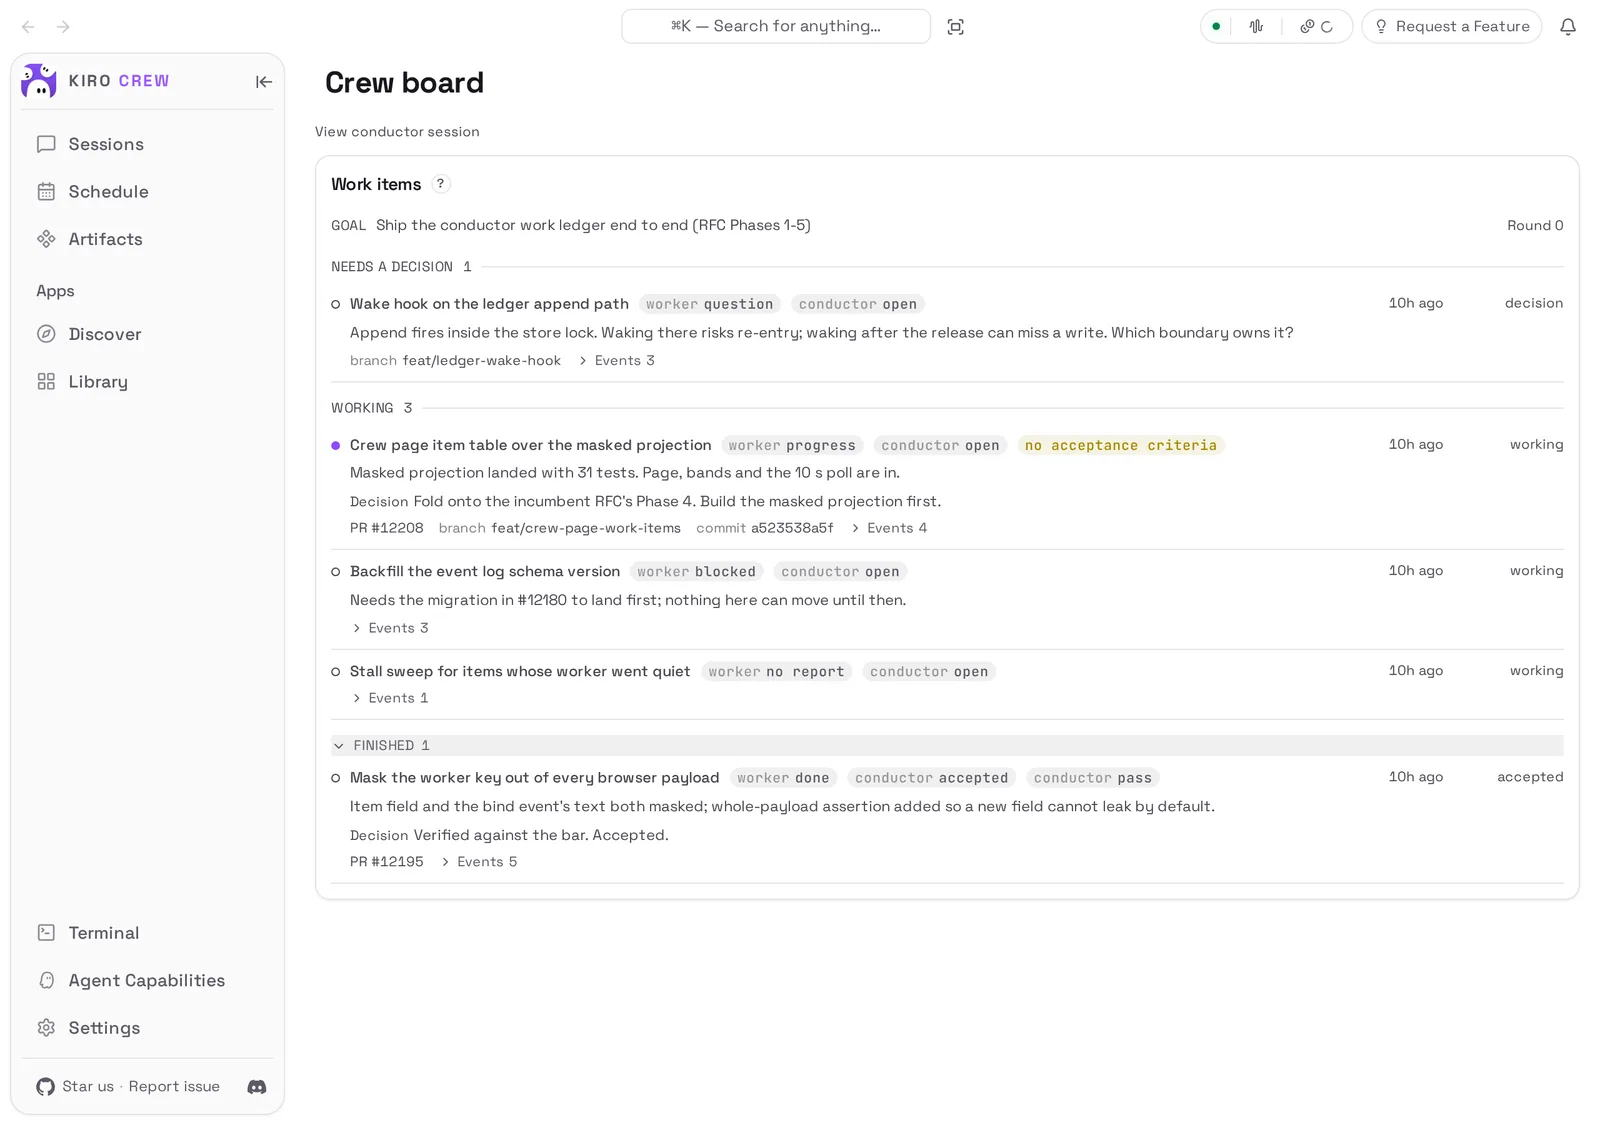
Kiro Crew es un espacio de trabajo que corre en tu propio hardware, un Mac, un contenedor o una máquina remota, y sigue trabajando entre conversaciones. Las sesiones, la memoria y los checkpoints de las tareas sobreviven a los reinicios, y las correcciones se acumulan como lecciones que cambian lo que hace después. Su crew board, arriba, muestra cada elemento que repartió el conductor junto a lo que informó el worker y si el conductor aceptó el resultado según el listón.
Foxl Code
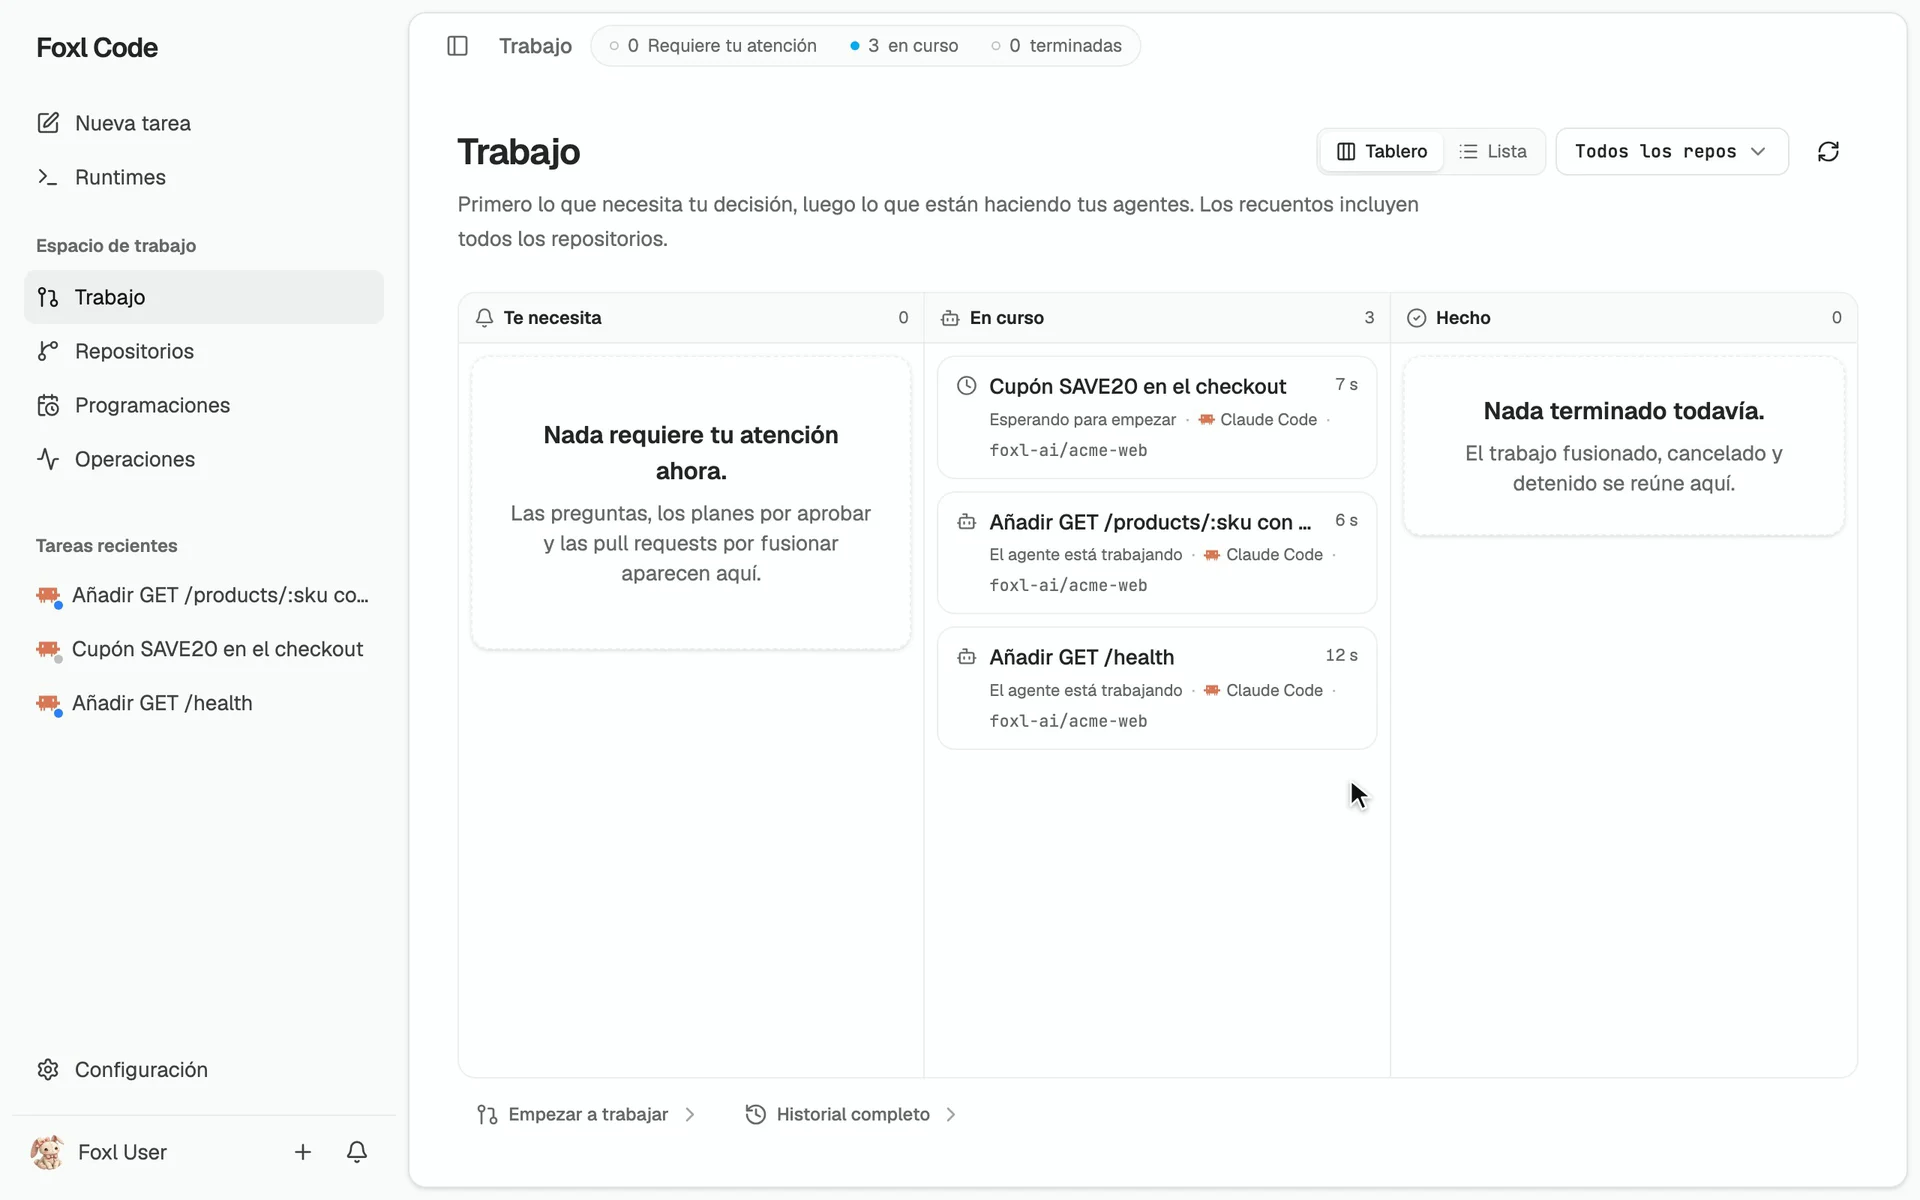
Foxl Code es el producto en la nube que mencionamos antes, en beta privada para cuentas invitadas. Describes una tarea desde el navegador o el teléfono, y un agente como Claude Code trabaja en ella en su propia VM. Una petición más grande se divide en subtareas independientes que arrancan a la vez, un pull request cada una; el tablero de arriba es una petición segundos después de dividirse en tres. El revisor lee el MERGE-REVIEW.md del repositorio desde la rama por defecto, nunca desde el pull request, así que un cambio no puede reescribir el listón con el que se le califica. Aun así, cada pull request se comprueba por separado: para probar varios fusionados entre sí, hay que pedir un merge train en el chat.
Una al lado de otra:
| Herramienta | Dónde corren los agentes | Puntos fuertes | Límites |
|---|---|---|---|
| Claude Code | Tu máquina, o una sesión en la nube iniciada desde la web o el móvil | Sesiones en segundo plano en sus propios worktrees que se listan y se envían mensajes; subagentes | Sus mensajes solo llegan a sesiones de Claude Code |
| Codex | Tu máquina, o la nube de OpenAI | Un mismo agente en una CLI, una app de escritorio, IDE y la nube | Las tareas en la nube corren en un contenedor Linux, así que el trabajo con Xcode se queda en local |
| Orca | Tu máquina, un host SSH o una VM en la nube por worktree | Cualquier agente de CLI; un coordinador que reparte una tarea entre workers; app de teléfono; los checks fallidos vuelven al agente | Nada en su descripción prueba varios pull requests fusionados juntos |
| herdr | Tu máquina y hosts SSH | Va debajo de cualquier agente: terminales que siguen al desconectarte, working, blocked o idle por panel, agentes que se mandan prompts | Se ocupa de los terminales, no del trabajo: no añade ningún paso propio de revisión ni de fusión |
| Kiro Crew | Tu Mac, un contenedor o una máquina remota | Sesiones, memoria y checkpoints que sobreviven a los reinicios; lecciones a partir de correcciones; un conductor que acepta trabajo según un listón | Aún no hay canales entre workers |
| Foxl Code | Una VM por tarea, en la nube de Foxl | Se empieza desde el teléfono; subtareas en paralelo, un pull request cada una; un revisor atado al listón de fusión del repositorio | Beta privada; sin macOS; los pull requests solo se prueban juntos en un merge train que pidas |
Construimos nuestra fábrica sobre las propias sesiones de Claude Code. Nació de una sola sesión de Claude Code, y las sesiones de este Mac ya podían listarse y enviarse mensajes, justo al lado de Xcode y de los simuladores.
Hay dos cosas que no cambian, sea cual sea la herramienta que ejecute los agentes. Los agentes de una misma máquina tienen que compartir su memoria, y alguien tiene que decidir si lo que hicieron está bien. El resto de este artículo trata de esas dos cosas.
Veinte sesiones y la memoria de un solo Mac
La tarde del 17 de octubre había diecinueve sesiones abiertas. Un build web ocupa unos 3,5 GB de memoria, y en diez minutos cuatro sesiones pidieron uno. Dos ejecutaron comprobaciones de TypeScript, y una arrancó un simulador de iPhone sin preguntar. Ocho sesiones tenían cambios abiertos en el mismo archivo CSS. Esa tarde les dijimos a las sesiones que usaran menos memoria, que esperaran su turno y que preguntaran antes de usarla.
Ese mismo día, una sesión se convirtió en el coordinador. Todas las demás leen al arrancar un archivo compartido con quién se encarga de qué archivos, le mandan al coordinador una línea con su tarea y los archivos que esperan tocar, y reciben un ámbito de vuelta. Una sesión que necesita un archivo de otra le manda a esa sesión el cambio para que lo aplique. Antes de cualquier cosa que consuma mucha memoria, como un build, una suite de tests o un simulador, manda HEAVY? con su estimación de memoria y minutos, y espera el GO. El coordinador lee la presión de memoria del Mac antes de cada permiso.
Abajo está la cola en la que esperó el primer build de este artículo. Un benchmark de modelo y varias ejecuciones del simulador ya estaban en la fila, y el build no arrancó hasta después de esperar 50 minutos.
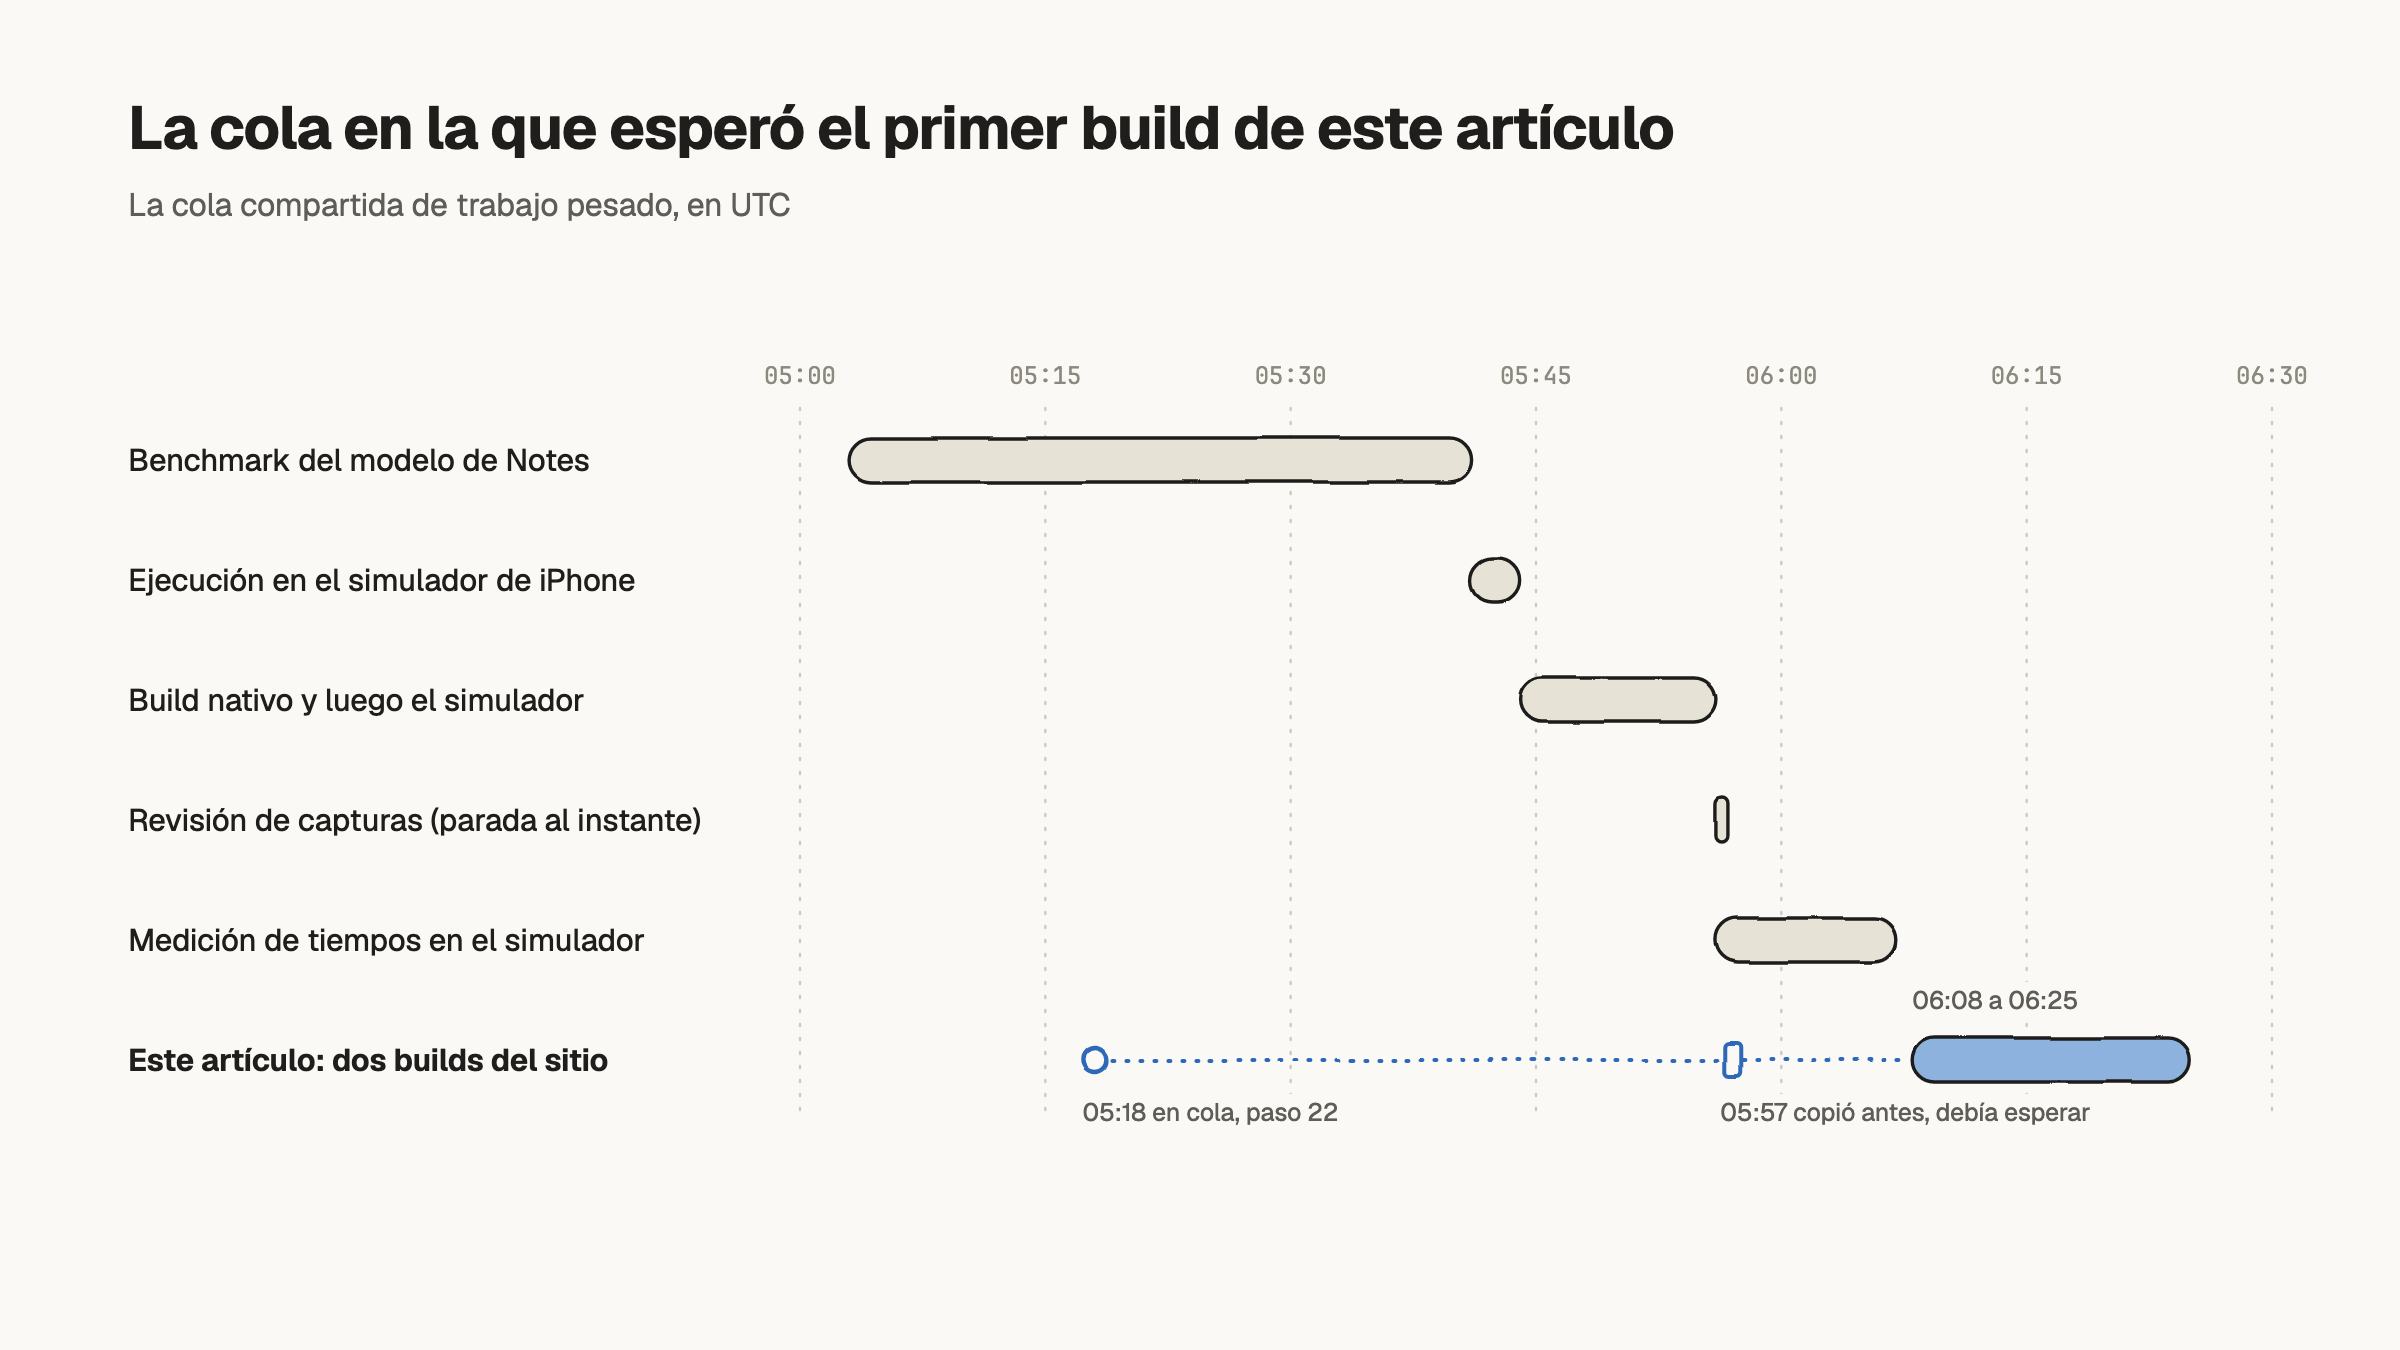
Las reglas de la cola viven en un script de shell, heavy.sh, y han cambiado más de una vez. El 28 de octubre eran demasiado estrictas: diez trabajos esperaron hasta 16 minutos con el 43 % de la memoria del Mac libre, y quitamos la cola. El 2 de noviembre eran demasiado laxas. Había unas 19 sesiones abiertas, varias con dos a cinco subagentes cada una, y la compuerta no contaba ni los subagentes ni un servidor de desarrollo que llevaba seis horas levantado. El Mac se quedó sin memoria, y cuando el harness limpió los shells en segundo plano, los vigilantes del coordinador cayeron con ellos.
La compuerta de hoy mide la memoria del Mac cada vez que se ejecuta. Si hay sitio, un trabajo arranca en el acto; si no, se retiene; y nunca corren más de cuatro trabajos pesados a la vez. La comprobación que va delante del trabajo pesado es, más o menos, esta:
# LOCKS is a directory every session shares; run/<pid> marks a heavy run.
level=$(sysctl -n kern.memorystatus_vm_pressure_level)  # 1 normal, 2 warn, 4 critical
free=$(memory_pressure -Q | awk -F: '/free percentage/ {print int($2)}')
live=0
for f in "$LOCKS"/run/*; do
  [ -e "$f" ] && kill -0 "${f##*/}" 2>/dev/null && live=$((live + 1))
done

hold() {
  [ -e "$LOCKS/STOP" ] || [ "$level" -ge 4 ] ||
  { [ "$level" -ge 2 ] && [ "$live" -ge 2 ]; } ||
  [ "$free" -lt 25 ] || { [ "$free" -lt 30 ] && [ "$live" -ge 1 ]; } ||
  [ "$live" -ge 4 ]
}
# Wait while hold() is true or older tickets fill the free slots (2 at warn, 4 otherwise).
# Then write run/$$, run "$@" as a child, and remove run/$$ when it exits.
Los trabajos en espera toman número por orden de llegada. Una vez, con unos 30 esperando, ganaba el que consultaba primero cuando se liberaba un hueco, y un trabajo esperó 35 minutos detrás de otros que habían llegado después. También hay límites para toda la máquina, seis subagentes y un simulador como mucho, pero esos dos siguen siendo solo reglas escritas que la compuerta no impone.
Las reglas que solo están por escrito se rompen
Cada incidente de este artículo dejó una regla, puesta por escrito con su fecha. Tres de ellas muestran lo que le pasa a una regla que solo existe por escrito.
La primera son los datos reales. Las sesiones de agentes que se lanzan desde la copia de la app de escritorio de Foxl que usamos de verdad heredan el entorno de la app, incluida una variable que apunta a su base de datos. El 19 de octubre, una suite de tests lanzada desde un shell así escribió 305 conversaciones falsas en la base de datos real de Foxl. La regla de borrar esa variable entró ese mismo día, y desde el 24 de octubre heavy.sh la borraba por su cuenta. El error volvió de todos modos: una comprobación ejecutada directamente con npm, scripts de un solo uso, tests que empaquetan el servidor de escritorio entero, cada vez por un camino que el wrapper no cubría. Ahora el servidor de escritorio se niega a abrir datos reales cuando corre bajo un ejecutor de tests (foxl/server/paths.ts). Solo los scripts de un solo uso siguen dependiendo de la regla escrita.
La segunda es un script que gasta dinero de verdad. check-remote-input.mjs está entre docenas de scripts check- que leen el repositorio y fallan con lo que encuentran, pero este lanza tareas reales en el servicio de producción de Foxl Code. El 23 de septiembre, una pasada por todos los scripts check- lanzó una. La regla entonces era ejecutar las comprobaciones una a una, por su nombre. El 18 de octubre el script se coló en una lista de comprobaciones elegida con grep, y el cargo de sus tres tareas dejó en negativo nuestra cuenta de pruebas. Ahora no hace nada sin la opción --live, y un test en pr-validate lo mantiene así.
La tercera es el bloqueo de push. Los push pasaban por un bloqueo que una sesión obtenía creando un directorio. El 2 de noviembre una sesión intentó tomarlo a mano, dentro de un lote de llamadas a herramientas en paralelo. Crear el directorio falló, porque otra sesión tenía el bloqueo, pero el resto del lote se ejecutó igual: la sesión hizo push y luego borró el bloqueo de la otra sesión. Esa misma mañana entró un script que toma el bloqueo y solo libera el suyo, pero una sesión confinada a su propio worktree no podía usarlo y siguió tomando el bloqueo a mano, paso a paso. El mismo error se repitió el 4 de noviembre.
Ninguna de estas comprobaciones acabó con su tipo de error. Cada una cerró el camino por el que llegó el último, y hasta ahora el siguiente siempre ha encontrado otro.
Lo que demuestra un check en verde
Toda nuestra CI corre en runners autoalojados, y cada pull request tiene que pasar una compuerta llamada pr-validate. La pregunta es qué demuestra ese check en verde. El verde significa que el pull request pasó los tests por su cuenta, y nada más.
El primer merge train, el de la v0.7.27 del 24 de septiembre, dejó ver la diferencia. Cincuenta y cuatro pull requests estaban en verde cada uno en su propia CI y aun así contenían cuatro bloqueos. Uno perdía los últimos caracteres escritos con un método de entrada; otro rompía la respuesta desde la pantalla de bloqueo del iPhone. Ese mismo día el Mac se quedó congelado del todo con 19 agentes revisores en marcha a la vez. Desde entonces los revisores corren como mucho de siete en siete, pero eso también es solo una regla escrita.
Así que ahora un train se construye a partir del árbol fusionado de todos los pull requests que están listos, y la decisión de fusionar se toma sobre ese árbol. Cada agente revisor toma un grupo de pull requests relacionados, con unas instrucciones que incluyen esto, en su inglés original:
Your job is to REFUTE each PR in your group, not to confirm it. Assume every PR body overclaims until you have reproduced its claim. A green pr-validate on the PR proves little: it ran without the other PRs, and it cannot see UX or cost.
Es decir: refutar cada pull request, no confirmarlo; dar por hecho que el texto de cada pull request exagera hasta haber reproducido lo que afirma; y saber que un pr-validate en verde en el pull request prueba poco, porque corrió sin los demás pull requests y no ve la experiencia de uso ni el coste. Un revisor responde MERGE, MERGE_WITH_FIXES con el parche escrito, HOLD o CLOSE. Los arreglos entran como commits propios encima del pull request, y un pull request que no se puede arreglar se deja fuera reconstruyendo el train sin él.
«Don’t Build Multi-Agents», de Cognition, argumenta en contra de repartir una tarea entre agentes que no ven el trabajo de los demás, y a favor de dársela a un solo agente que tenga todo el contexto. Nosotros sí le damos a cada sesión una tarea entera. Queda un problema: los agentes confían demasiado en su propio trabajo. Por eso a los revisores se les pide que refuten.
Un test que el agente escribe junto con su funcionalidad es una prueba especialmente débil. El test y el código salen de la misma comprensión del problema, así que cuando el agente entiende mal la API de un proveedor o lo que se le pidió, los dos llevan el mismo error. Esto es lo que puede ver cada tipo de comprobación:
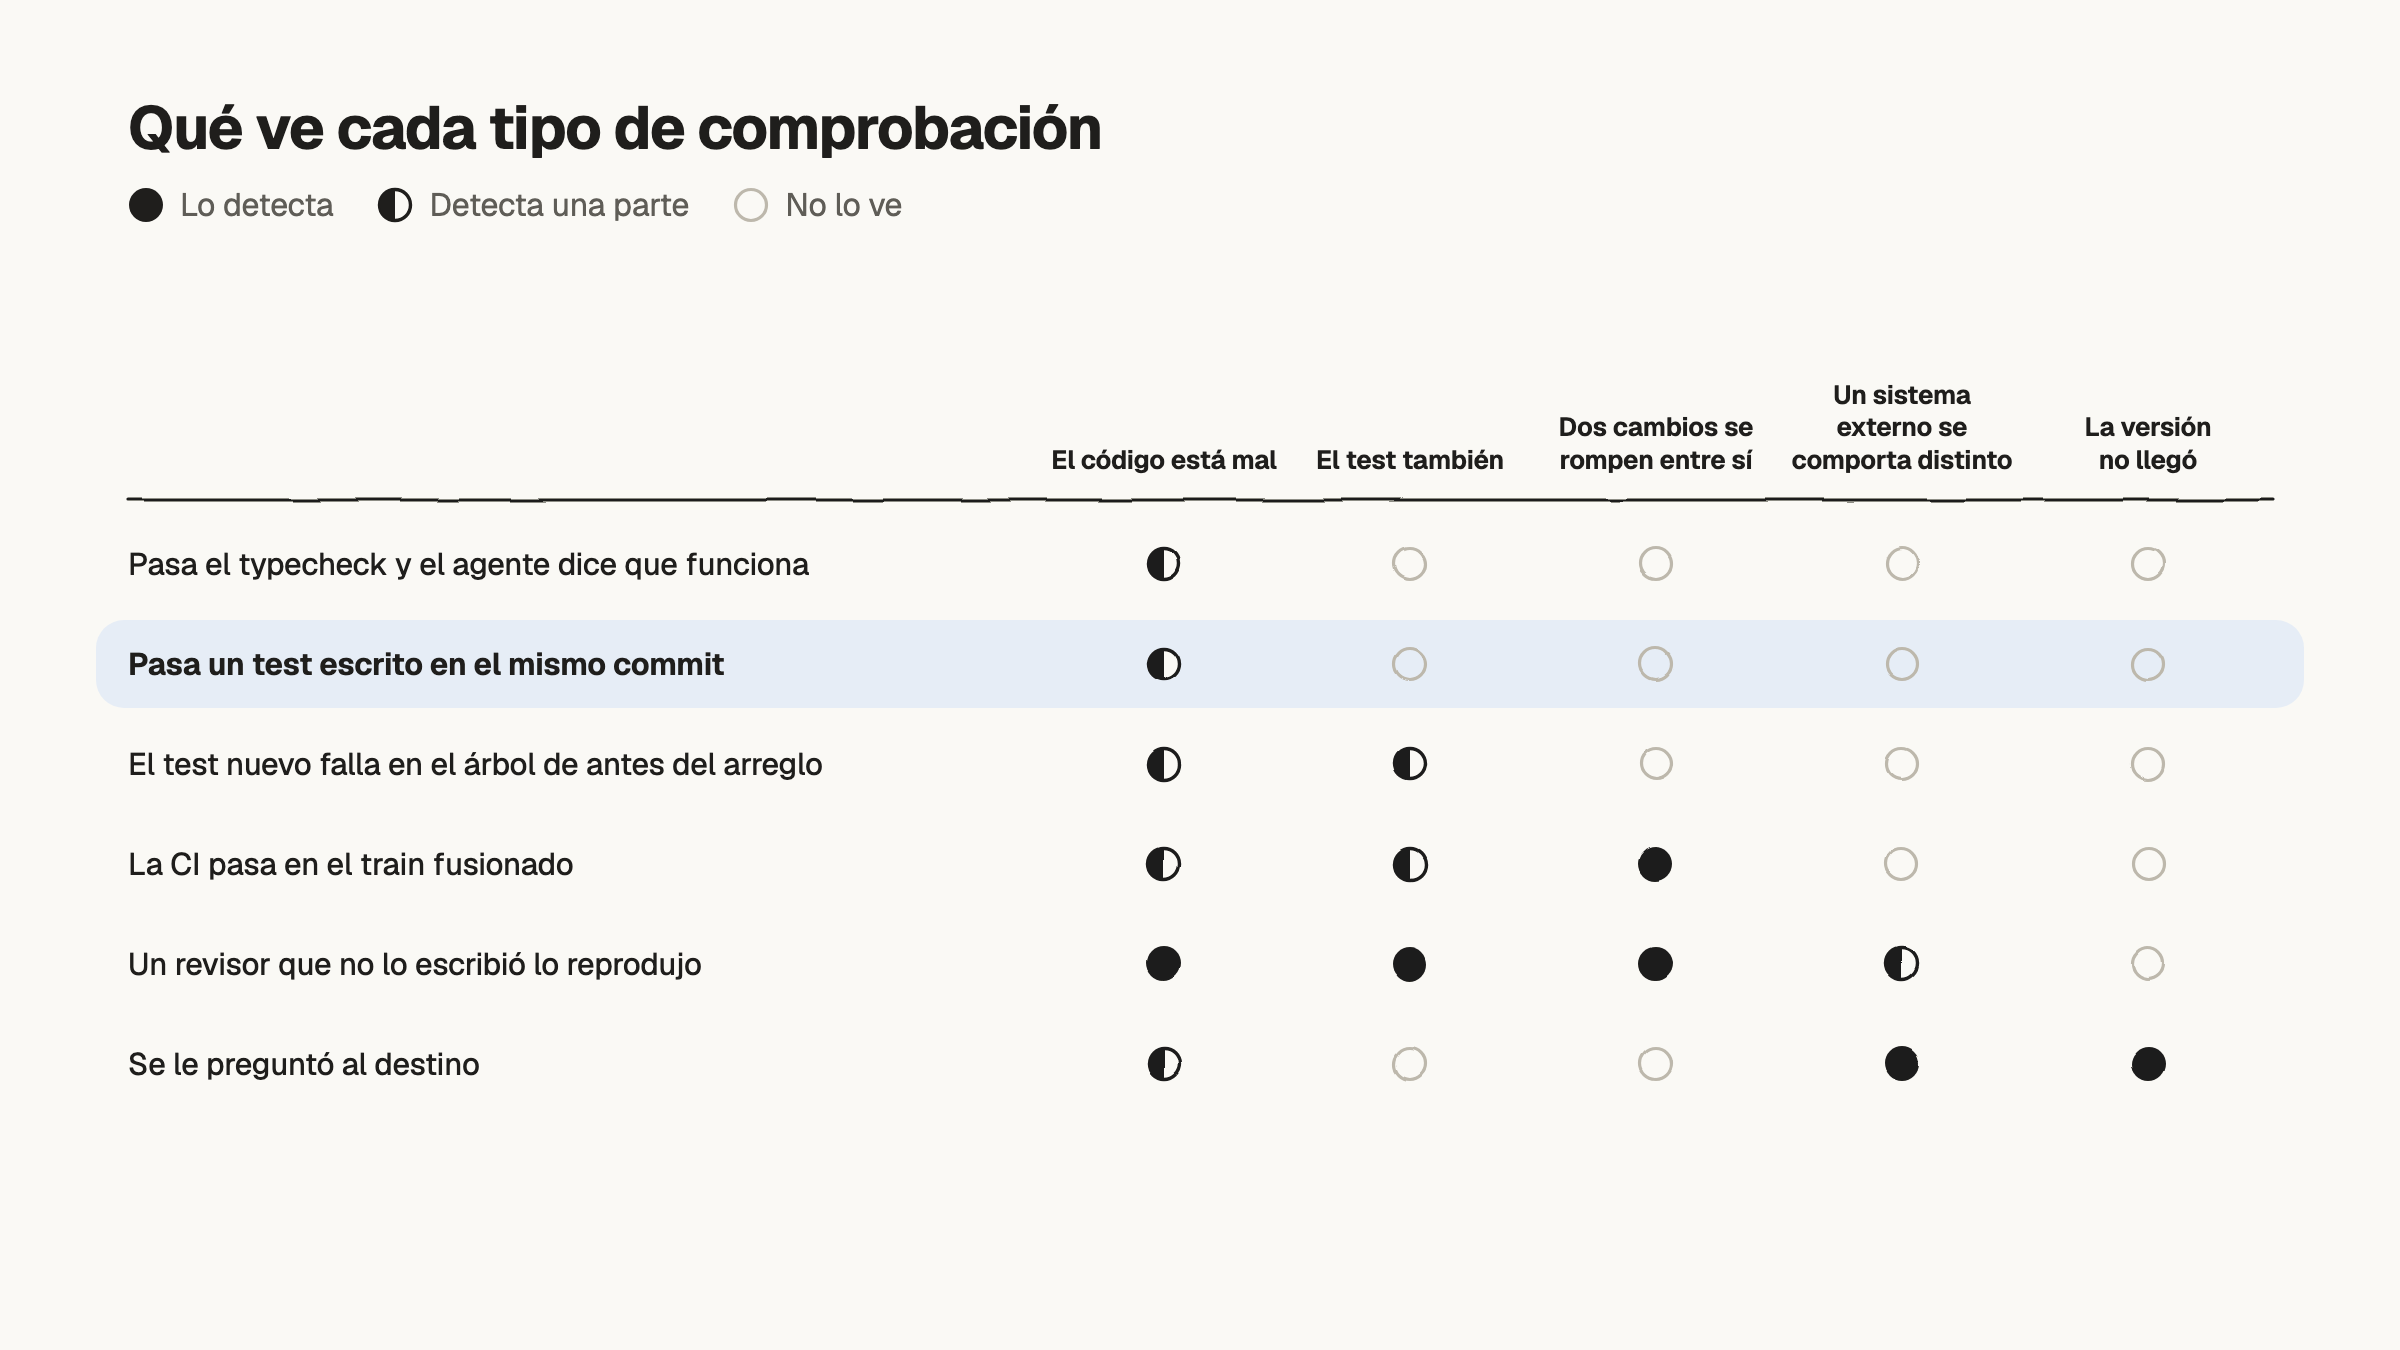
Por eso un test nuevo solo cuenta si falla en el árbol de antes del arreglo, y la compuerta final es la CI en el train fusionado. Para todo lo que pasa fuera del repositorio, la prueba está en ese sistema externo. Tras subir la versión de una CLI, los terminales remotos de Codex y OpenCode en Foxl Code no aceptaron ninguna pulsación durante diez días mientras todas las compuertas estaban en verde. Un workflow de versión informó una vez de éxito mientras TestFlight no tenía ninguna compilación. Y el 3 de noviembre descubrimos que 34 de 43 harnesses de capturas servían páginas sin las fuentes reales, así que los revisores llevaban tiempo juzgando letras que la app publicada no dibuja.
Preguntar al destino
Una versión estable es una sola ejecución de workflow. Esa ejecución compila y publica las apps de Windows, Linux, macOS, iOS y Android, las apps web y el servidor relay. No nos fiamos de que el workflow diga que salió bien: las comprobaciones de después de una versión preguntan directamente a cada destino.
Un script espera hasta que las cinco plataformas tienen sus archivos antes de publicar la versión. El cask de Homebrew se compara con la versión publicada, porque una vez sirvió una compilación de una semana de antigüedad durante cuatro versiones mientras el workflow que lo actualiza parecía estar bien. Las apps web desplegadas se comparan con la versión publicada, porque un Worker responde 200 con un bundle viejo. A TestFlight se le pregunta mediante la API de Apple.
Si quieres montar algo parecido
Esto es lo que nos funcionó:
- Dale a cada agente su propio git worktree. En APFS,
cp -Rccopianode_modulescomo un clon copy-on-write que casi no ocupa disco. Nunca enlaces un mismonode_modulescon un symlink a varios worktrees. - Haz de un agente el coordinador, y guarda el estado compartido en archivos simples que todos los agentes puedan leer: quién se encarga de qué archivos, quién ejecuta qué, qué está congelado.
- Pon una compuerta al trabajo que consume mucha memoria según la memoria medida, y cuenta los subagentes y los servidores de desarrollo junto con los builds.
- Lee las refs por SHA y no por nombre, porque otras sesiones mueven
origin/*todo el rato.
Antes de montar un merge train, puedes trazar el mapa de sus conflictos sin hacer checkout, plegando cada pull request sobre main por turnos. En bash:
# Each head as a local ref first: git fetch origin '+refs/pull/*/head:refs/pr/*'
prs=(101 102 103)
acc=$(git rev-parse origin/main)
for pr in "${prs[@]}"; do
  out=$(git merge-tree --write-tree --name-only "$acc" "refs/pr/$pr"); code=$?
  if [ "$code" -eq 0 ]; then
    acc=$(git commit-tree "${out%%$'\n'*}" -p "$acc" -p "refs/pr/$pr" -m "train: #$pr")
  elif [ "$code" -eq 1 ]; then
    echo "#$pr conflicts in:"; echo "$out" | sed -n '2,/^$/p'
  else
    echo "#$pr: merge-tree failed ($code)"; exit "$code"
  fi
done
Un archivo al que todos los pull requests añaden líneas al final, como un changelog, aparecerá en casi todos los conflictos salvo que le des una fusión union para este comando: git -c core.attributesFile=<file>, con CHANGELOG.md merge=union en ese archivo.
Lo que hacen las personas
En esta configuración no escribimos código, y rara vez leemos un diff. Una petición suele ser una frase y una captura. Lo que leemos es lo que vuelve: las capturas de cada pull request, los veredictos de cada train y el informe con el que termina cada versión, que recoge lo que salió, lo que respondió cada comprobación y las capturas de todos los pull requests que incluye.
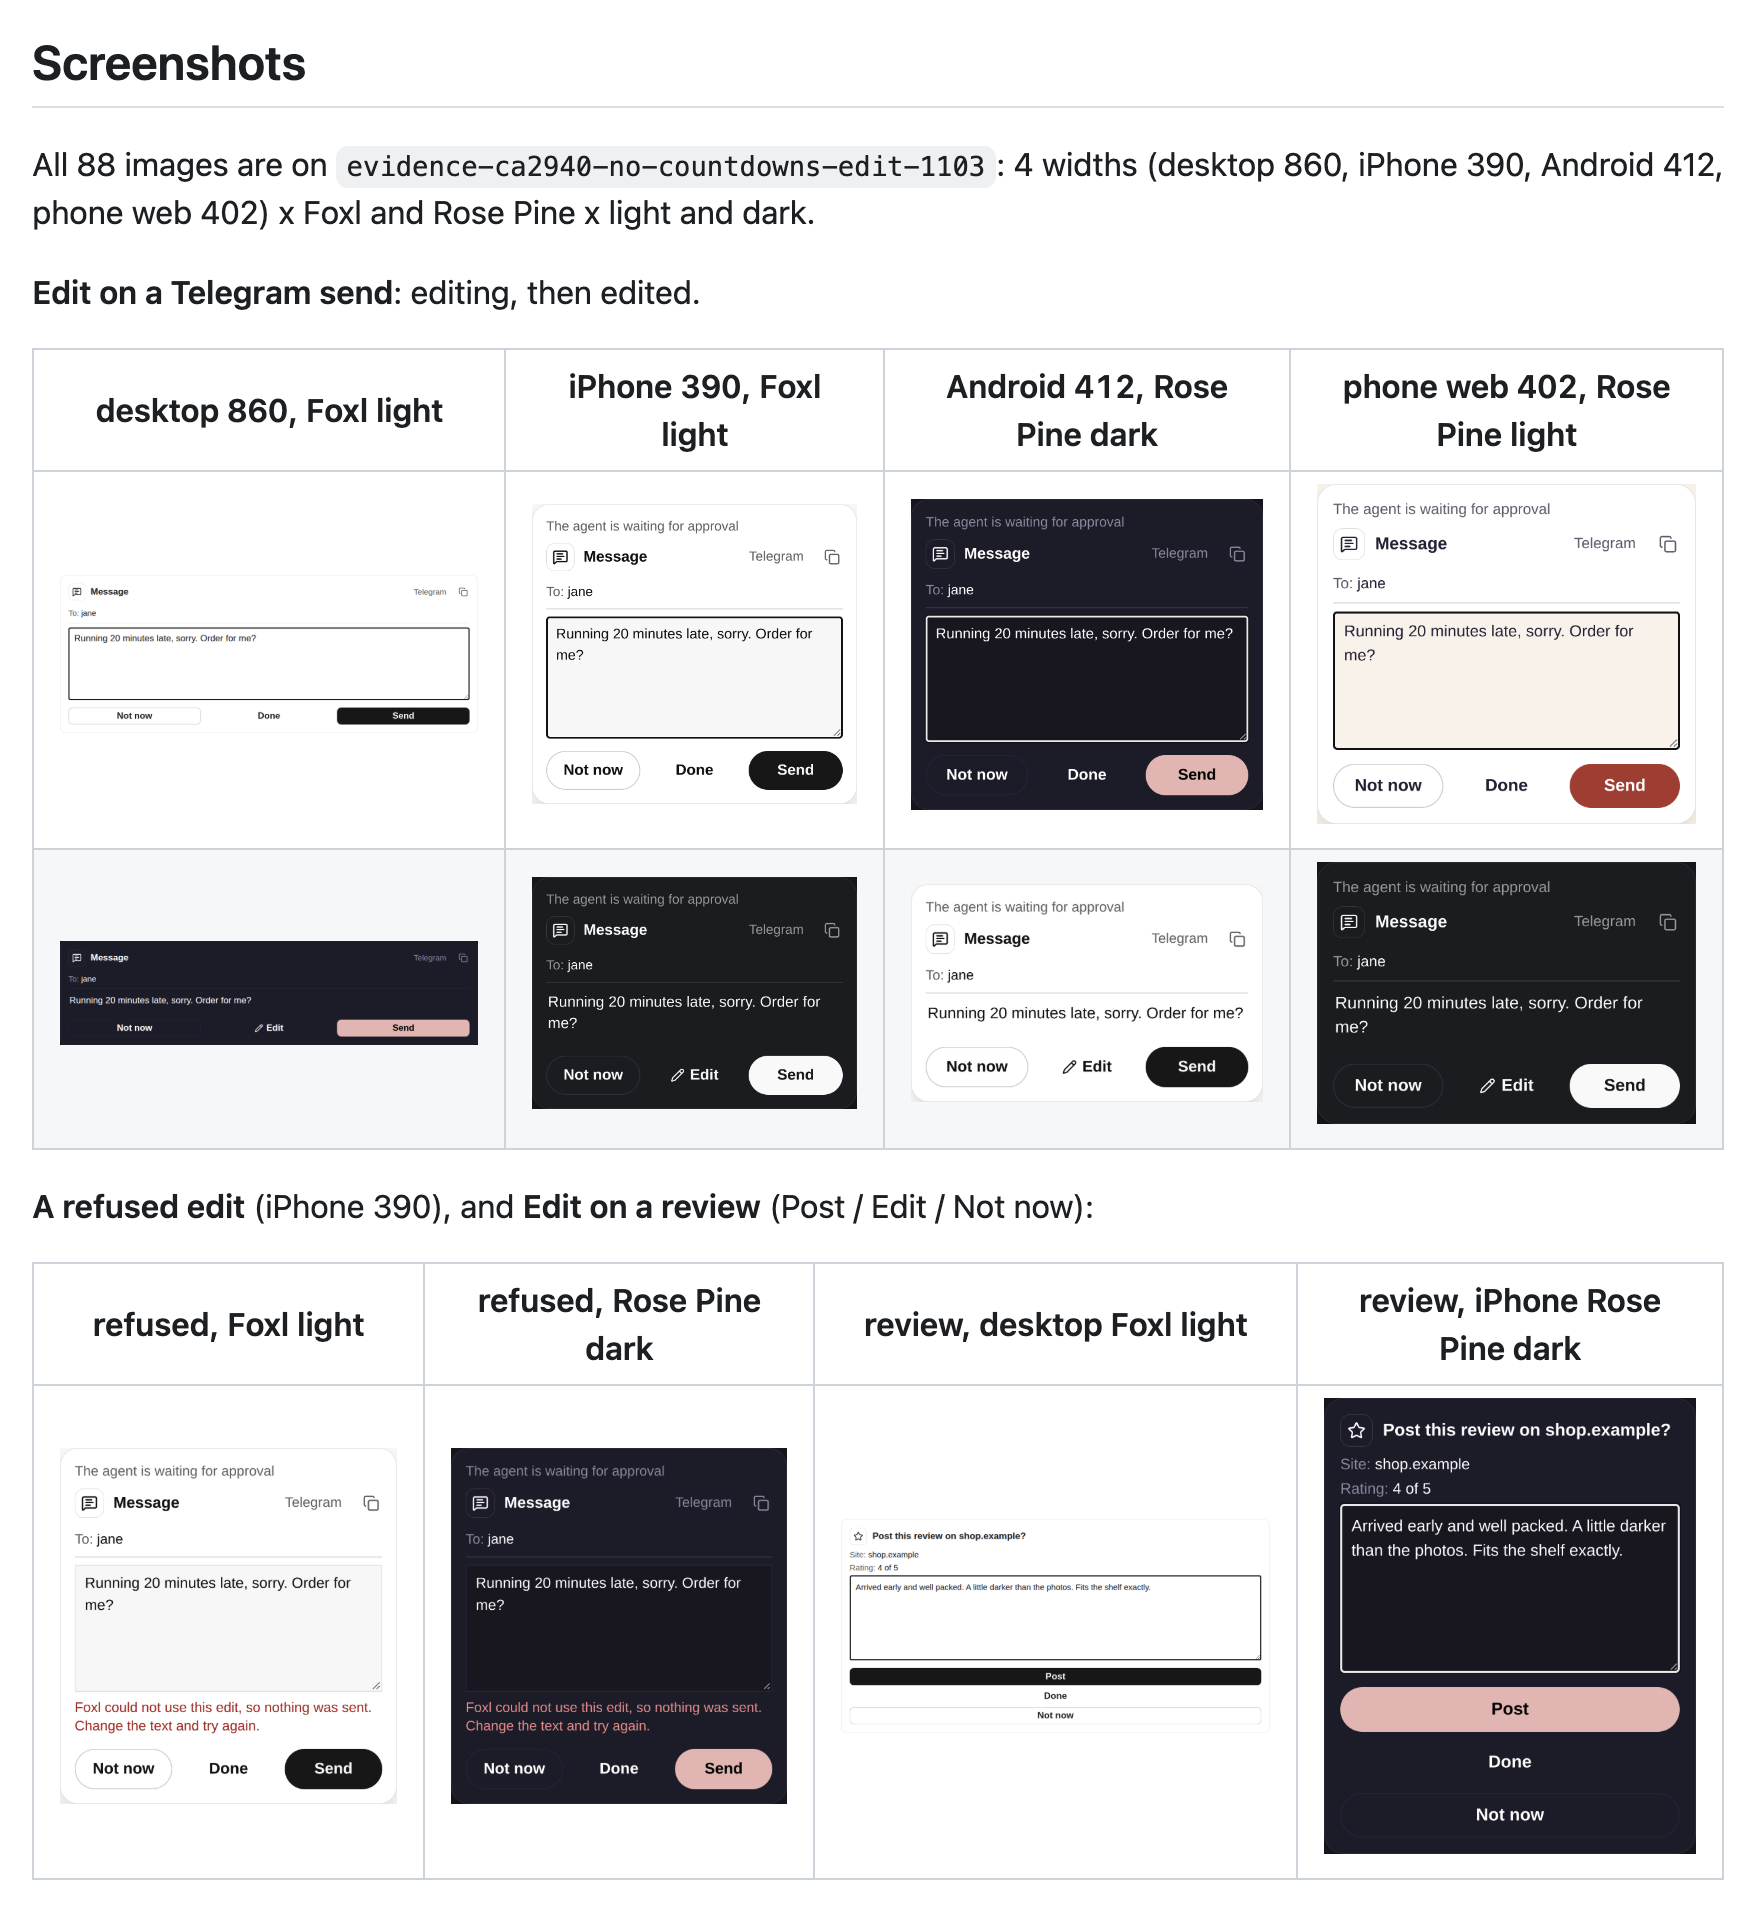
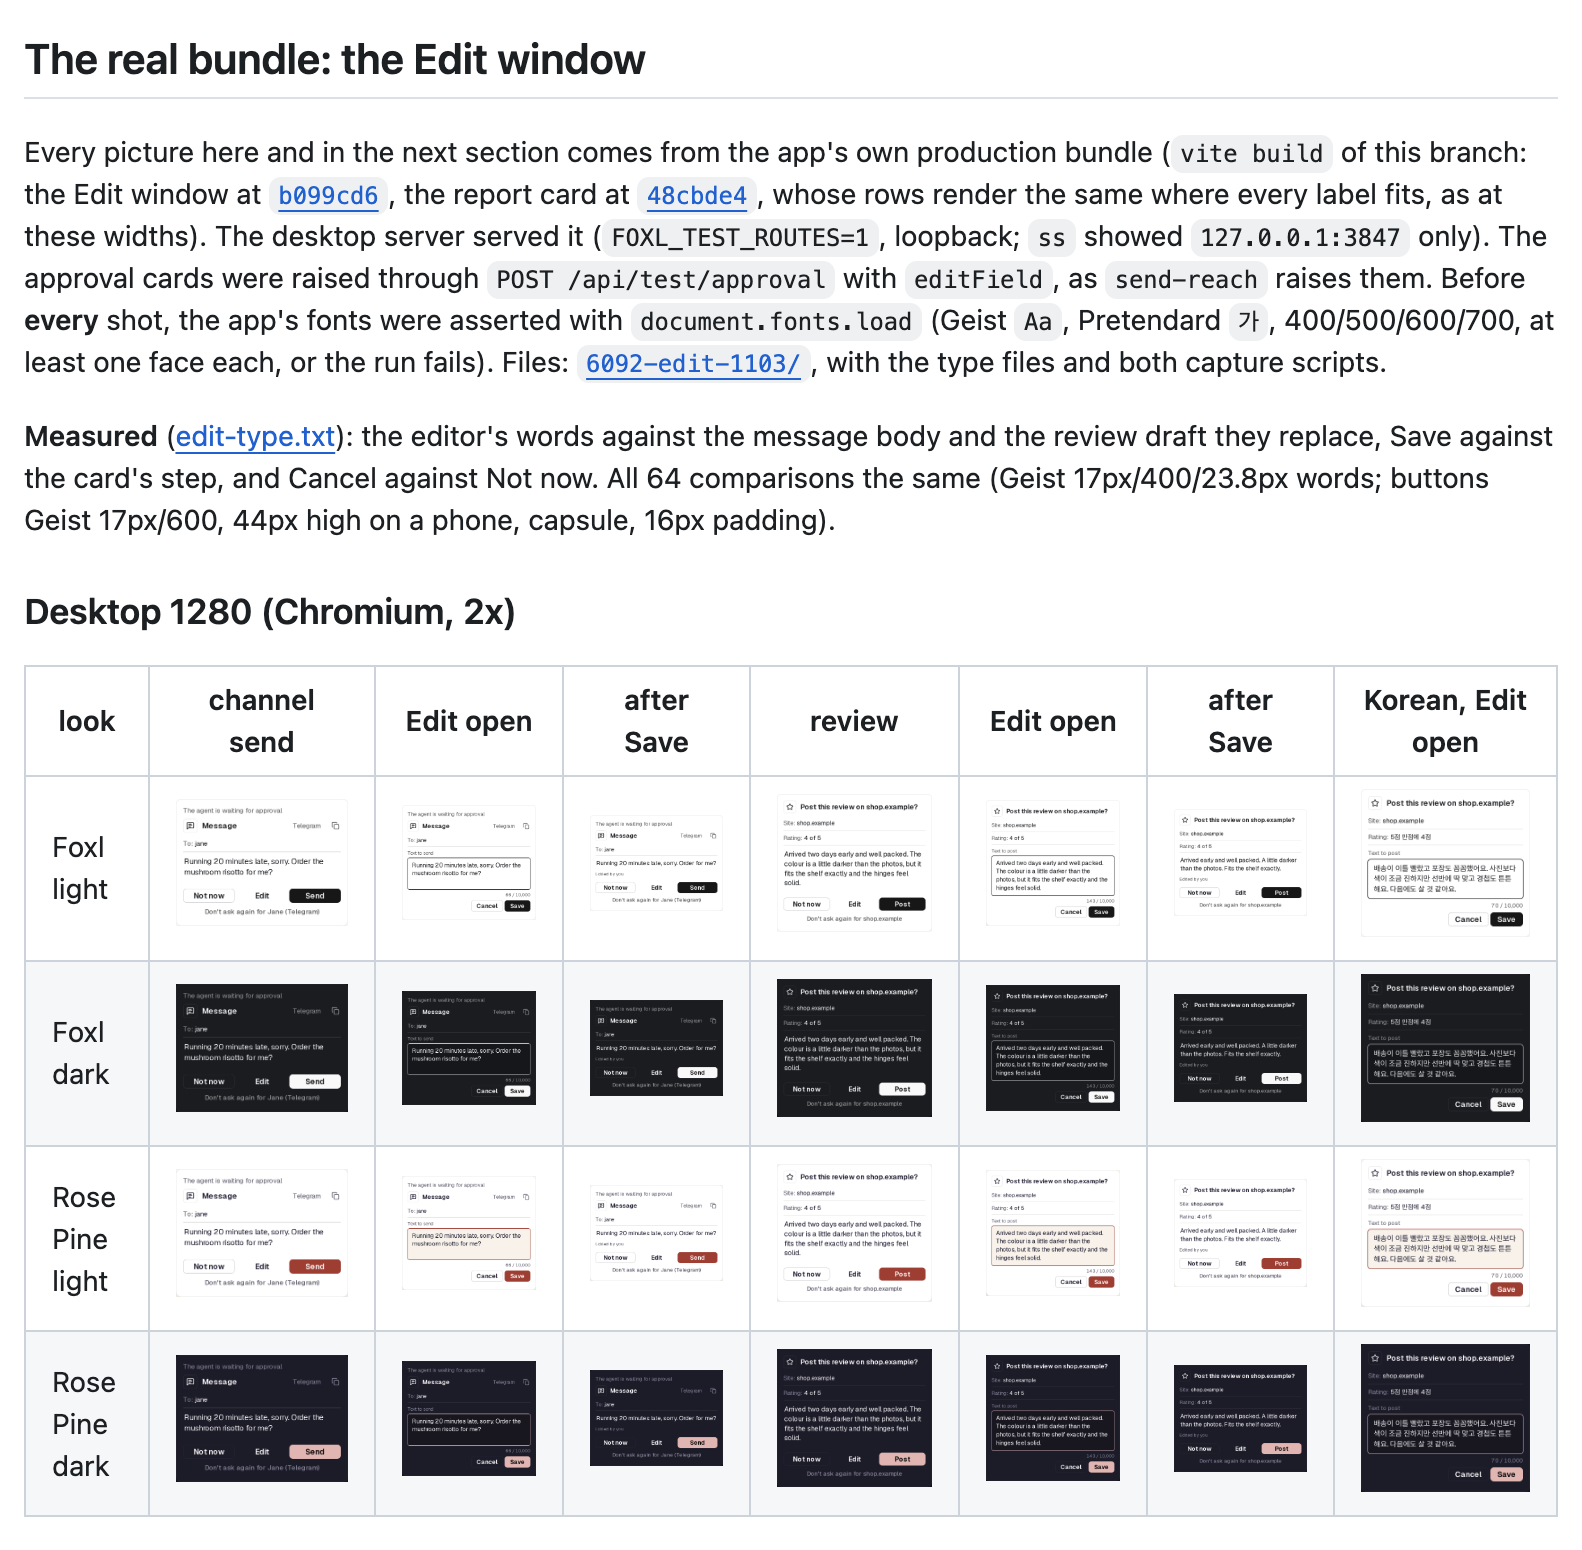
Una mañana sirve de ejemplo. El 3 de noviembre a las 04:59 UTC llegó un pull request con 20 capturas de una nueva ventana de edición en la tarjeta que publica una reseña. El texto estaba en otra fuente, el cuadro de texto era el del navegador y tres botones bajaban por la tarjeta uno debajo de otro. A las 05:04 le enviamos dos líneas al coordinador: que el autor rediseñara la ventana con el sistema de diseño, devolviera el pull request a borrador y lo volviera a subir. Doce segundos después era un borrador. A las 09:30 volvió sobre el propio editor de borradores de la app, con 296 capturas, cada una tomada después de que cargaran las fuentes de la app, y se fusionó a las 11:50. La otra fuente no era culpa del pull request: su harness de capturas nunca servía las fuentes de la app, y averiguar por qué, ese mismo día, es como encontramos los 34 harnesses de los que hablamos más arriba.
Cuando algo sale mal, escribimos la regla que lo habría detectado en el archivo CLAUDE.md de esa área, con la fecha y el incidente, y luego buscamos el punto en el que un script podría imponerla. Los agentes toman las decisiones reversibles a partir del código y dejan escrito lo que decidieron. Todo lo irreversible, y todo lo que tiene que ver con dinero, espera a una persona. Un pull request que hace a Foxl menos cómodo que los productos con los que la gente lo compara se retiene, aunque su código sea correcto.
La parte que no hemos resuelto
Los revisores son agentes, pero los criterios que aplican los escribieron personas, y son personas las que siguen leyendo sus veredictos. Esa lectura es ahora el paso más lento entre un pull request y una versión. Por eso estamos escribiendo un criterio para cada tipo de afirmación, uno que otro agente pueda comprobar sin una persona: para un arreglo de lógica, un test que falla antes del arreglo y pasa en el train fusionado; para la API de un proveedor, una captura del servicio real; para todo lo que ve una persona, capturas de la compilación real con las fuentes reales; para un coste, recuentos de peticiones medidos; para una versión, la respuesta de cada destino. Todo lo irreversible, y todo lo que tiene que ver con dinero, sigue en manos de las personas.
Todavía no sabemos cómo saber cuándo un criterio basta. El plan es calificar a los revisores como se califican los tests: contar los bloqueos que encuentra cada uno y que la CI pasó por alto, y cuántas veces una persona revoca su veredicto. Cuando las personas dejen de revocar a un revisor en un tipo de afirmación, ese criterio ya no necesitará a nadie. Todavía no tenemos ninguna de las dos cifras.
Referencias y lecturas recomendadas
- Registro de cambios de Claude CodeReferencia
- CodexReferencia
- OrcaReferencia
- herdrReferencia
- Kiro CrewReferencia
- Índice de RFC de Kiro CrewReferencia
- Foxl CodeReferencia
- Cognition, Don’t Build Multi-AgentsReferencia