Чему мы научились, строя ИИ-фабрику программного обеспечения
Команда Foxl выпускает десятки релизов в месяц на ИИ-фабрике программного обеспечения, где одновременно работают от 15 до 20 агентов-программистов. Написать код было простой частью; знать, что он верен, оказалось куда труднее. Вот чему мы научились, строя проверки.
На этой странице
Команда Foxl выпускает десятки релизов в месяц. В октябре их было 66: 22 стабильных и 44 беты. Каждый релиз несёт десктопное приложение для Windows, macOS и Linux, а каждый стабильный ещё и приложения для iOS и Android и веб-приложение. И каждый раз нужно проверить, что всё это работает.
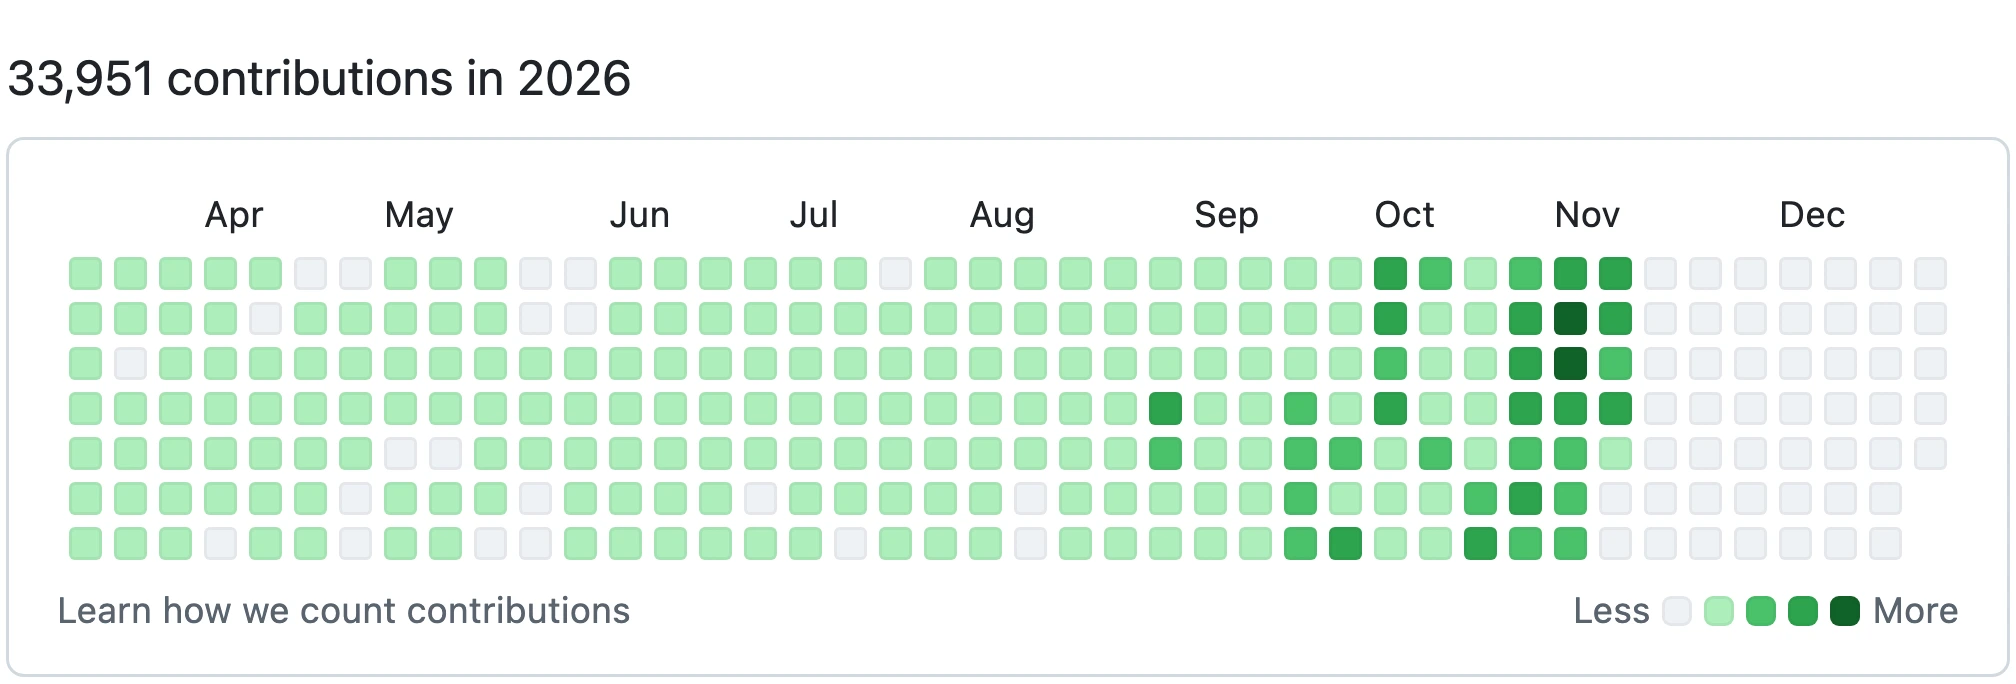
За тот же месяц в нашем репозитории открыли 2 140 пул-реквестов и смёржили 2 040, то есть почти 70 открытых в день. Большую часть этого кода написали не люди, а агенты-программисты: от 15 до 20 сессий Claude Code одновременно на одном Mac, каждая в своей ветке. График вкладов GitHub-аккаунта, от имени которого коммитят эти сессии, показывает перемену с первого взгляда. В каждый из двух предыдущих лет там было несколько сотен вкладов. В этом году их уже больше 30 000.
Разработку, в которой агенты планируют работу, пишут код, тестируют его и проводят ревью, стали называть ИИ-фабрикой программного обеспечения. Люди решают, что строить, и за ними последнее слово в том, что уходит в релиз. Наша фабрика работает именно так. Но когда в марте мы отдали код агентам, оказалось, что трудность не в том, чтобы его написать. Трудно знать, действительно ли код, написанный агентами, верен и выдерживает ли он все пять платформ.
Эта статья о том, чему мы научились, строя для этого проверки. Если коротко: каждое правило, которое мы только записывали для агентов, нарушалось. Большинство продержалось несколько дней. Держались проверки, поставленные на том самом пути, по которому пришла ошибка, а следующая ошибка почти всегда приходила путём, где проверки ещё не было.
От одной сессии к двадцати
Первые четыре месяца у нас весь день была открыта одна сессия, и человек читал каждый diff, как только он появлялся. Почти всё шло прямо в main; за весь июнь в репозитории один пул-реквест. Пределом было человеческое внимание. Как следует уследить можно было примерно за одной сессией.
В июле мы направили Foxl Code, нашего облачного агента-программиста, на собственный репозиторий Foxl. Каждая задача получала свою облачную VM, и 22 июля эта схема выпустила пять продакшен-релизов за один день. Но macOS в этих VM нет, так что всё, что требовало Xcode или симулятора iPhone, по-прежнему приходилось возвращать на Mac.
В августе мы изменили сам порядок работы: по git worktree на каждую сессию и по пул-реквесту на каждое изменение. Сессии перестали затирать работу друг друга, поэтому несколько могли работать одновременно, а пул-реквестов стало 598 в августе, 946 в сентябре и 2 140 в октябре.
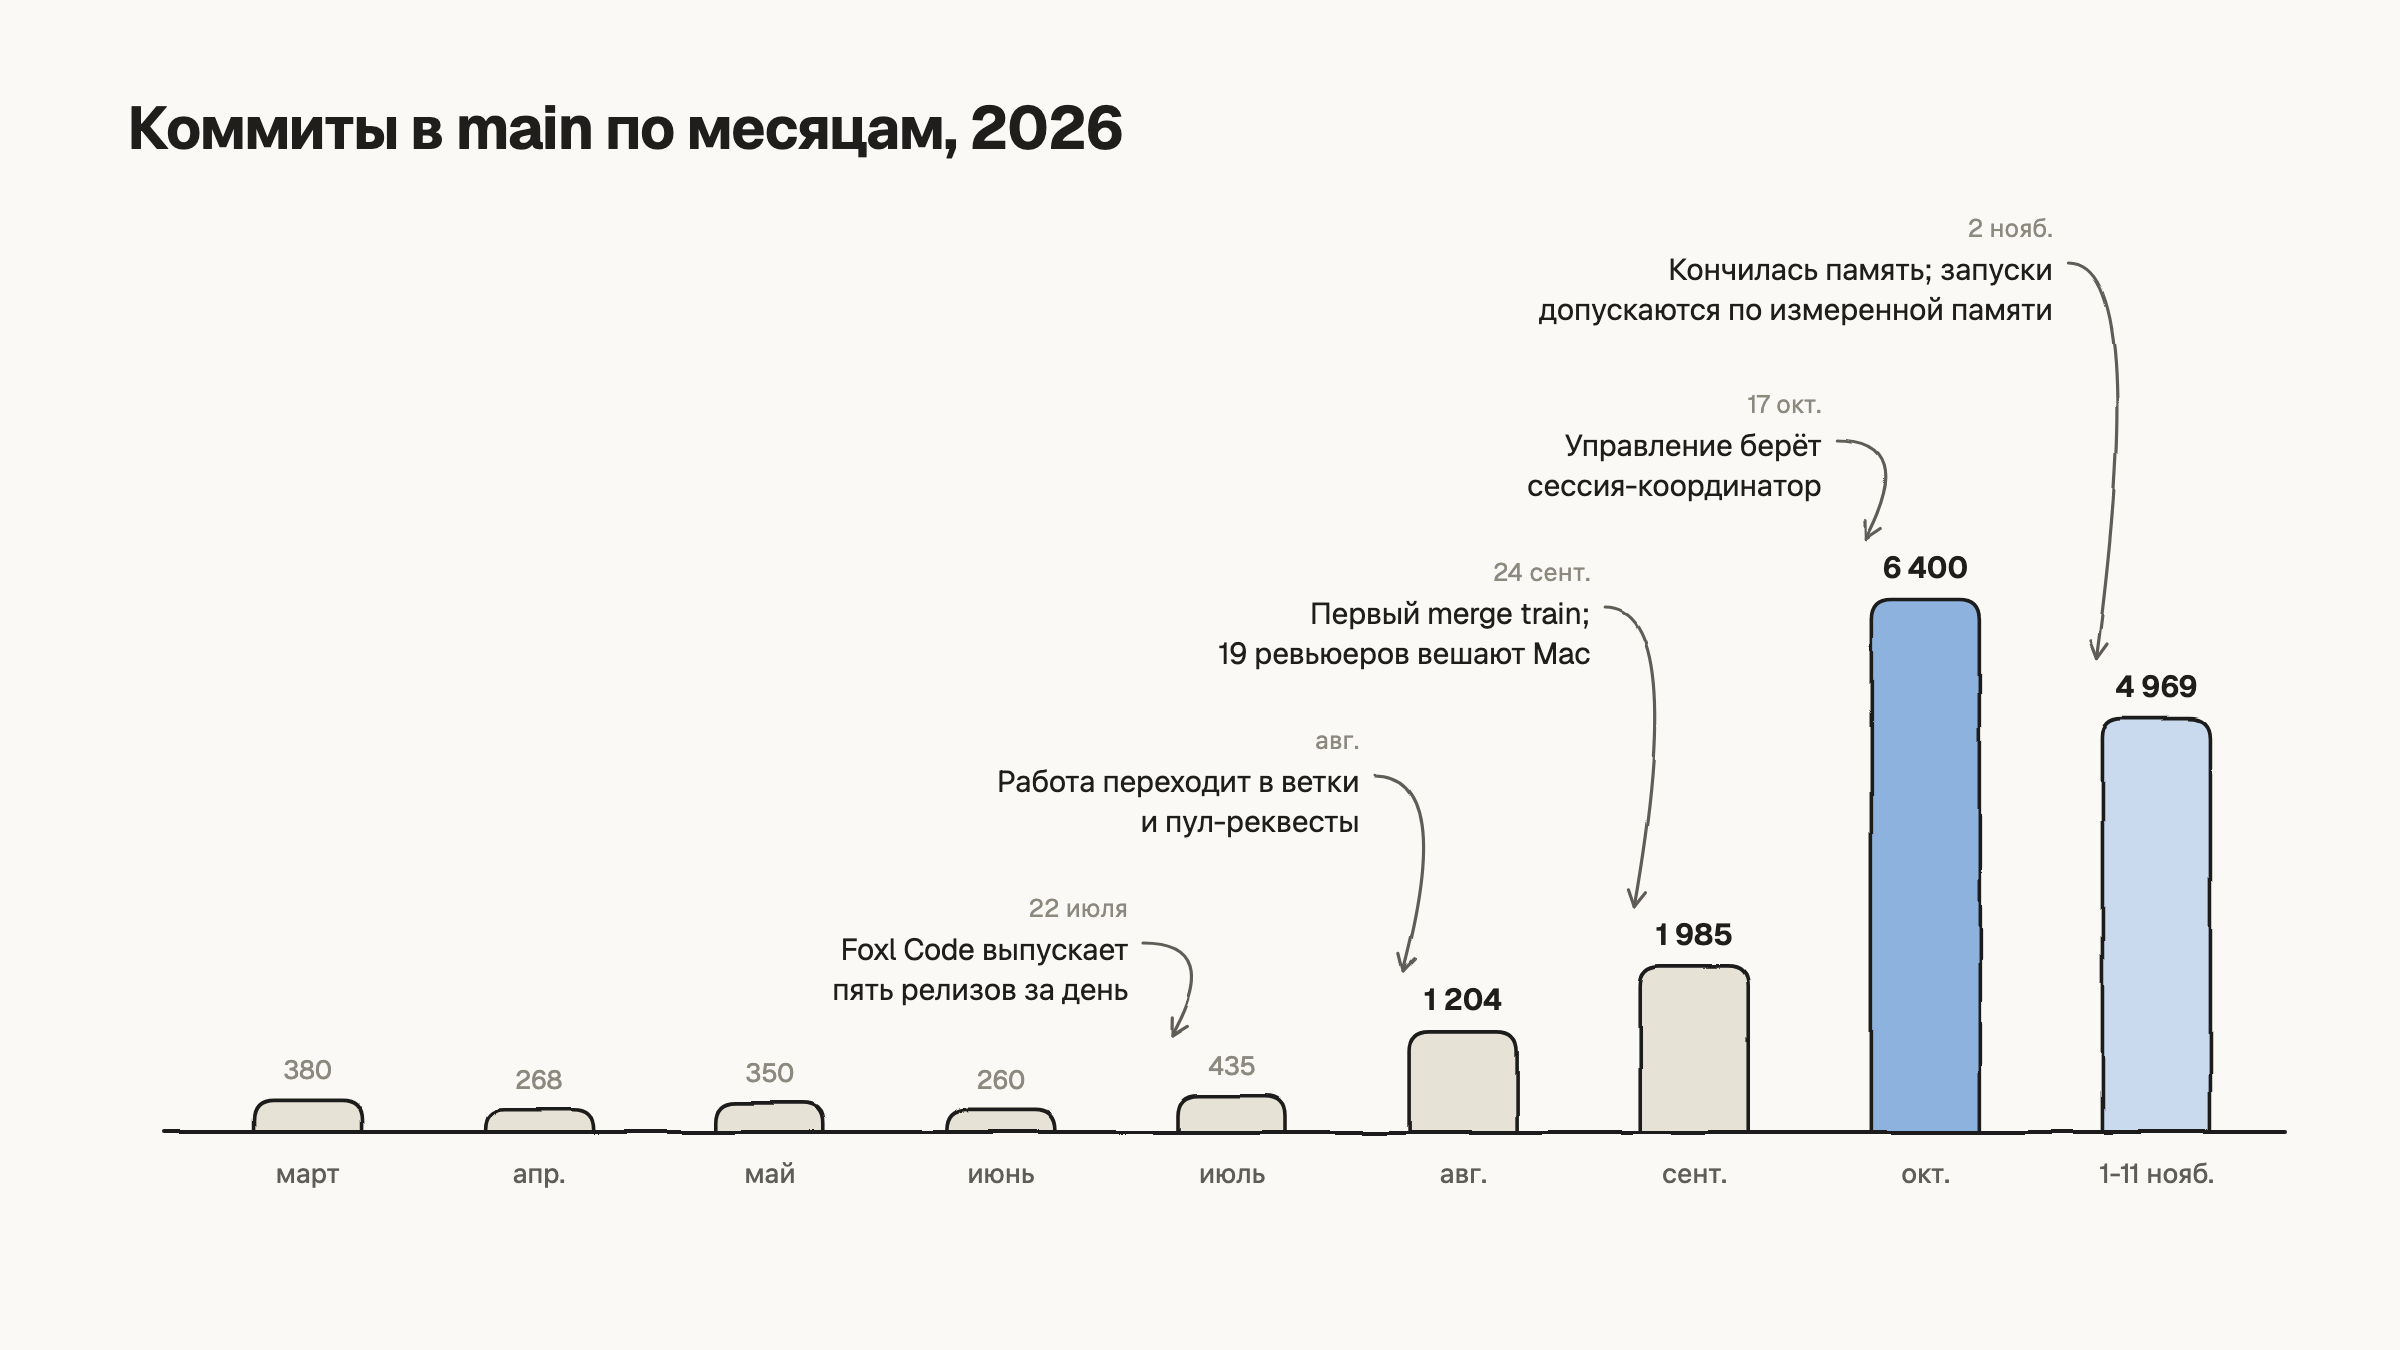
С ростом цифр появились новые проблемы. Сессии одновременно правили одни и те же файлы, а Mac стал упираться в память. А главное, первый merge train 24 сентября показал, что зелёный CI не означает, что пул-реквест верен. Об этом ниже.
Где можно проверить, там и работаем
Чтобы проверять пять платформ, сначала нужны машины, на которых их можно запустить. Мы используем три вида машин, и каждая может проверить своё.
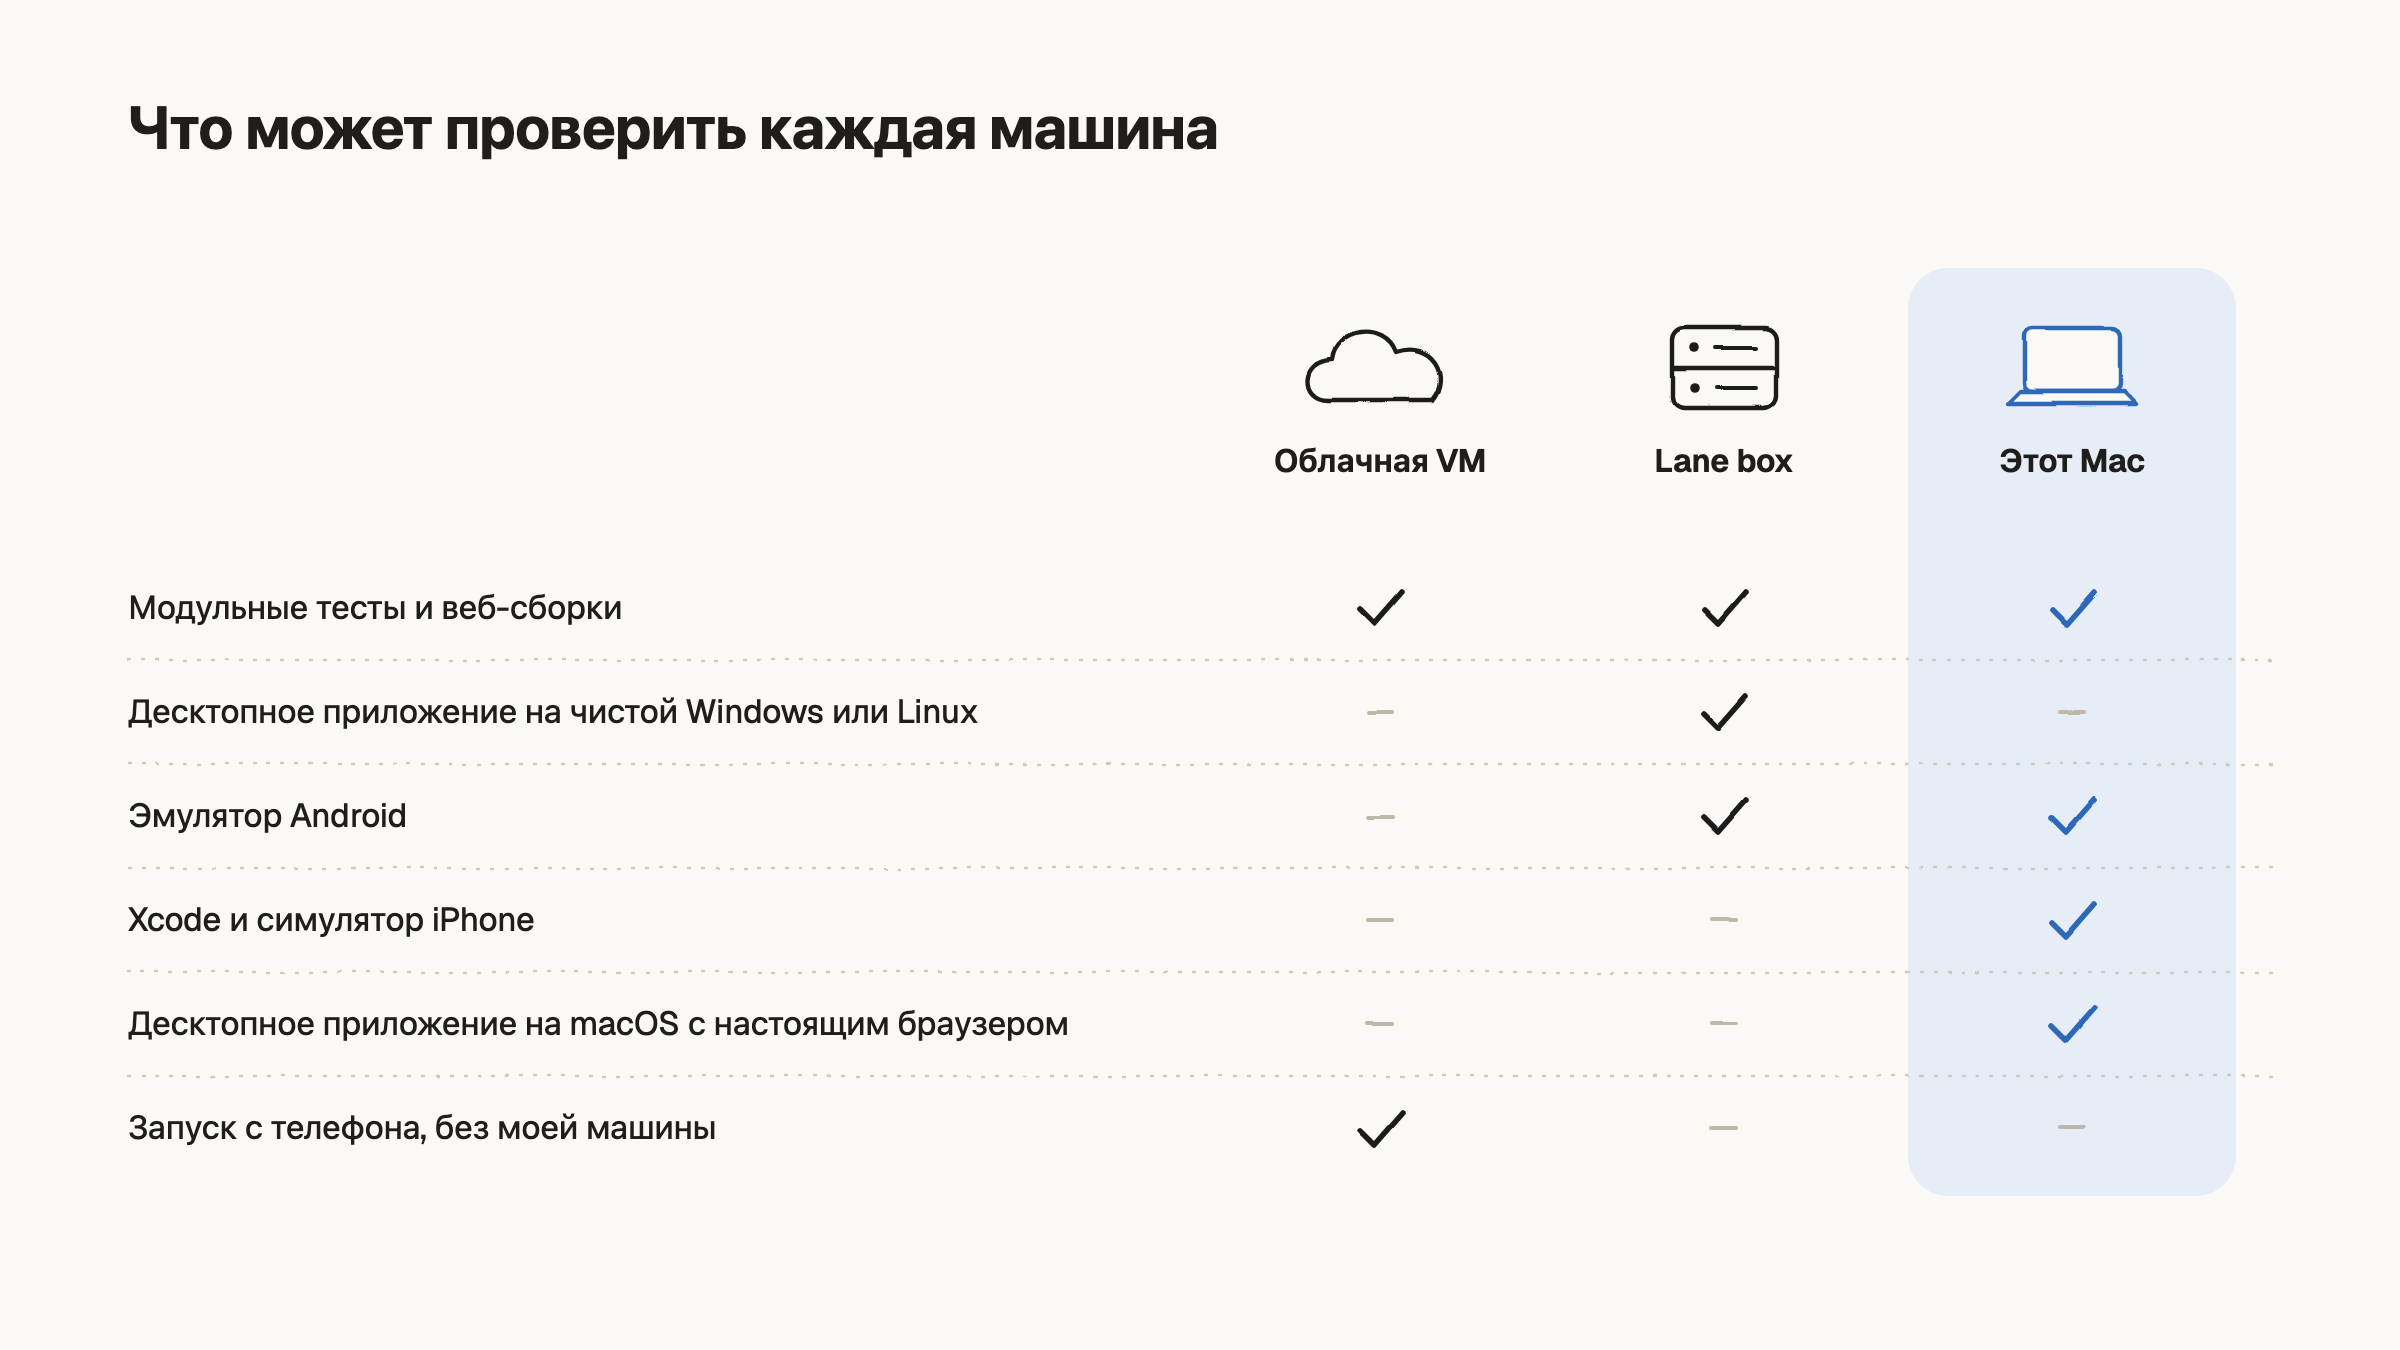
Облачные VM хороши для изолированной работы в Linux, и их можно запустить прямо с телефона. Когда сессии нужно десктопное приложение на чистой Windows или Linux или эмулятор Android, она получает одноразовый инстанс EC2, который мы называем lane box. А всё остальное может проверить только Mac: Xcode, симулятор iPhone, настоящий Chrome и десктопное приложение на macOS.
Поэтому большинство сессий оказалось на одном Mac. Это ещё и компьютер, которым мы пользуемся каждый день, а значит, все сессии делят память одной машины и работают совсем рядом с настоящими данными.
Запускать агентов уже умеют все
Инструментов для запуска многих агентов сразу хватает. Каждый, который мы смотрели, делает параллельный запуск простым, а некоторые дают агентам переговариваться. Различаются они тем, где работают агенты и какую часть проверки их результатов инструмент берёт на себя.
Claude Code и Codex
Это сами агенты. Claude Code запускает фоновые сессии, которые продолжают работать после закрытия терминала, каждую в своём worktree (claude --bg --worktree), и сессии могут писать друг другу или запускать субагентов. Есть и облачные сессии, которые запускают из веба или с телефона. Codex бывает в виде CLI, десктопного приложения и расширений для IDE, а Codex Web выполняет задачи в Linux-контейнерах в облаке OpenAI.
Orca
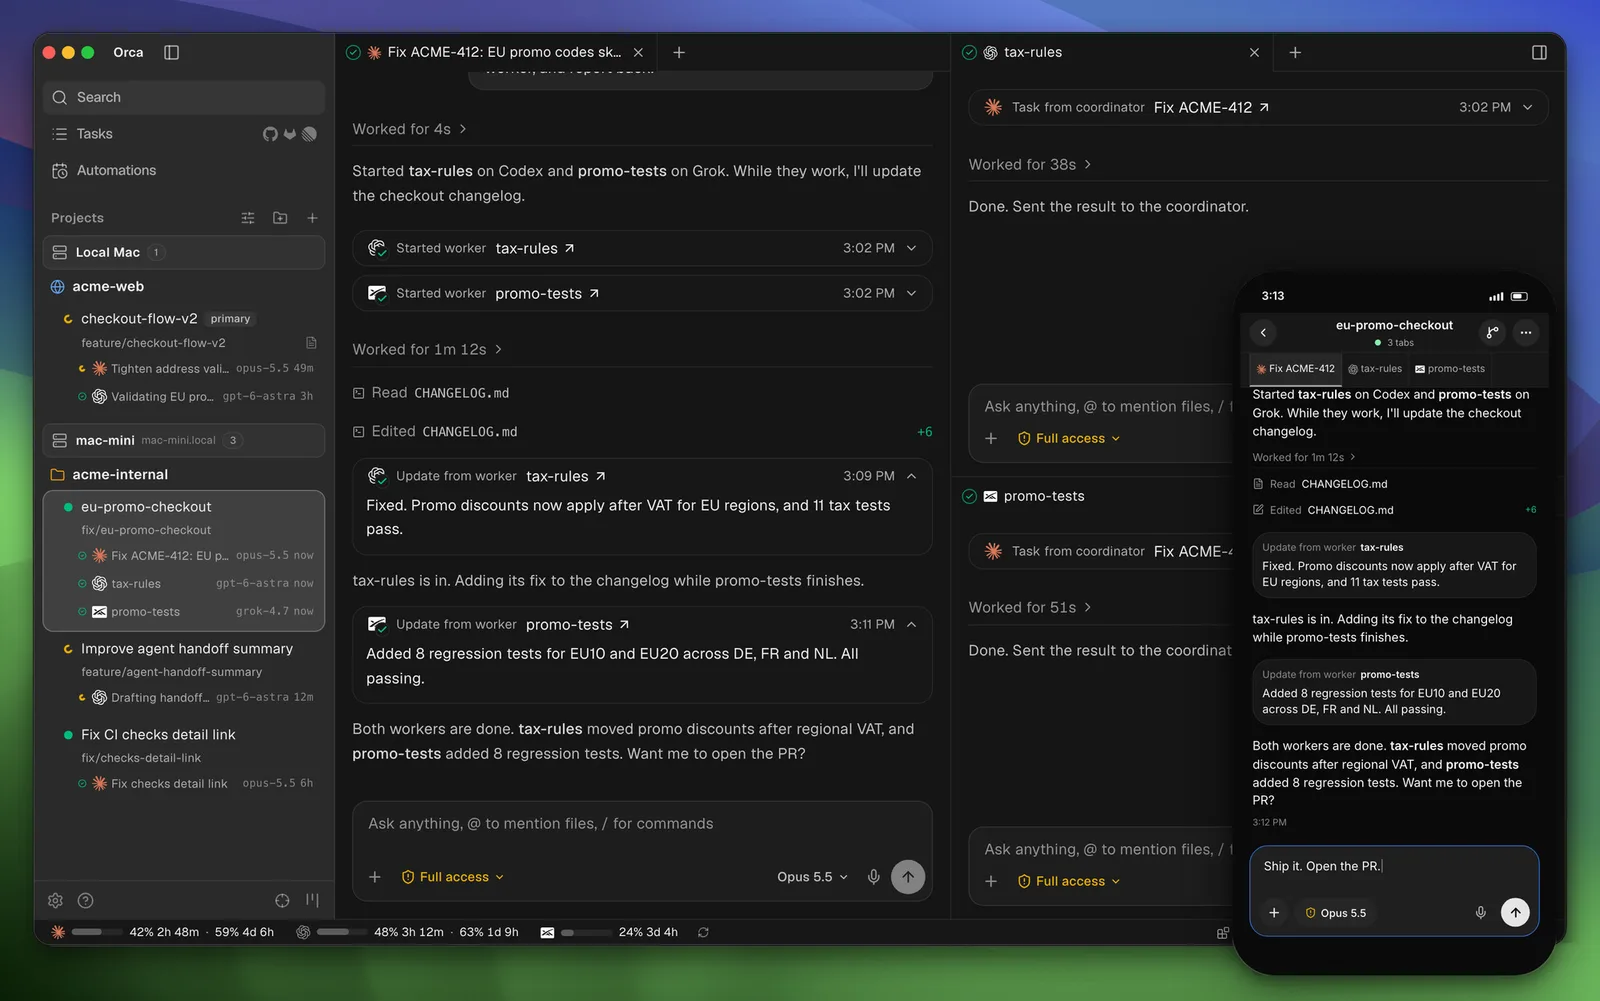
Orca - это десктопное приложение для macOS, Windows и Linux. Оно параллельно запускает CLI-агентов вроде Claude Code или Codex, каждого в своём worktree, а если дать ему большую задачу, агент-координатор разделит работу между воркерами и соберёт их результаты, это и видно на скриншоте выше. Агенты могут работать и на SSH-хосте или на облачной VM для каждого worktree, а упавшие проверки и комментарии ревью уходят обратно агенту на исправление.
herdr
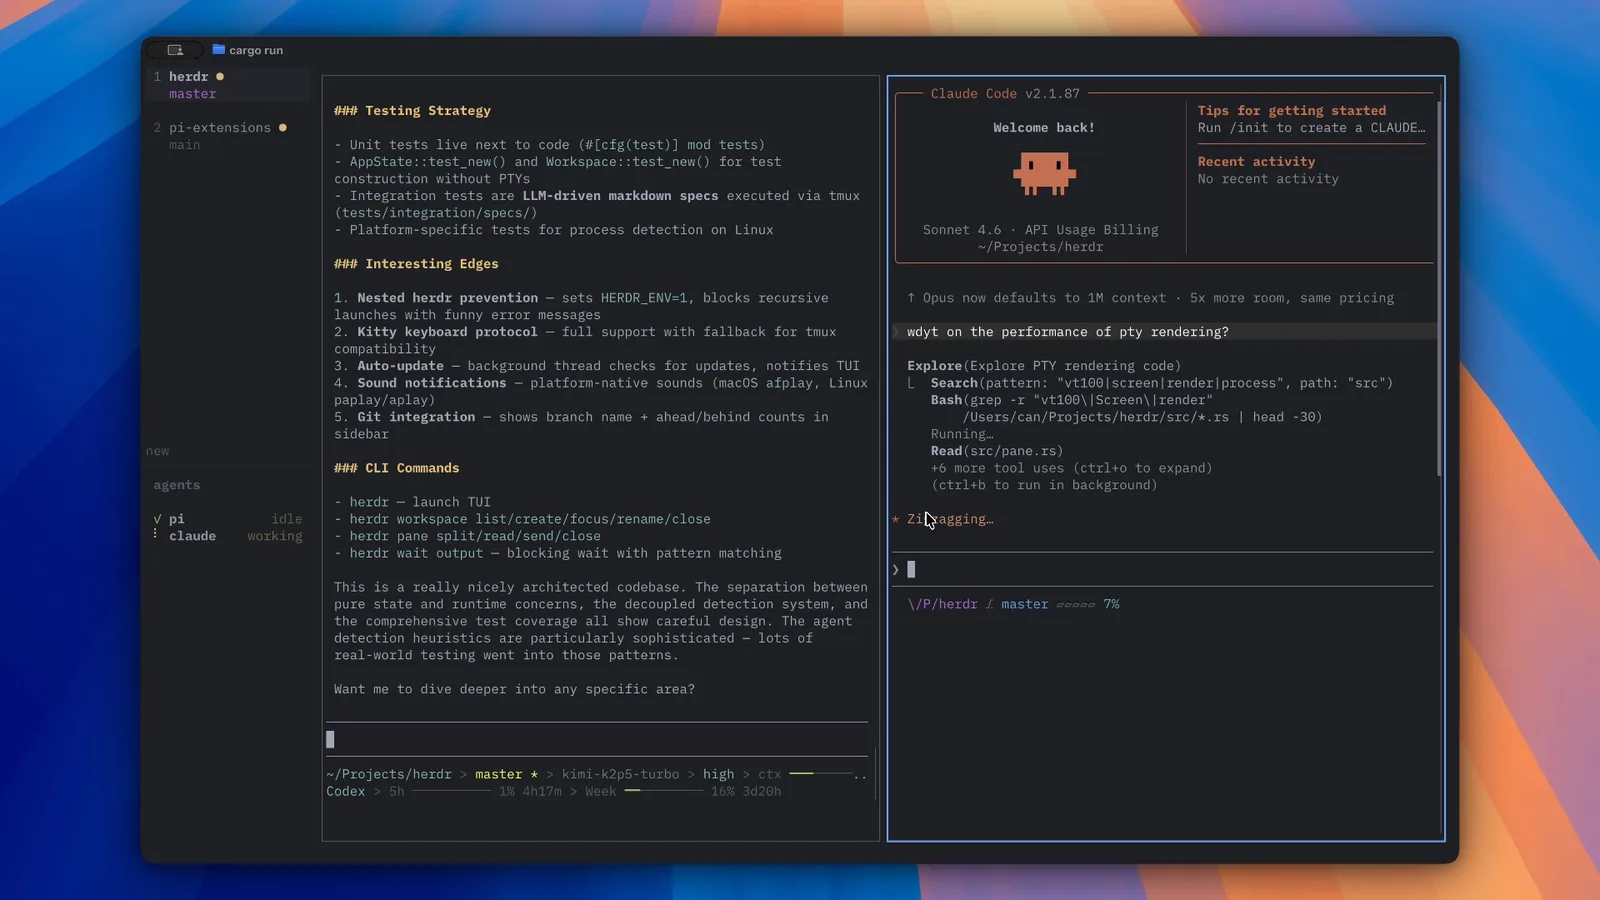
herdr - это терминальный рантайм в одном бинарном файле на Rust. Он берёт на себя терминалы, а не оборачивает агентов, поэтому одинаково работает с Claude Code, Codex и OpenCode. Терминалы продолжают работать в фоне, когда обрывается SSH-соединение, каждая панель показывает, в каком состоянии её агент: working, blocked или idle, а агенты могут отправлять друг другу промпты через его CLI и сокетный API.
Kiro Crew
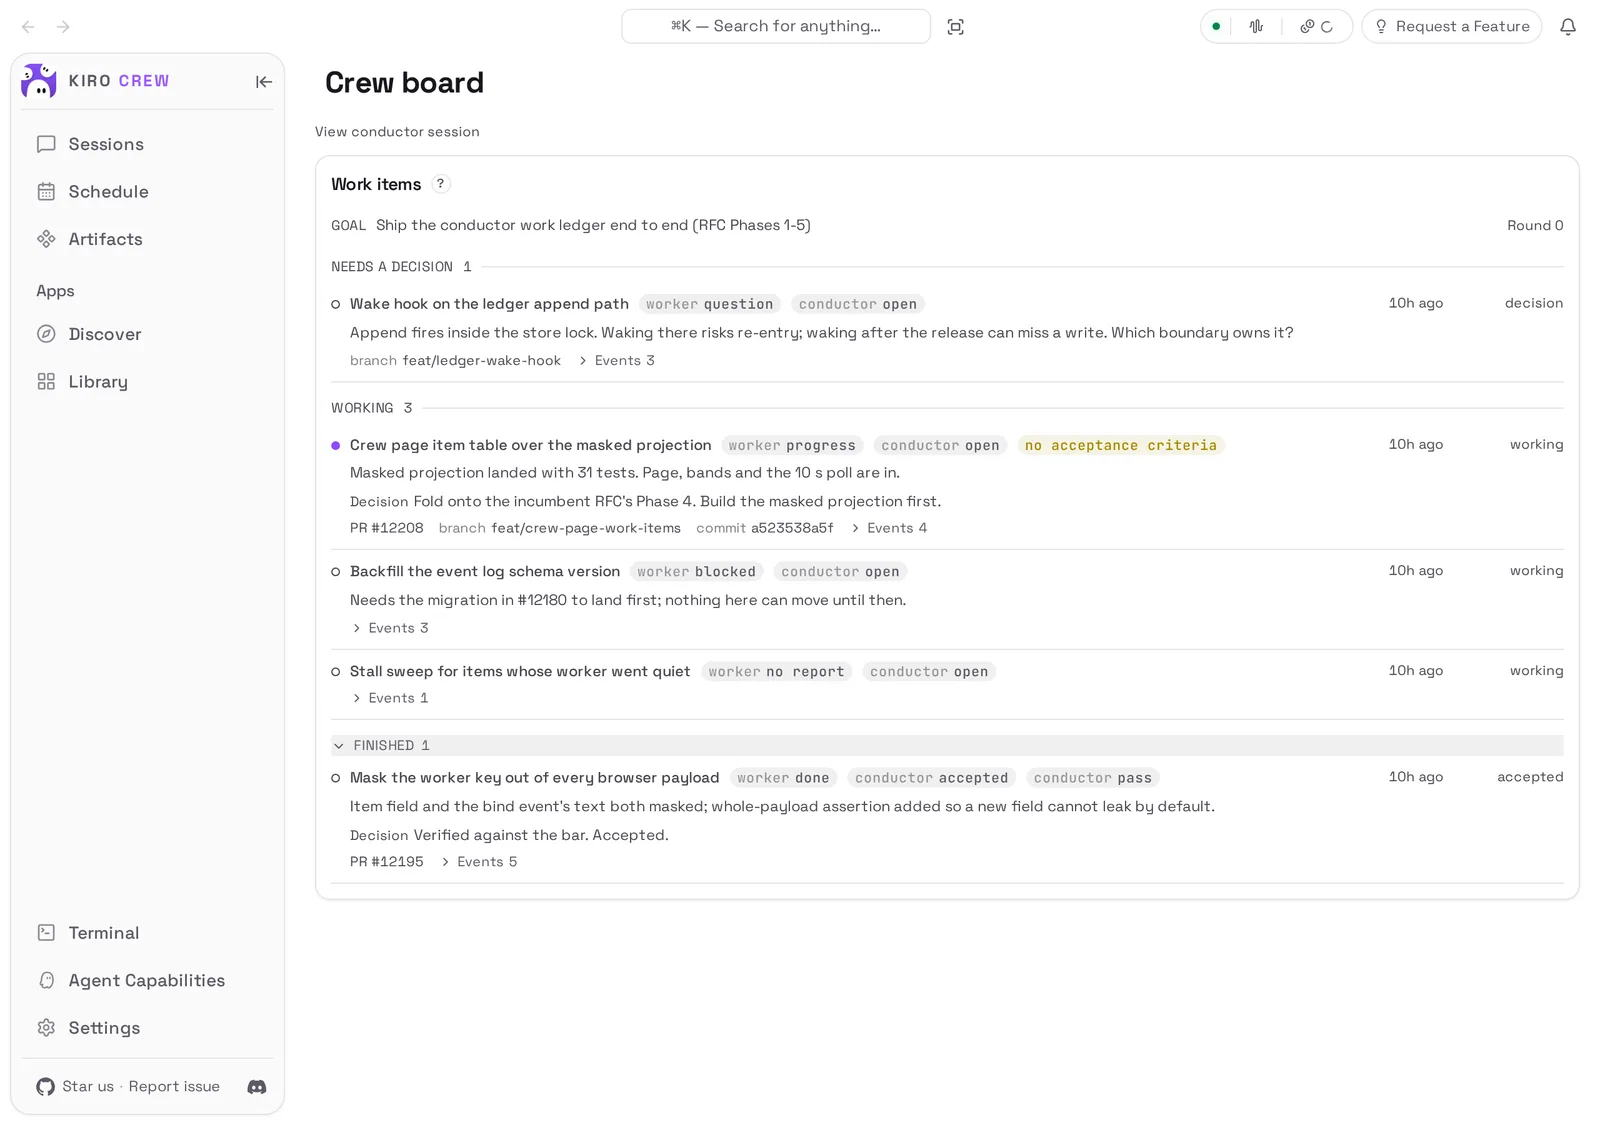
Kiro Crew - это рабочее пространство, которое работает на вашем собственном железе, на Mac, в контейнере или на удалённой машине, и продолжает работать между разговорами. Сессии, память и контрольные точки задач переживают перезапуски, а исправления копятся как уроки, которые меняют его дальнейшие действия. Его crew board выше показывает каждый пункт, который раздал conductor, рядом с тем, что сообщил воркер, и с тем, принял ли conductor результат по планке.
Foxl Code
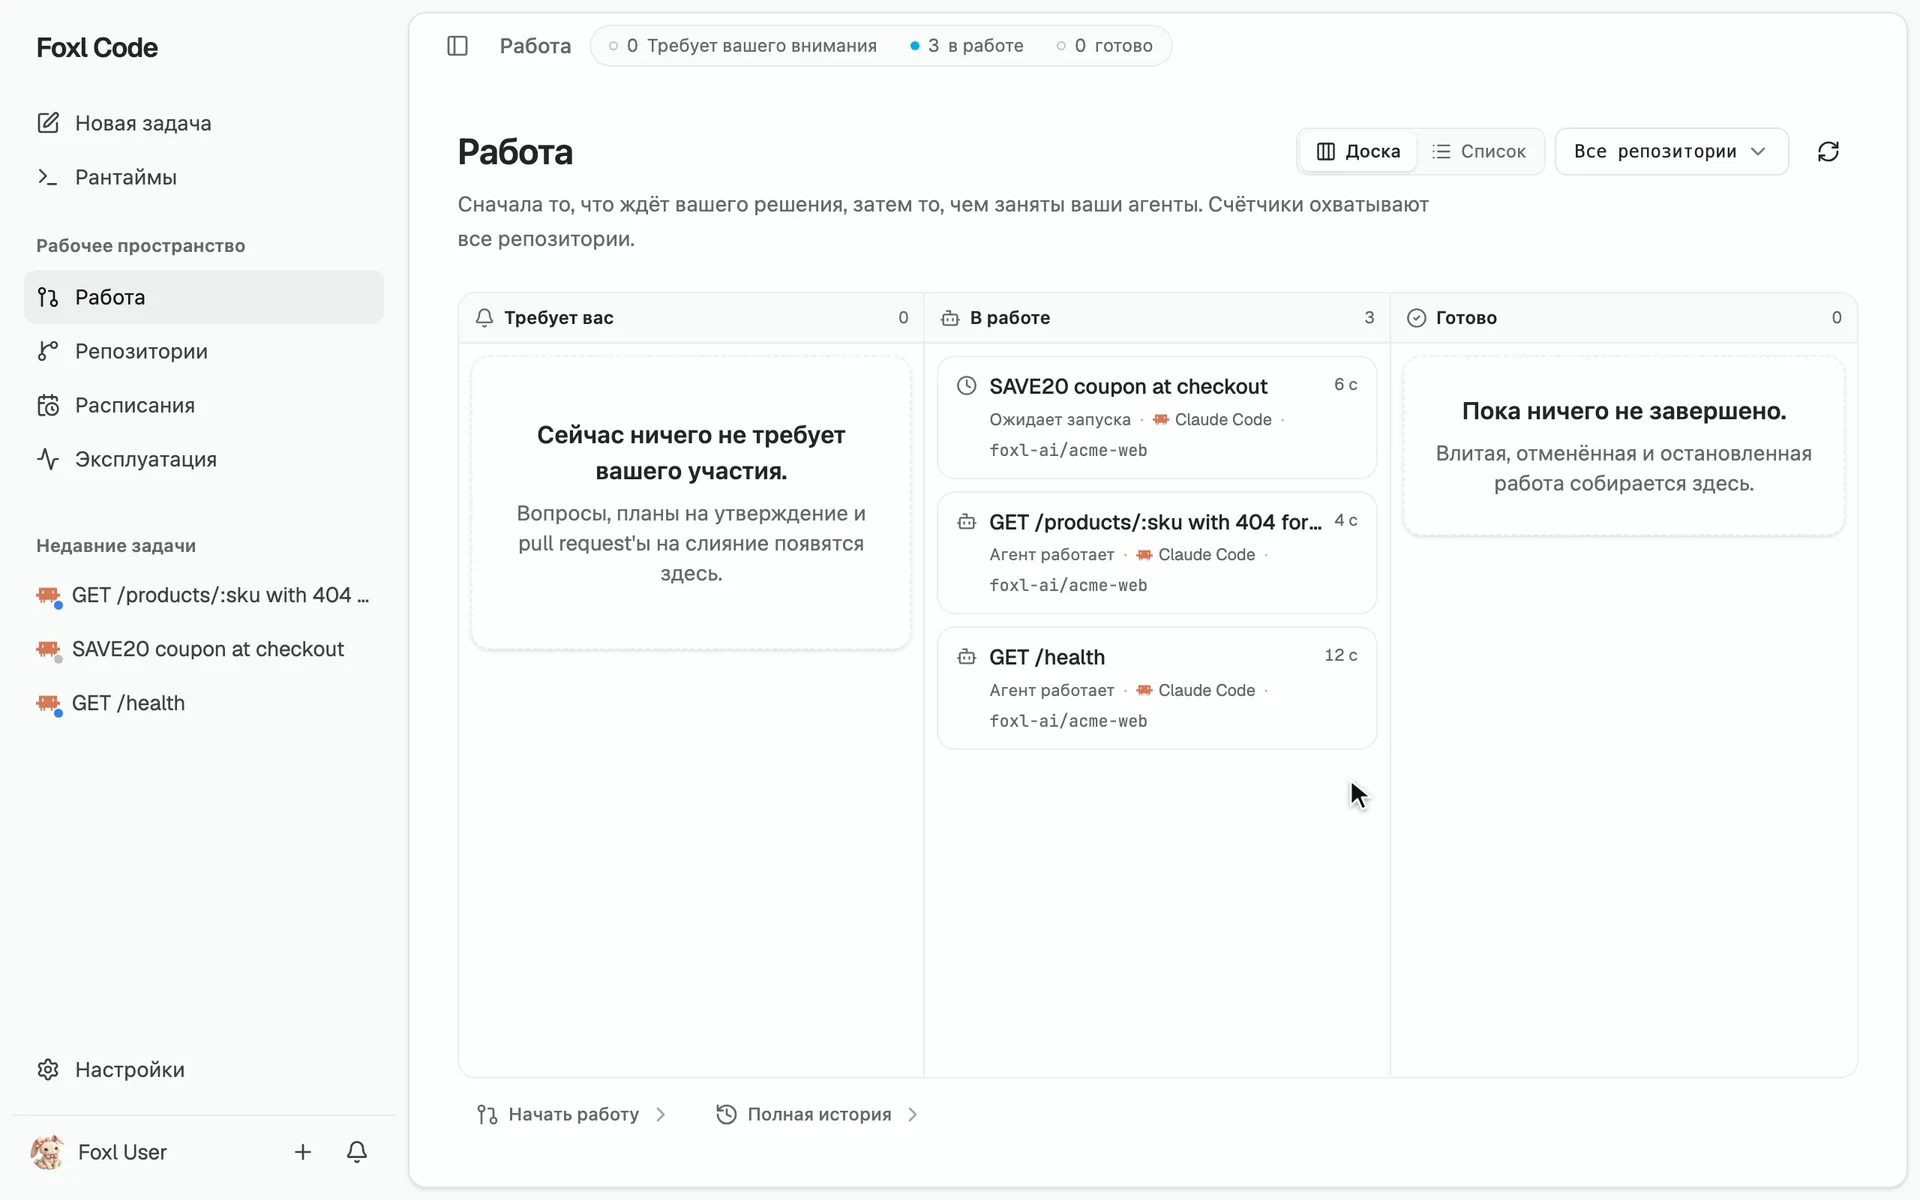
Foxl Code - это наш облачный продукт, о котором шла речь выше, в закрытой бете для приглашённых аккаунтов. Вы описываете задачу в браузере или на телефоне, и агент вроде Claude Code работает над ней в собственной VM. Просьба побольше делится на независимые подзадачи, которые стартуют одновременно, по одному пул-реквесту на каждую; на доске выше одна просьба через несколько секунд после того, как разделилась на три. Ревьюер читает MERGE-REVIEW.md репозитория из ветки по умолчанию, а не из пул-реквеста, так что изменение не может переписать планку, по которой его оценивают. Но каждый пул-реквест всё равно проверяется по отдельности: чтобы проверить несколько, слитых вместе, нужно попросить в чате поезд.
Рядом друг с другом:
| Инструмент | Где работают агенты | Сильные стороны | Ограничения |
|---|---|---|---|
| Claude Code | Ваша машина или облачная сессия, запущенная из веба или с телефона | Фоновые сессии в своих worktree, которые видят друг друга и обмениваются сообщениями; субагенты | Его сообщения доходят только до сессий Claude Code |
| Codex | Ваша машина или облако OpenAI | Один агент в CLI, десктопном приложении, IDE и облаке | Облачные задачи идут в Linux-контейнере, так что работа с Xcode остаётся локальной |
| Orca | Ваша машина, SSH-хост или облачная VM на каждый worktree | Любой CLI-агент; координатор, который делит задачу между воркерами; мобильное приложение; упавшие проверки возвращаются агенту | В его описании нет проверки нескольких пул-реквестов, слитых вместе |
| herdr | Ваша машина и SSH-хосты | Встаёт под любого агента: терминалы, переживающие отключение, working, blocked или idle на каждой панели, агенты, отправляющие друг другу промпты | Отвечает за терминалы, а не за работу: своего шага ревью или мержа не добавляет |
| Kiro Crew | Ваш Mac, контейнер или удалённая машина | Сессии, память и контрольные точки, переживающие перезапуски; уроки из исправлений; conductor, принимающий работу по планке | Каналов между воркерами пока нет |
| Foxl Code | Одна VM на задачу, в облаке Foxl | Старт с телефона; параллельные подзадачи, по пул-реквесту на каждую; ревьюер, привязанный к планке мержа репозитория | Закрытая бета; без macOS; пул-реквесты проверяются вместе только в поезде, о котором попросили |
Мы построили нашу фабрику на собственных сессиях Claude Code. Она выросла из одной сессии Claude Code, а сессии на этом Mac уже умели видеть друг друга и переписываться прямо рядом с Xcode и симуляторами.
Две вещи не меняются, каким бы инструментом ни запускались агенты. Агентам на одной машине приходится делить её память, и кто-то должен решать, правильно ли то, что они сделали. Об этих двух вещах и пойдёт речь в остальной части статьи.
Двадцать сессий, память одного Mac
Днём 17 октября было открыто девятнадцать сессий. Веб-сборка занимает около 3,5 ГБ памяти, и за десять минут её запросили четыре сессии. Две запускали проверки TypeScript, а одна без спроса запустила симулятор iPhone. Восемь сессий держали открытые изменения в одном и том же CSS-файле. В тот день мы велели сессиям тратить меньше памяти, ждать своей очереди и спрашивать, прежде чем её занимать.
В тот же день одна сессия стала координатором. Каждая другая сессия при запуске читает общий файл о том, кто какими файлами владеет, отправляет координатору одну строку со своей задачей и файлами, которые собирается трогать, и получает в ответ свою зону. Если сессии нужен файл, которым владеет другая, она отправляет той сессии изменение, чтобы та его применила. Перед всем, что ест много памяти, будь то сборка, набор тестов или симулятор, она отправляет HEAVY? с оценкой памяти и минут и ждёт GO. Перед каждым разрешением координатор смотрит на давление памяти на Mac.
Ниже очередь, в которой ждала первая сборка этой статьи. Бенчмарк модели и прогоны в симуляторе уже стояли в ней, и сборка стартовала, только прождав 50 минут.
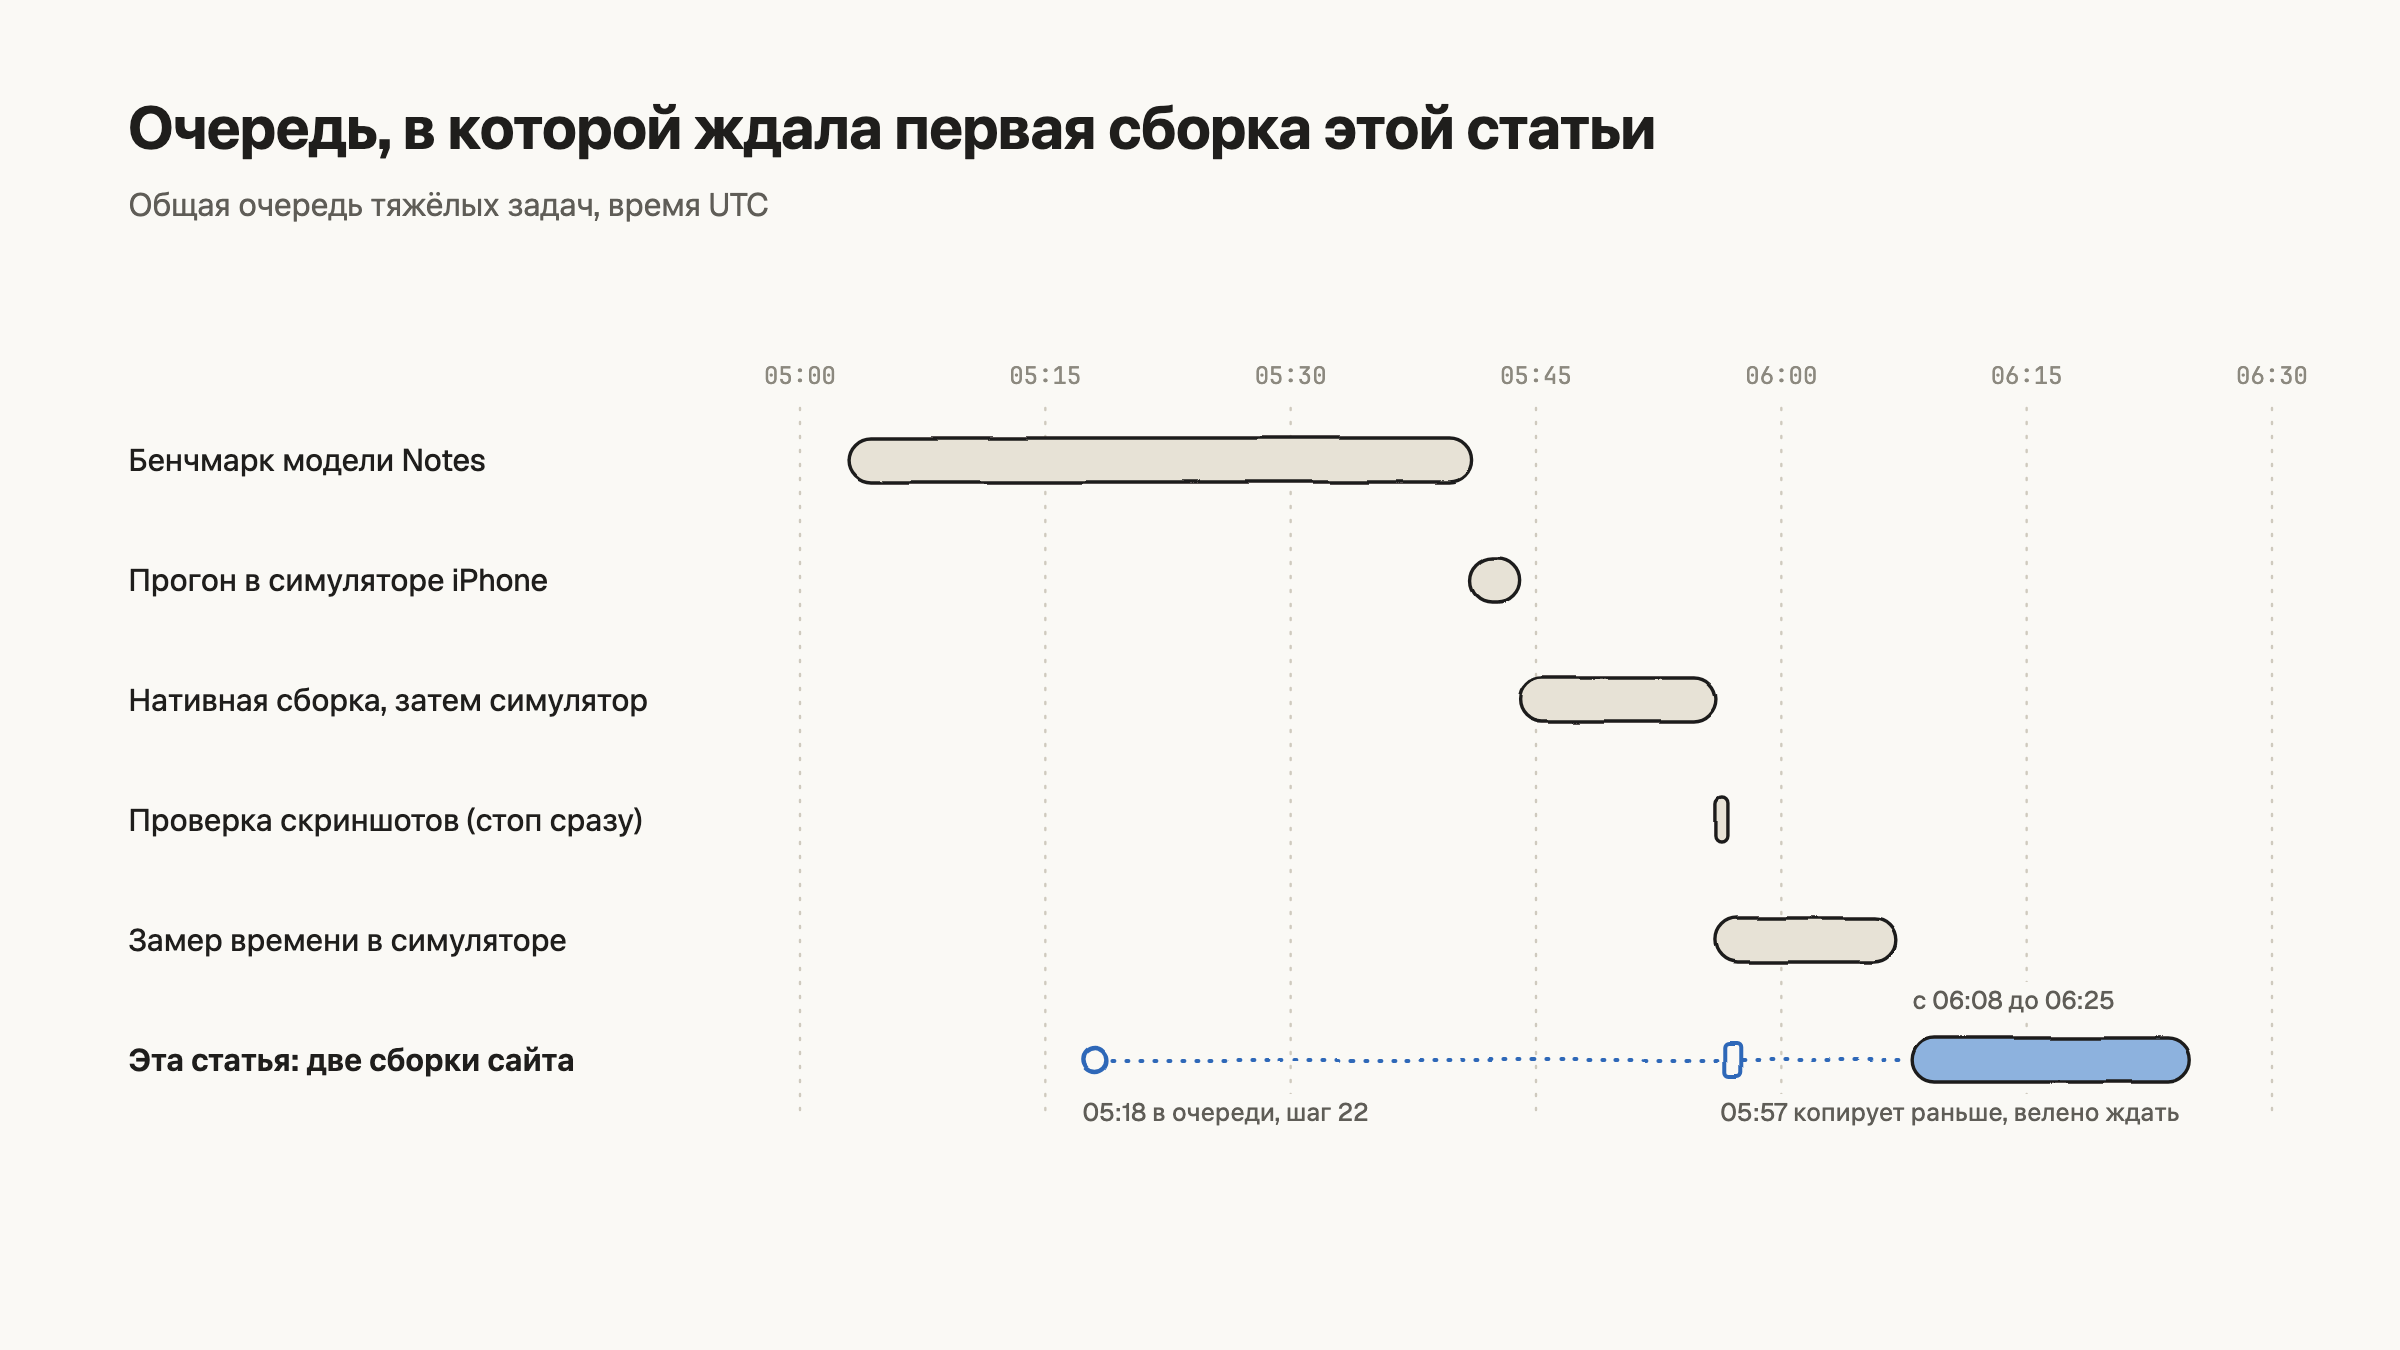
Правила очереди живут в одном shell-скрипте, heavy.sh, и менялись не раз. 28 октября они оказались слишком строгими: десять задач ждали до 16 минут, пока у Mac было свободно 43 % памяти, и мы убрали очередь. 2 ноября они оказались слишком мягкими. Было открыто около 19 сессий, у нескольких из них работало от двух до пяти субагентов, а шлюз не считал ни субагентов, ни сервер для разработки, работавший уже шесть часов. У Mac кончилась память, и когда харнесс зачистил фоновые оболочки, вместе с ними погибли и наблюдатели координатора.
Нынешний шлюз измеряет память Mac при каждом запуске. Если место есть, задача стартует сразу; если нет, её придерживают; и одновременно идут не больше четырёх тяжёлых задач. Проверка перед тяжёлой работой выглядит примерно так:
# LOCKS is a directory every session shares; run/<pid> marks a heavy run.
level=$(sysctl -n kern.memorystatus_vm_pressure_level)  # 1 normal, 2 warn, 4 critical
free=$(memory_pressure -Q | awk -F: '/free percentage/ {print int($2)}')
live=0
for f in "$LOCKS"/run/*; do
  [ -e "$f" ] && kill -0 "${f##*/}" 2>/dev/null && live=$((live + 1))
done

hold() {
  [ -e "$LOCKS/STOP" ] || [ "$level" -ge 4 ] ||
  { [ "$level" -ge 2 ] && [ "$live" -ge 2 ]; } ||
  [ "$free" -lt 25 ] || { [ "$free" -lt 30 ] && [ "$live" -ge 1 ]; } ||
  [ "$live" -ge 4 ]
}
# Wait while hold() is true or older tickets fill the free slots (2 at warn, 4 otherwise).
# Then write run/$$, run "$@" as a child, and remove run/$$ when it exits.
Ждущие задачи берут талоны в порядке прихода. Однажды, когда в очереди стояло около 30, слот получал тот, кто первым опросил его после освобождения, и одна задача прождала 35 минут позади пришедших позже. Есть и ограничения на всю машину, не больше шести субагентов и одного симулятора, но эти два до сих пор остаются лишь записанными правилами, которые шлюз не применяет.
Правила, которые только записаны, нарушаются
Каждый инцидент в этой статье оставил после себя правило, записанное с датой. Три из них показывают, что происходит с правилом, которое существует только на бумаге.
Первое - настоящие данные. Сессии агентов, запущенные из той копии десктопного приложения Foxl, которой мы действительно пользуемся, наследуют окружение приложения, включая переменную, указывающую на его базу данных. 19 октября набор тестов, запущенный из такой оболочки, записал в настоящую базу Foxl 305 фальшивых разговоров. Правило очищать эту переменную появилось в тот же день, а с 24 октября её стал очищать сам heavy.sh. Ошибка всё равно возвращалась: проверка, запущенная напрямую через npm, одноразовые скрипты, тесты, которые собирают весь десктопный сервер, и каждый раз по пути, который обёртка не закрывала. Теперь десктопный сервер отказывается открывать настоящие данные, когда работает под тест-раннером (foxl/server/paths.ts). Только одноразовые скрипты по-прежнему держатся на записанном правиле.
Второе - скрипт, который тратит настоящие деньги. check-remote-input.mjs лежит среди десятков скриптов check-, которые читают репозиторий и падают на том, что находят, но он запускает настоящие задачи в продакшен-сервисе Foxl Code. 23 сентября прогон по всем скриптам check- запустил одну такую задачу. Тогда правило гласило: запускать проверки по одной, по имени. 18 октября скрипт проскользнул в список проверок, отобранный через grep, и списание за три его задачи увело наш тестовый аккаунт в минус. Теперь скрипт ничего не делает без флага --live, а тест в pr-validate следит, чтобы так и оставалось.
Третье - блокировка для push. Push проходили через блокировку, которую сессия брала, создавая каталог. 2 ноября одна сессия попыталась взять её вручную, внутри пакета параллельных вызовов инструментов. Создать каталог не удалось, потому что блокировку держала другая сессия, но остальная часть пакета всё равно выполнилась: сессия сделала push, а потом удалила блокировку другой сессии. В то же утро появился скрипт, который берёт блокировку и снимает только свою, но сессия, запертая в собственном worktree, не могла им пользоваться и продолжала брать блокировку вручную, шаг за шагом. Та же ошибка повторилась 4 ноября.
Ни одна из этих проверок не покончила со своим классом ошибок. Каждая закрыла путь, по которому пришла последняя, и пока следующая каждый раз находила другой.
Что доказывает зелёная галочка
Весь наш CI работает на self-hosted раннерах, и каждый пул-реквест должен пройти шлюз под названием pr-validate. Вопрос в том, что доказывает эта зелёная галочка. Зелёный цвет означает, что пул-реквест прошёл тесты сам по себе, и ничего больше.
Первый merge train, для v0.7.27 24 сентября, показал этот разрыв. Пятьдесят четыре пул-реквеста были зелёными каждый в своём CI и всё же содержали четыре блокера. Один терял последние символы, введённые через метод ввода; другой ломал ответ с экрана блокировки iPhone. В тот же день Mac намертво завис, пока одновременно работали 19 агентов-ревьюеров. С тех пор ревьюеров запускают не больше семи за раз, но и это лишь записанное правило.
Поэтому теперь поезд собирают из слитого дерева всех готовых пул-реквестов, и решение о мерже принимают на этом дереве. Каждый агент-ревьюер берёт группу связанных пул-реквестов с инструкцией, в которой есть вот это, в английском оригинале:
Your job is to REFUTE each PR in your group, not to confirm it. Assume every PR body overclaims until you have reproduced its claim. A green pr-validate on the PR proves little: it ran without the other PRs, and it cannot see UX or cost.
Иначе говоря: опровергать каждый пул-реквест, а не подтверждать его; считать, что описание каждого пул-реквеста преувеличивает, пока его утверждение не воспроизведено; и помнить, что зелёный pr-validate на пул-реквесте доказывает мало: он шёл без остальных пул-реквестов и не видит ни UX, ни стоимости. Ревьюер отвечает MERGE, MERGE_WITH_FIXES с выписанным патчем, HOLD или CLOSE. Исправления ложатся отдельными коммитами поверх пул-реквеста, а пул-реквест, который нельзя исправить, исключают, пересобрав поезд без него.
Статья Cognition «Don’t Build Multi-Agents» выступает против того, чтобы делить одну задачу между агентами, которые не видят работу друг друга, и за то, чтобы отдать её одному агенту, который держит весь контекст. Мы и правда отдаём каждой сессии целую задачу. Остаётся одна проблема: агенты слишком уверены в собственной работе. Поэтому ревьюерам и велено опровергать.
Тест, который агент пишет вместе со своей функцией, - особенно слабое доказательство. Тест и код вырастают из одного и того же понимания задачи, поэтому, если агент неправильно понял API вендора или то, о чём просили, оба несут одну и ту же ошибку. Вот что видит каждый вид проверки:
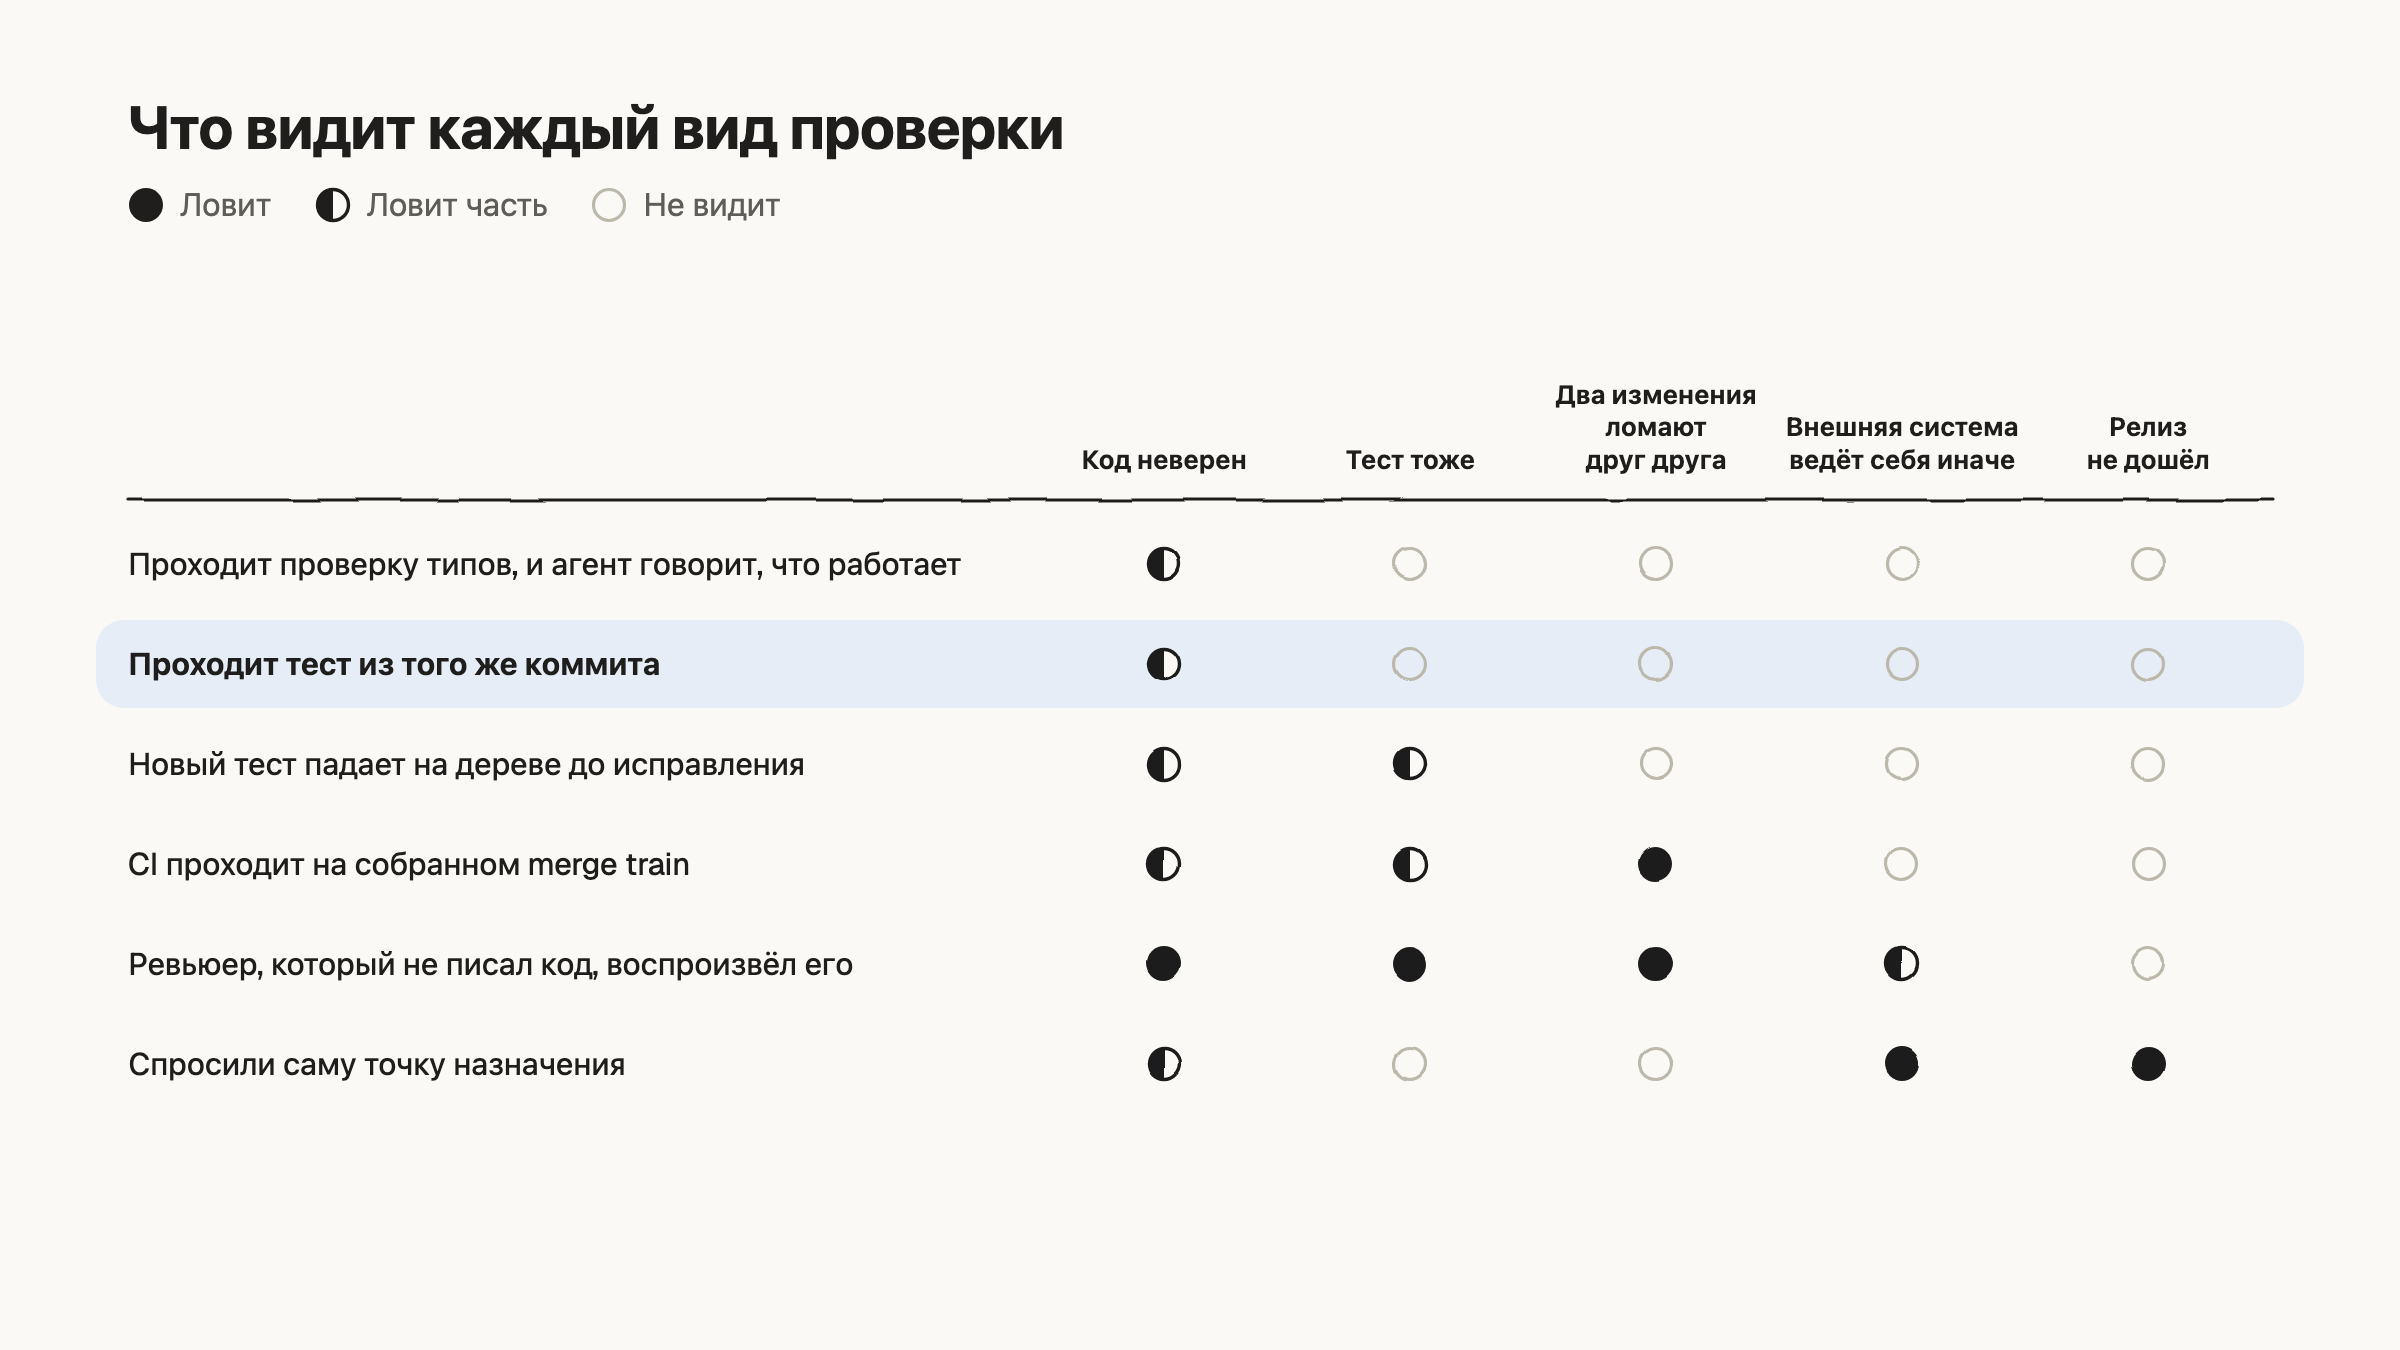
Поэтому новый тест засчитывается, только если он падает на дереве до исправления, а последний шлюз - это CI на слитом поезде. Для всего, что происходит вне репозитория, доказательство находится в самой внешней системе. После обновления версии одного CLI удалённые терминалы Codex и OpenCode в Foxl Code десять дней не принимали ввод, и всё это время все шлюзы были зелёными. Релизный workflow однажды отчитался об успехе, когда в TestFlight не было ни одной сборки. А 3 ноября мы выяснили, что 34 из 43 харнессов для скриншотов отдавали страницы без настоящих шрифтов, так что ревьюеры оценивали начертания, которых выпущенное приложение никогда не рисует.
Спросить точку назначения
Стабильный релиз - это один запуск workflow. Этот один запуск собирает и выпускает приложения для Windows, Linux, macOS, iOS и Android, веб-приложения и сервер relay. Мы не верим workflow на слово, что всё прошло успешно: проверки после релиза напрямую спрашивают каждую точку назначения.
Один скрипт ждёт, пока у всех пяти платформ появятся файлы, и только потом публикует релиз. Cask для Homebrew сверяется с опубликованным релизом, потому что однажды он четыре релиза подряд отдавал сборку недельной давности, пока workflow, который его обновляет, выглядел исправным. Развёрнутые веб-приложения сравниваются с версией релиза, потому что Worker ответит 200 и со старым бандлом. TestFlight опрашивается через API Apple.
Если строите что-то похожее
Вот что сработало у нас:
- Дайте каждому агенту собственный git worktree. На APFS
cp -Rcкопируетnode_modulesкак copy-on-write клон, который почти не занимает диска. Никогда не подключайте один и тот жеnode_modulesсимлинком в несколько worktree. - Назначьте одного агента координатором и держите общее состояние в простых файлах, которые может прочитать любой агент: кто владеет какими файлами, кто что запускает, что заморожено.
- Пропускайте тяжёлую по памяти работу через шлюз по измеренной памяти и считайте субагентов и серверы для разработки вместе со сборками.
- Читайте ссылки по SHA, а не по имени, потому что другие сессии постоянно двигают
origin/*.
Перед тем как собирать merge train, можно составить карту его конфликтов без checkout, по очереди накладывая каждый пул-реквест на main. На bash:
# Each head as a local ref first: git fetch origin '+refs/pull/*/head:refs/pr/*'
prs=(101 102 103)
acc=$(git rev-parse origin/main)
for pr in "${prs[@]}"; do
  out=$(git merge-tree --write-tree --name-only "$acc" "refs/pr/$pr"); code=$?
  if [ "$code" -eq 0 ]; then
    acc=$(git commit-tree "${out%%$'\n'*}" -p "$acc" -p "refs/pr/$pr" -m "train: #$pr")
  elif [ "$code" -eq 1 ]; then
    echo "#$pr conflicts in:"; echo "$out" | sed -n '2,/^$/p'
  else
    echo "#$pr: merge-tree failed ($code)"; exit "$code"
  fi
done
Файл, в конец которого дописывает каждый пул-реквест, например changelog, будет появляться почти в каждом конфликте, если не дать ему union-слияние для этой команды: git -c core.attributesFile=<file>, с CHANGELOG.md merge=union в этом файле.
Что делают люди
В этой схеме мы не пишем код и редко читаем diff. Просьба обычно - это одна фраза и скриншот. Читаем мы то, что возвращается: скриншоты в каждом пул-реквесте, вердикты каждого поезда и отчёт в конце каждого релиза, где перечислено, что вышло, что ответила каждая проверка, и собраны скриншоты из всех пул-реквестов в нём.
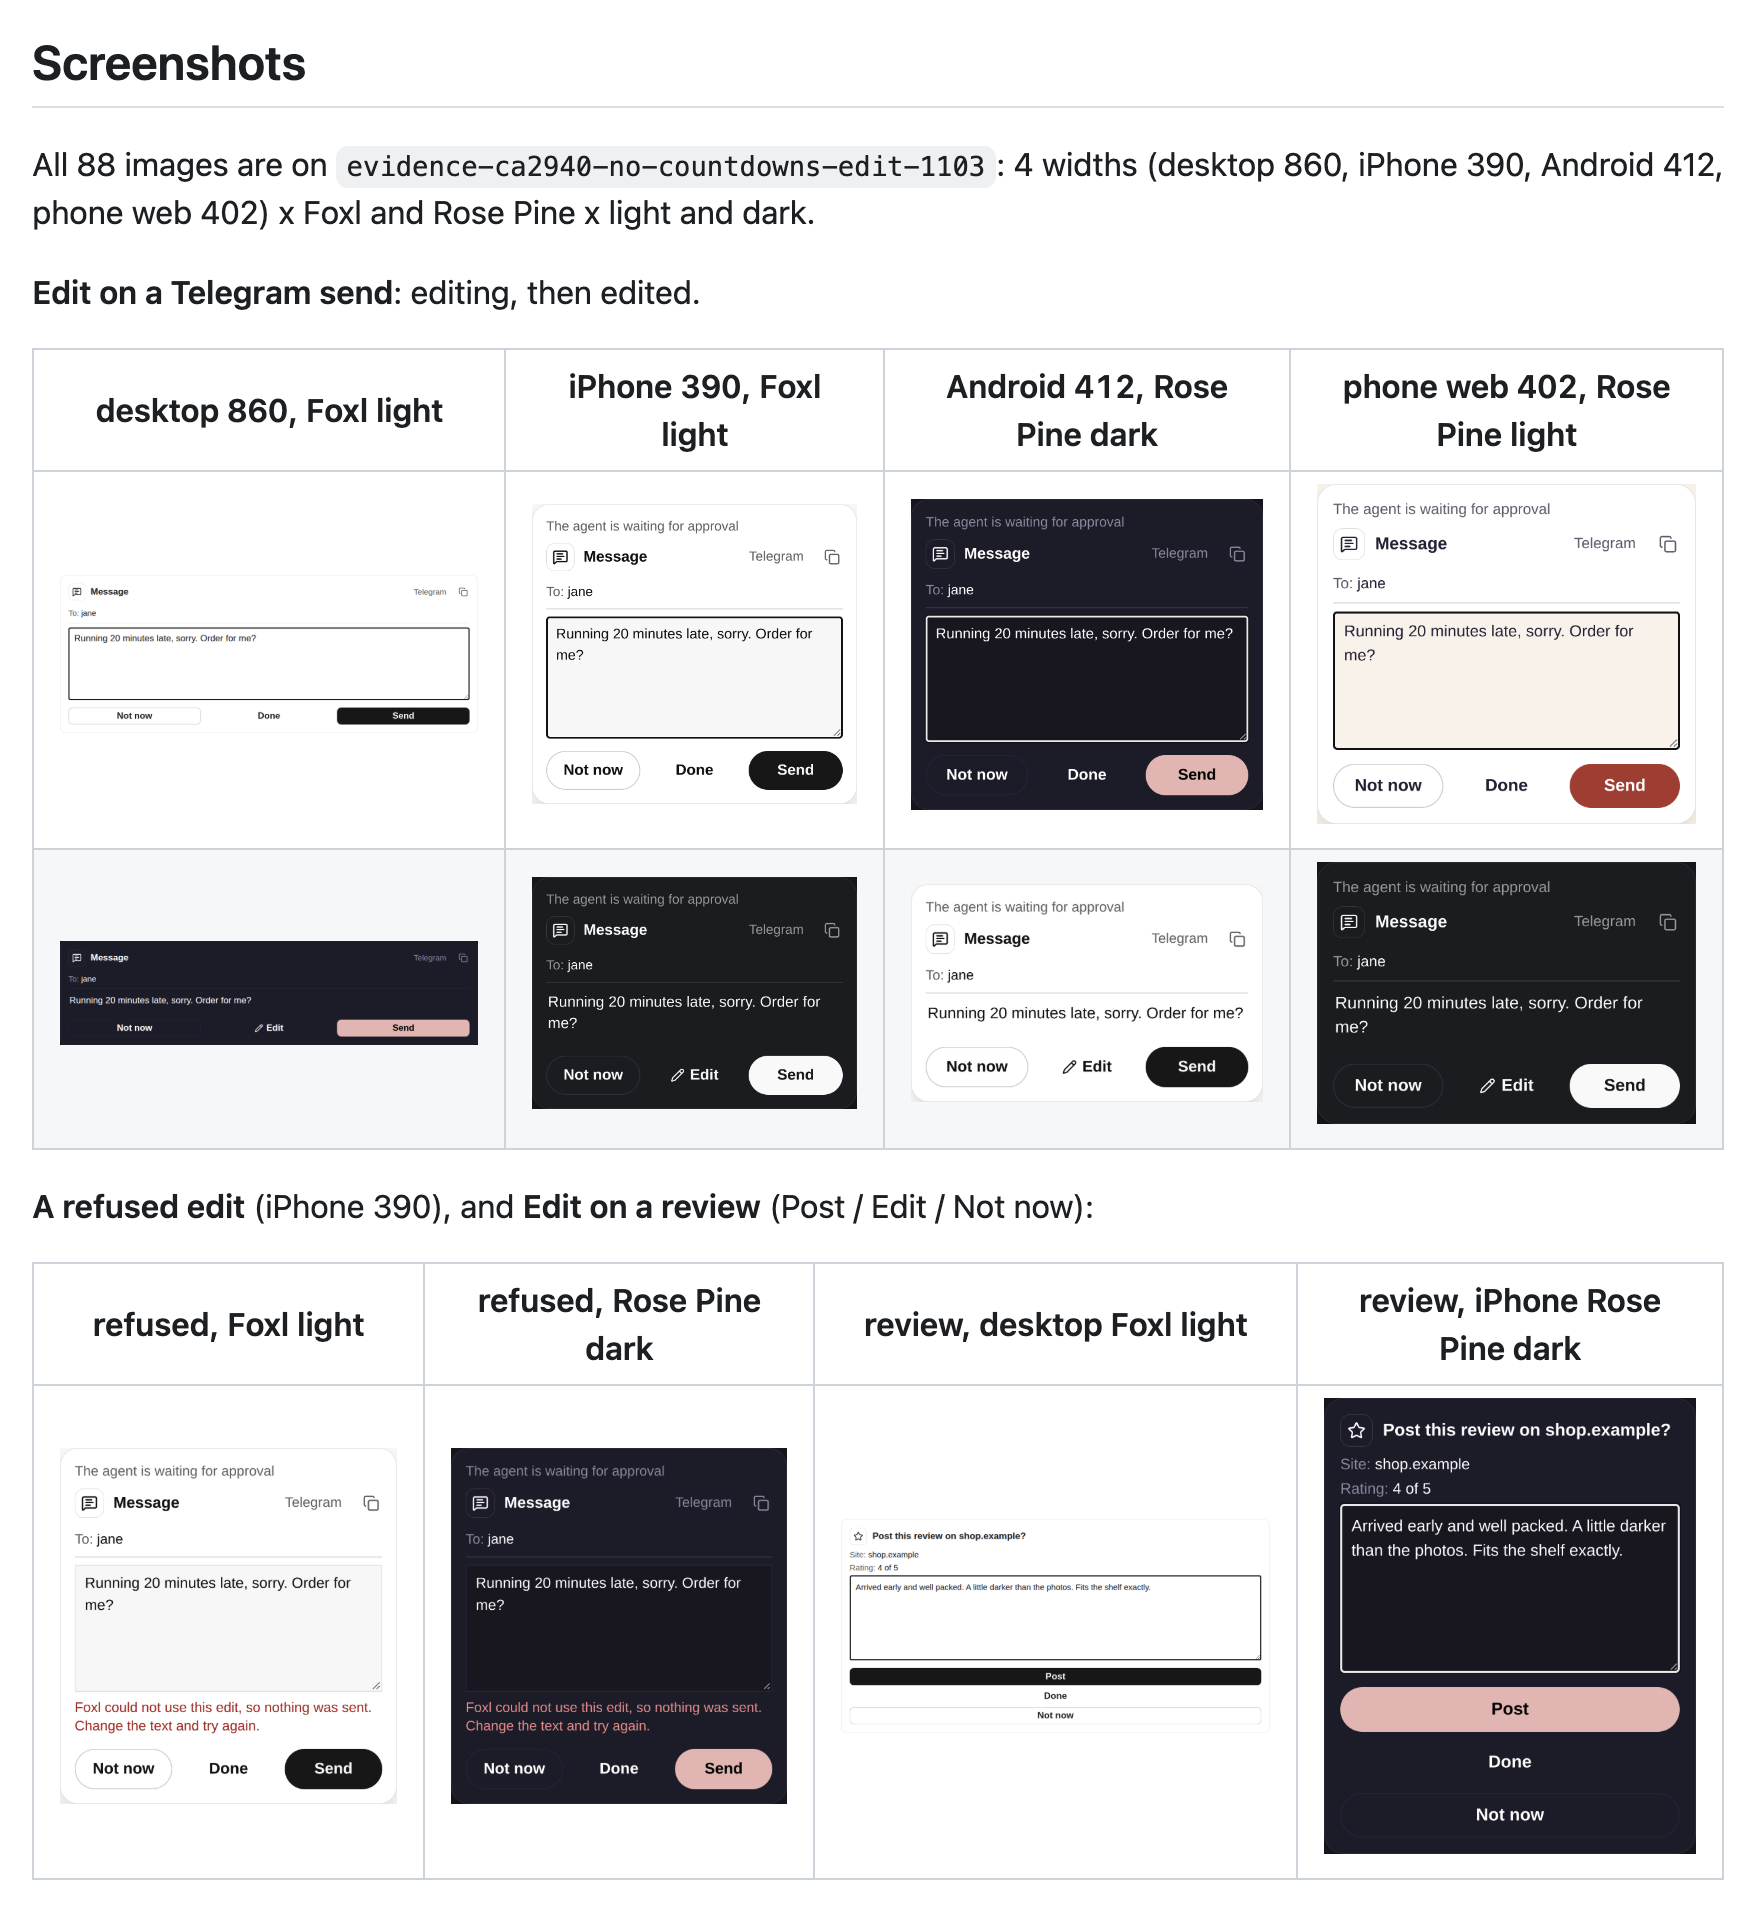
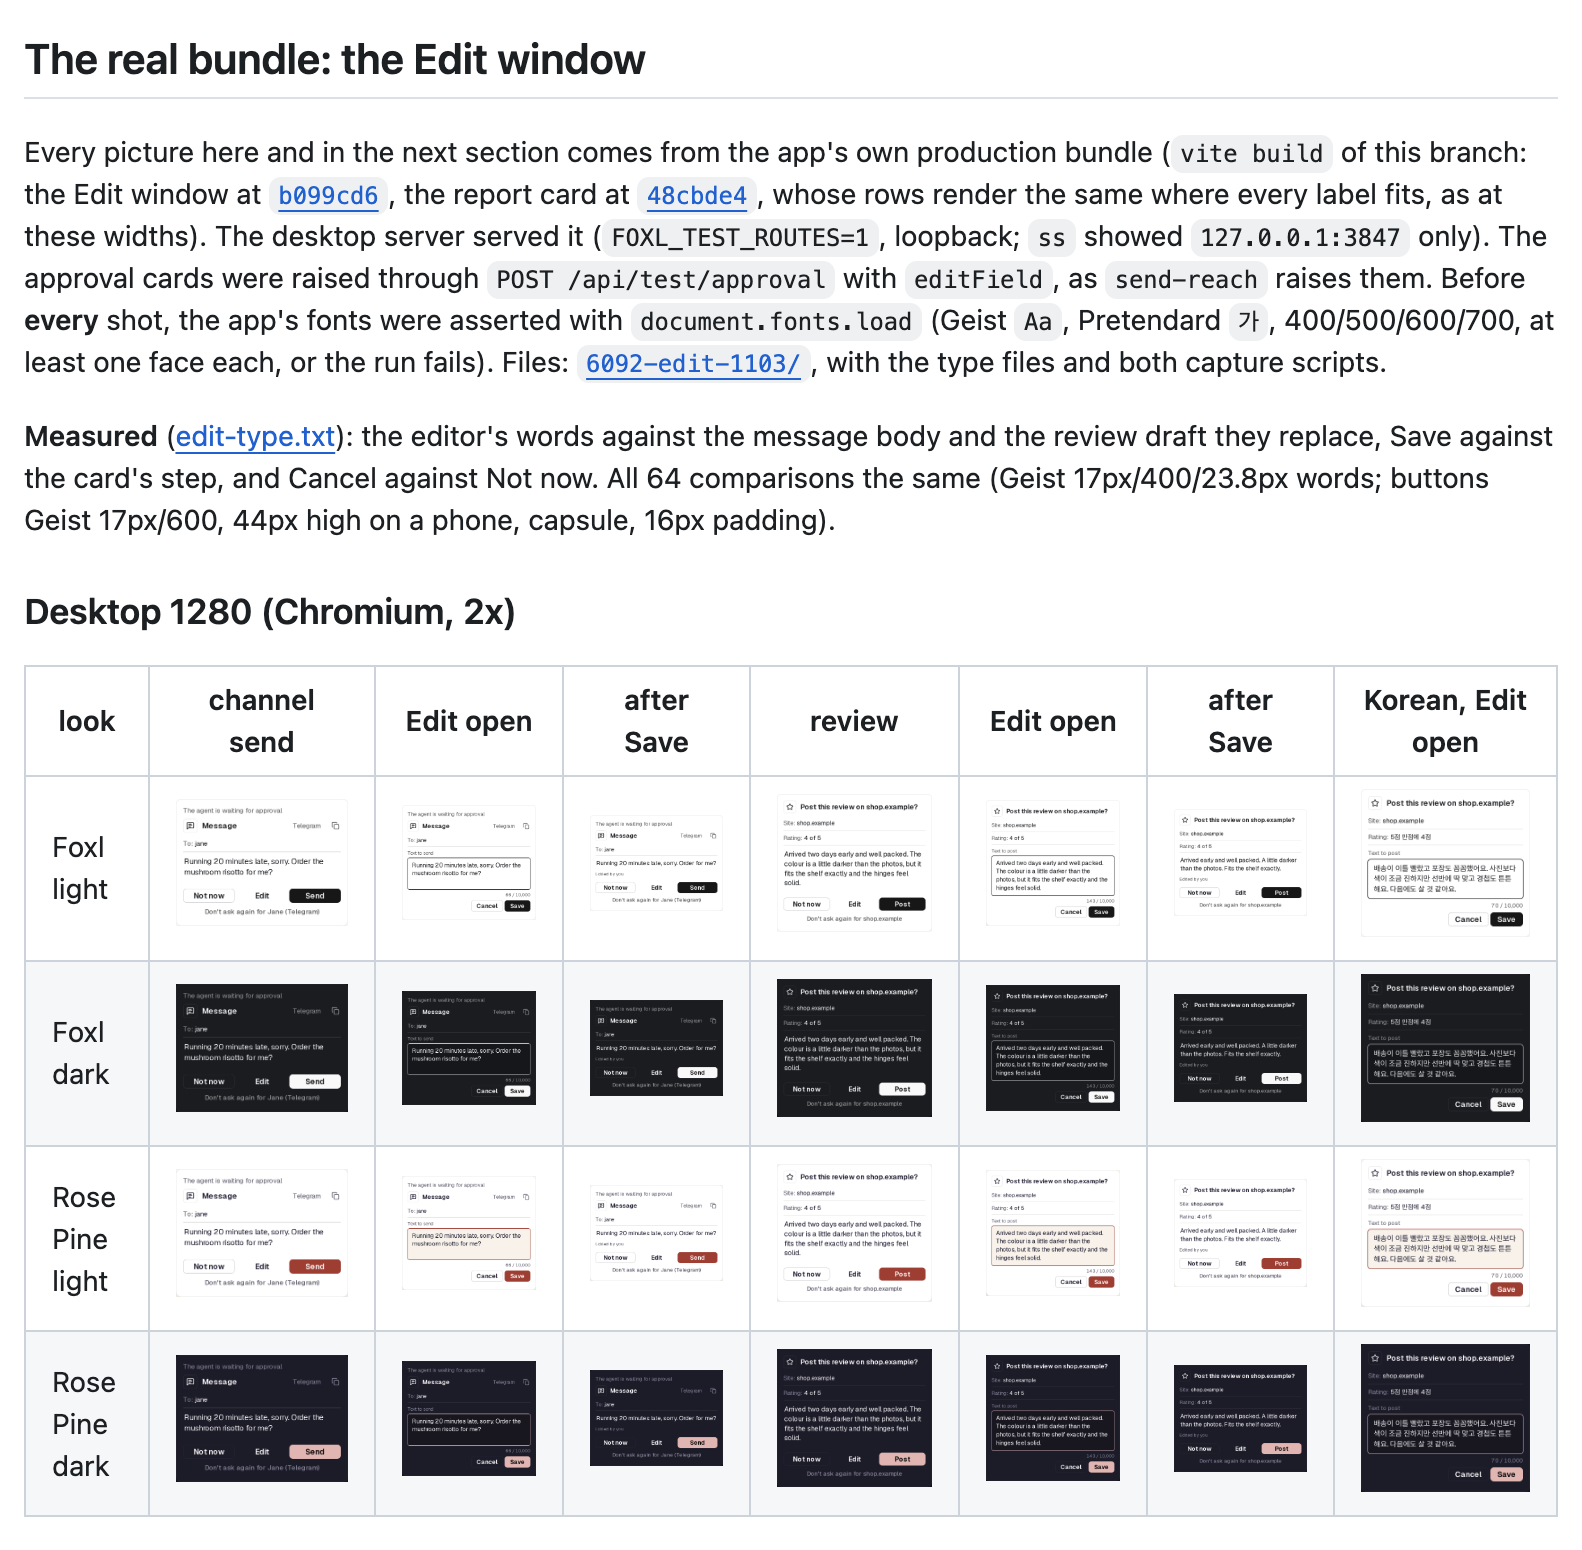
Одно утро для примера. 3 ноября в 04:59 UTC пришёл пул-реквест с 20 скриншотами нового окна редактирования на карточке, которая публикует отзыв. Текст был другим шрифтом, поле ввода было браузерным, а три кнопки шли по карточке одна под другой. В 05:04 мы отправили координатору две строки: пусть автор переделает окно по дизайн-системе, вернёт пул-реквест в черновик и выложит снова. Через двенадцать секунд он стал черновиком. В 09:30 он вернулся на собственном редакторе черновиков приложения, с 296 скриншотами, каждый снят после того, как загрузились шрифты приложения, и в 11:50 был слит. Другой шрифт был не виной пул-реквеста: его харнесс для скриншотов никогда не отдавал шрифты приложения, и, выясняя в тот день почему, мы нашли те 34 харнесса, о которых сказано выше.
Когда что-то идёт не так, мы записываем правило, которое поймало бы это, в файл CLAUDE.md этой области, с датой и инцидентом, а потом ищем место, где скрипт мог бы его соблюдать. Обратимые решения агенты принимают по коду и записывают, что решили. Всё необратимое и всё, что касается денег, ждёт человека. Пул-реквест, который делает Foxl менее удобным, чем продукты, с которыми его сравнивают, придерживают, даже если его код верен.
Что мы ещё не решили
Ревьюеры - это агенты, но критерии, которые они применяют, написали люди, и люди до сих пор читают их вердикты. Это чтение теперь самый медленный шаг между пул-реквестом и релизом. Поэтому мы пишем для каждого вида утверждений критерий, который другой агент сможет проверить без человека: для исправления логики тест, который падает до исправления и проходит на слитом поезде; для API вендора запись ответа настоящего сервиса; для всего, что видит человек, скриншоты настоящей сборки с настоящими шрифтами; для стоимости измеренные числа запросов; а для релиза ответ каждой точки назначения. Всё необратимое и всё, что касается денег, остаётся за людьми.
Мы пока не знаем, как понять, что критерий достаточно хорош. План в том, чтобы оценивать ревьюеров так же, как оценивают тесты: считать блокеры, которые находит каждый и которые пропустил CI, и то, как часто человек отменяет его вердикт. Когда люди перестанут отменять ревьюера по какому-то виду утверждений, этому критерию человек больше не будет нужен. Ни того, ни другого числа у нас пока нет.
Источники и дополнительное чтение
- Журнал изменений Claude CodeСправка
- CodexСправка
- OrcaСправка
- herdrСправка
- Kiro CrewСправка
- Список RFC Kiro CrewСправка
- Foxl CodeСправка
- Cognition, «Don’t Build Multi-Agents»Справка