打造 AI 软件工厂,我们学到了什么
Foxl 团队靠一座 AI 软件工厂每月发布几十次,里面有 15 到 20 个编程智能体同时工作。写代码是容易的部分,确认代码是对的要难得多。这是我们搭建这些检查时学到的东西。
本页内容
Foxl 团队每个月要发几十次版本。10 月一共发了 66 次,其中正式版 22 次,测试版 44 次。每次发布都带着 Windows、macOS 和 Linux 的桌面应用,正式版还会同时带上 iOS 和 Android 应用以及 Web 应用。每一次,这些都得确认能正常工作。
同一个月,我们的仓库里开了 2,140 个拉取请求,合并了 2,040 个,差不多每天开 70 个。这些代码大部分不是人写的,而是编程智能体写的:一台 Mac 上同时运行着 15 到 20 个 Claude Code 会话,每个都在自己的分支上。这些会话提交代码所用的那个 GitHub 账号,看它的贡献图,变化一目了然。之前两年,每年只有几百次贡献;今年已经超过 30,000。
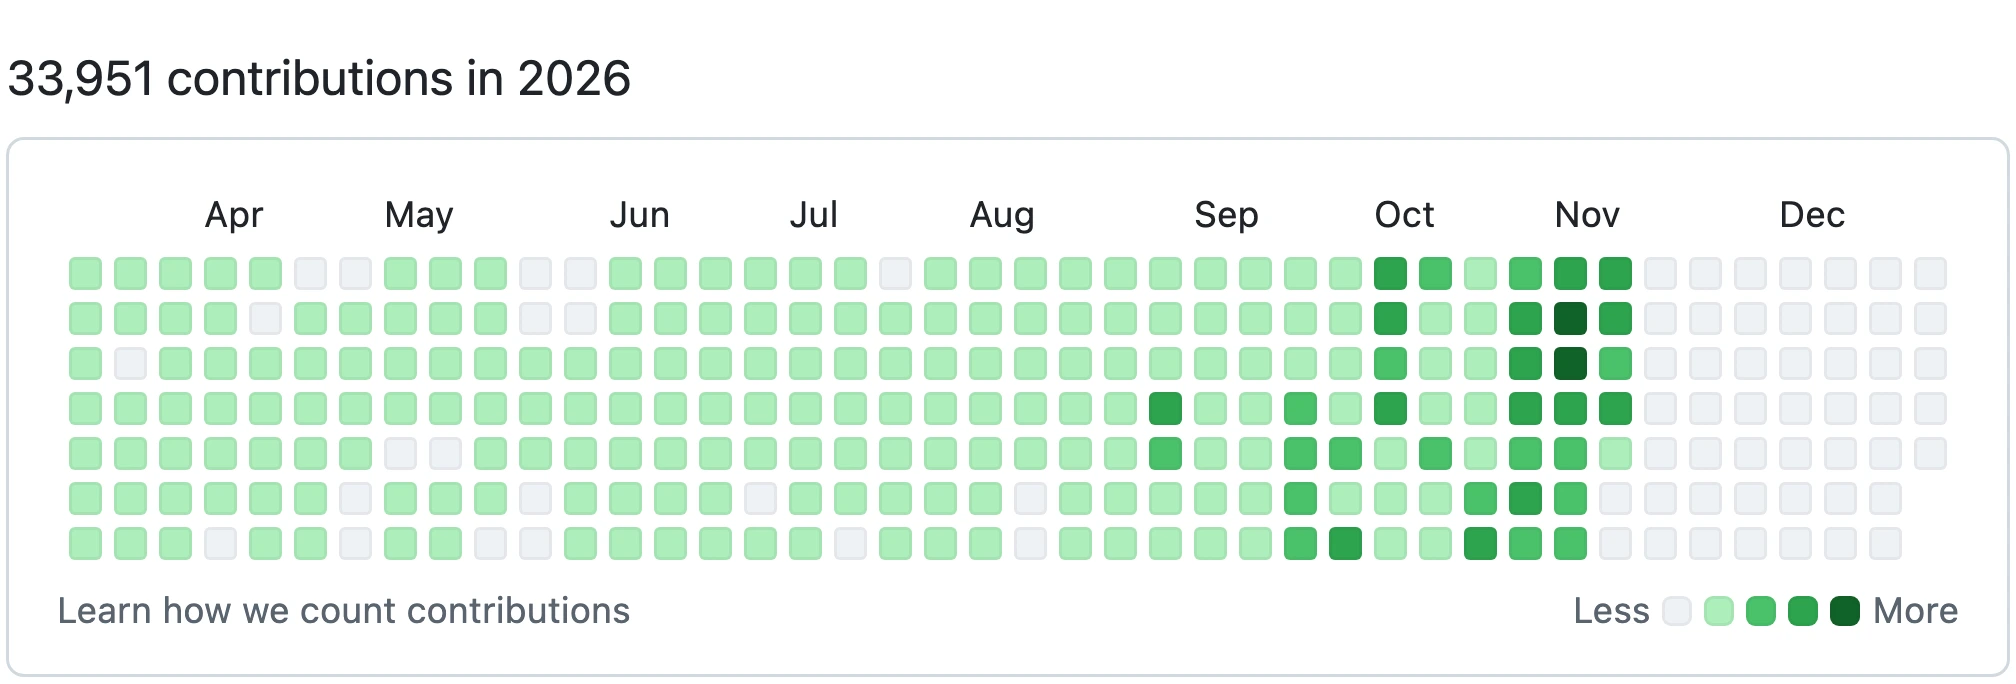
由智能体规划工作、编写代码、测试并评审的开发方式,如今被称为 AI 软件工厂。人决定做什么,并对发布什么做最后的判断。我们的工厂也是这样运转的。但从 3 月把代码交给智能体之后,我们发现难的不是写代码,而是弄清楚智能体写的代码是不是真的对,在五个平台上是不是都站得住。
这篇文章讲的,就是我们为此搭建检查机制时学到的东西。简单说:我们只写下来给智能体看的规则,没有一条没被打破。大多数撑不过几天。真正管用的,是恰好放在错误来路上的检查;而下一个错误,几乎总是从一条还没有检查的路进来。
从一个会话到二十个
头四个月,我们整天开着一个会话,每出一个 diff,都由人读一遍。几乎所有改动都直接进了 main,整个 6 月仓库里只有一个拉取请求。瓶颈是人的注意力:一个人能好好跟住的,大概也就一个会话。
7 月,我们把自己的云端编程智能体 Foxl Code 指向了 Foxl 自己的仓库。每个任务配一台自己的云端 VM,7 月 22 日,这套配置一天发了五次生产版本。不过这些 VM 里没有 macOS,所以凡是需要 Xcode 或 iPhone 模拟器的事,还是得回到 Mac 上做。
8 月,我们改变了工作方式:每个会话一个 git worktree,每个改动一个拉取请求。会话不再互相覆盖对方的工作,于是可以同时跑好几个,拉取请求也从 8 月的 598 个涨到 9 月的 946 个、10 月的 2,140 个。
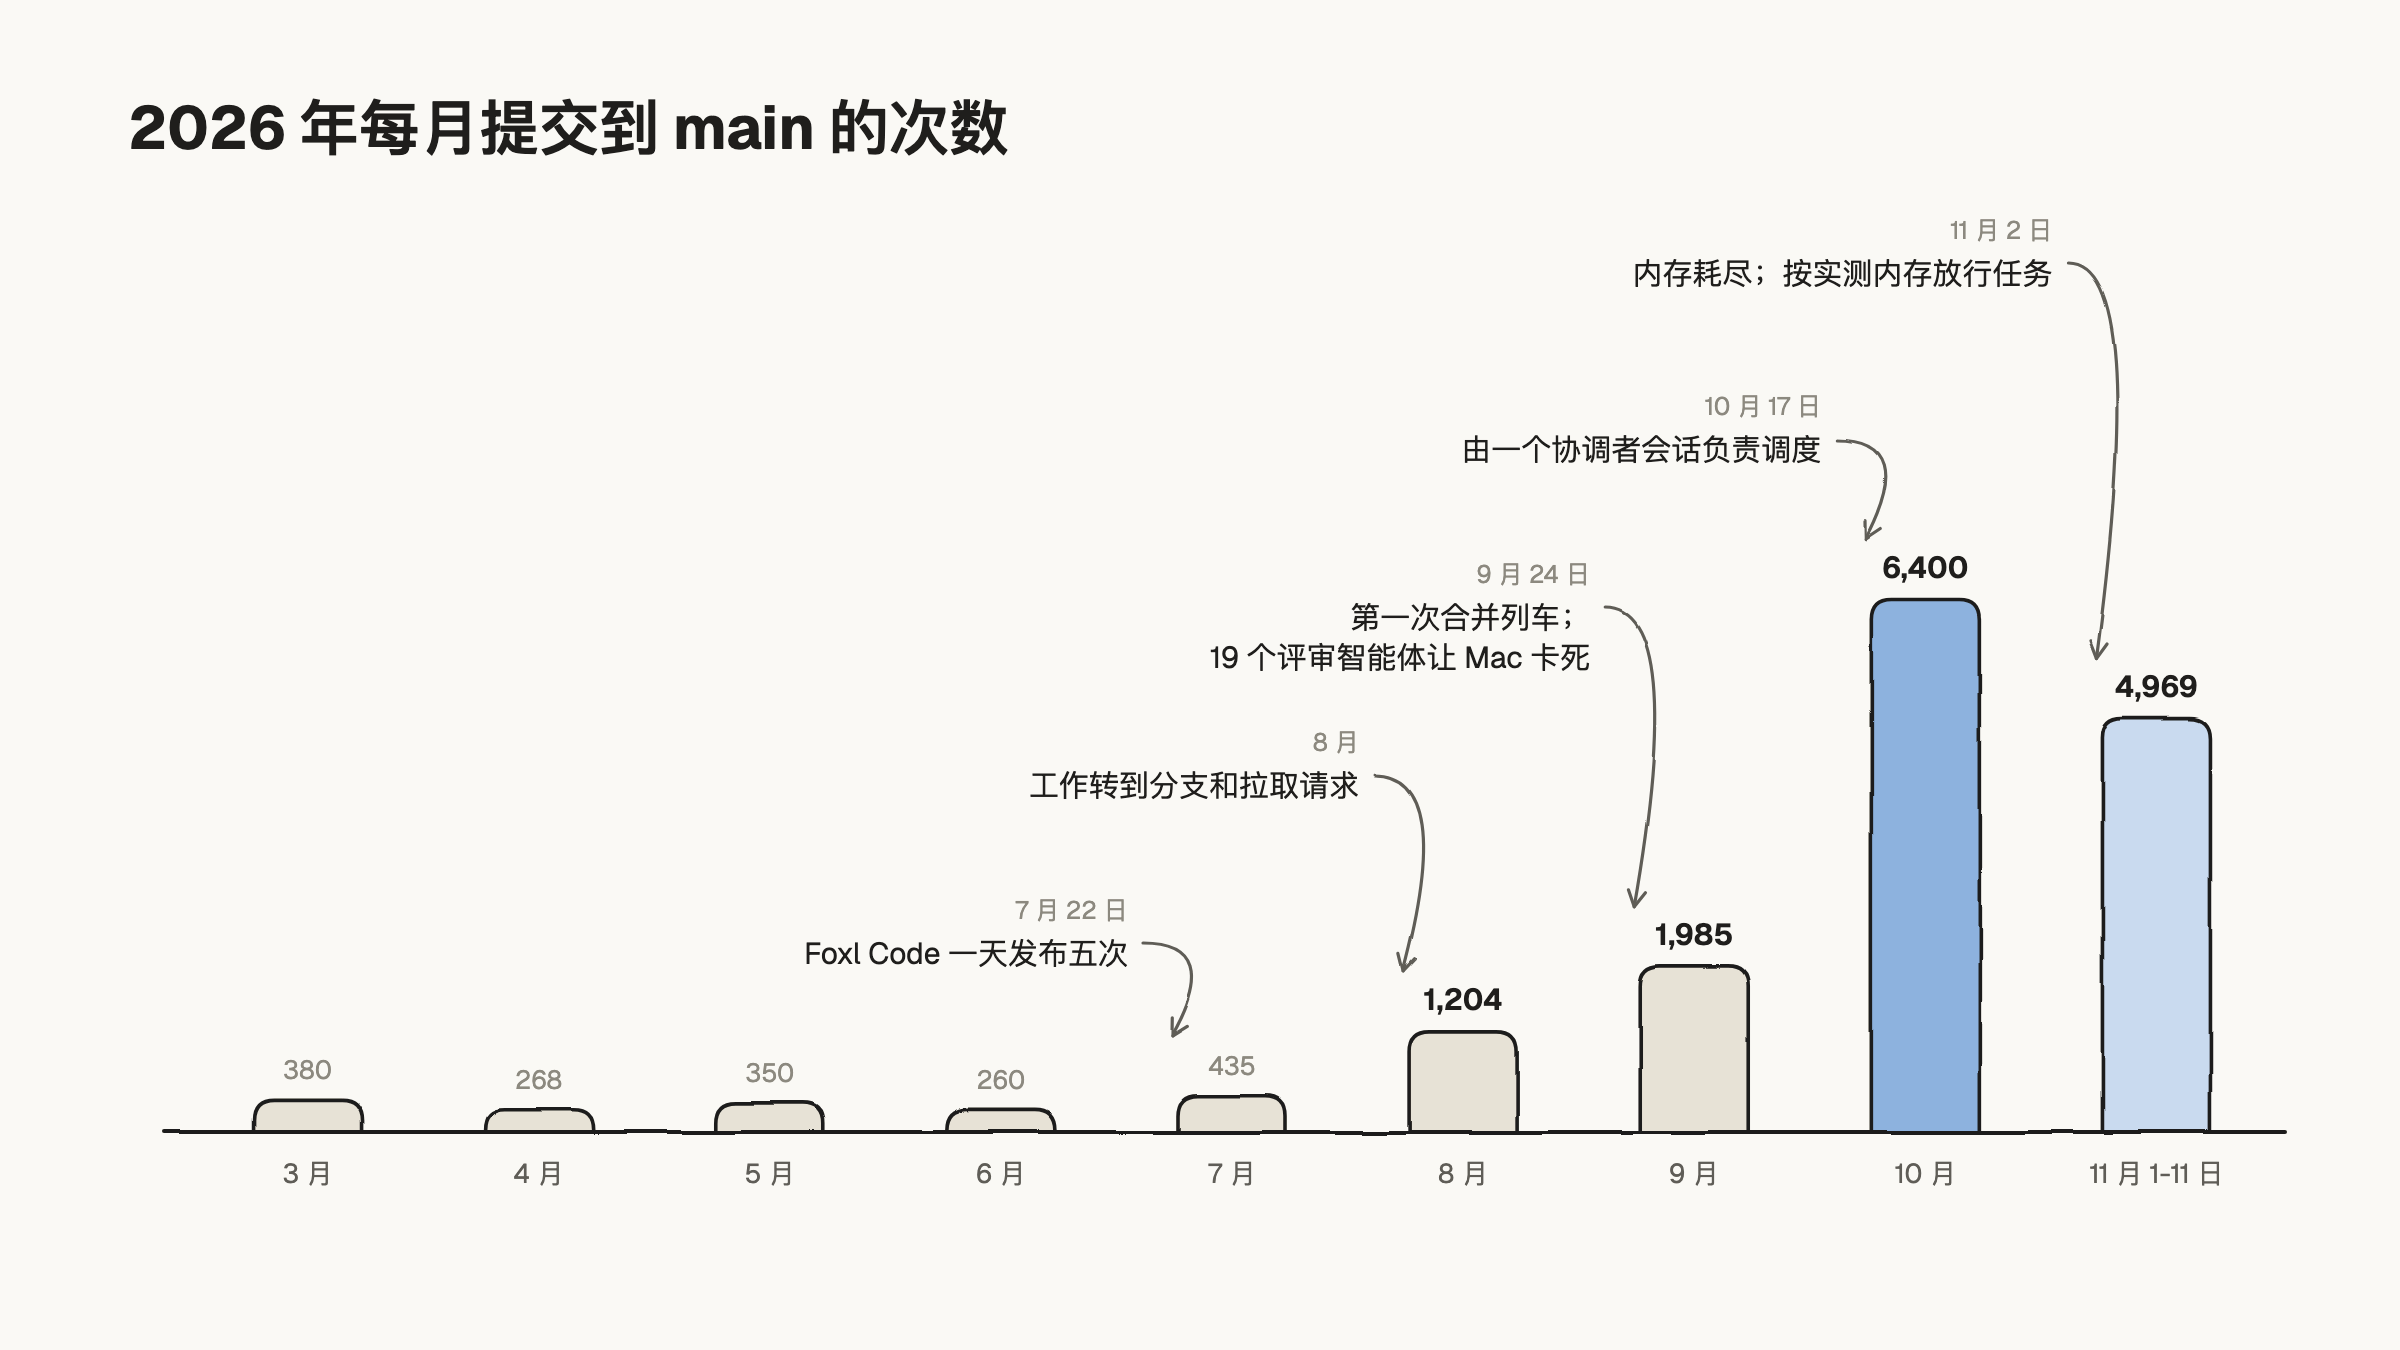
数量一上去,新问题就冒了出来。会话们同时改同一批文件,Mac 的内存也不够用了。最重要的是,9 月 24 日的第一次合并列车表明,CI 是绿的,并不代表拉取请求是对的。后面会详细讲。
能在哪里检查,就决定了在哪里工作
要检查五个平台,首先得有能运行它们的机器。我们用三种机器,每种能检查的东西都不一样。
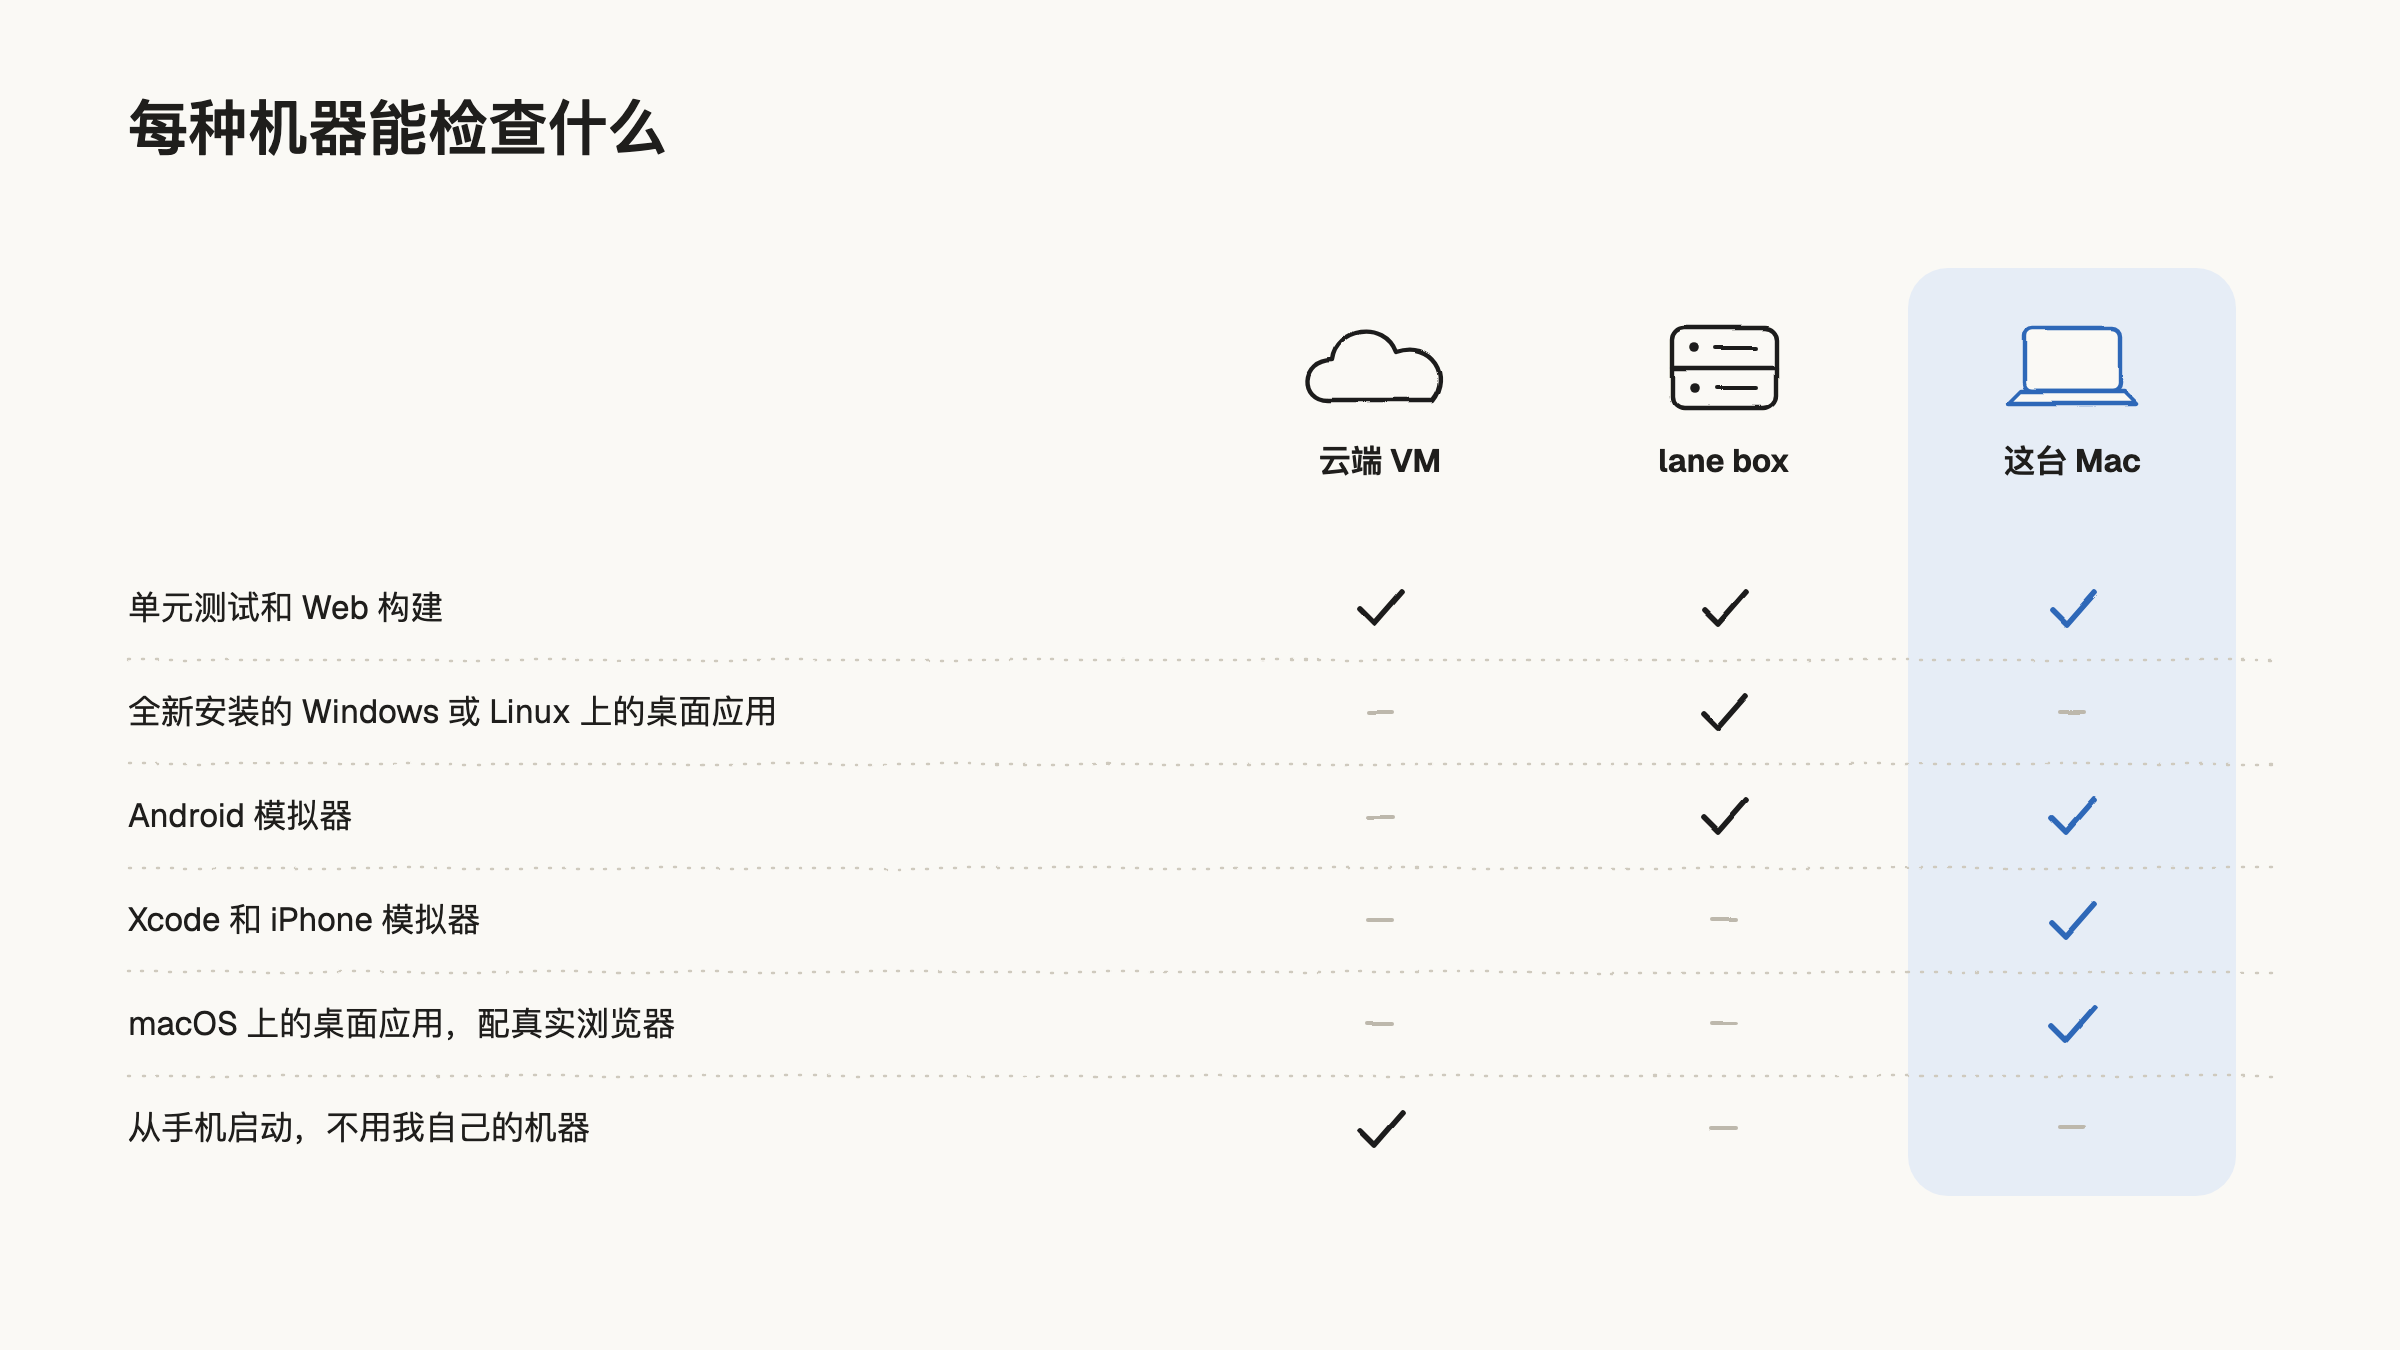
云端 VM 适合隔离的 Linux 工作,也能直接从手机上启动。会话需要在全新安装的 Windows 或 Linux 上运行桌面应用、或者需要 Android 模拟器时,会领到一台用完即弃的 EC2 实例,我们叫它 lane box。而其余的一切,也就是 Xcode、iPhone 模拟器、真正的 Chrome 和 macOS 上的桌面应用,只有 Mac 能检查。
所以大部分会话最后都跑在一台 Mac 上。这也是我们每天在用的电脑,这意味着所有会话共用一台机器的内存,而且就在真实数据旁边工作。
启动智能体已经是解决了的问题
能同时运行很多智能体的工具已经不少。我们看过的每一个都让并行运行变得很容易,有些还能让智能体互相对话。它们的区别在于智能体在哪里运行,以及对结果的检查,它们承担多少。
Claude Code 和 Codex
这两个是智能体本身。Claude Code 会在各自的 worktree 里运行关掉终端也不停的后台会话(claude --bg --worktree),会话之间可以互发消息,也能启动子智能体。还有从网页或手机启动的云端会话。Codex 有 CLI、桌面应用和 IDE 扩展,Codex Web 则在 OpenAI 云端的 Linux 容器里运行任务。
Orca
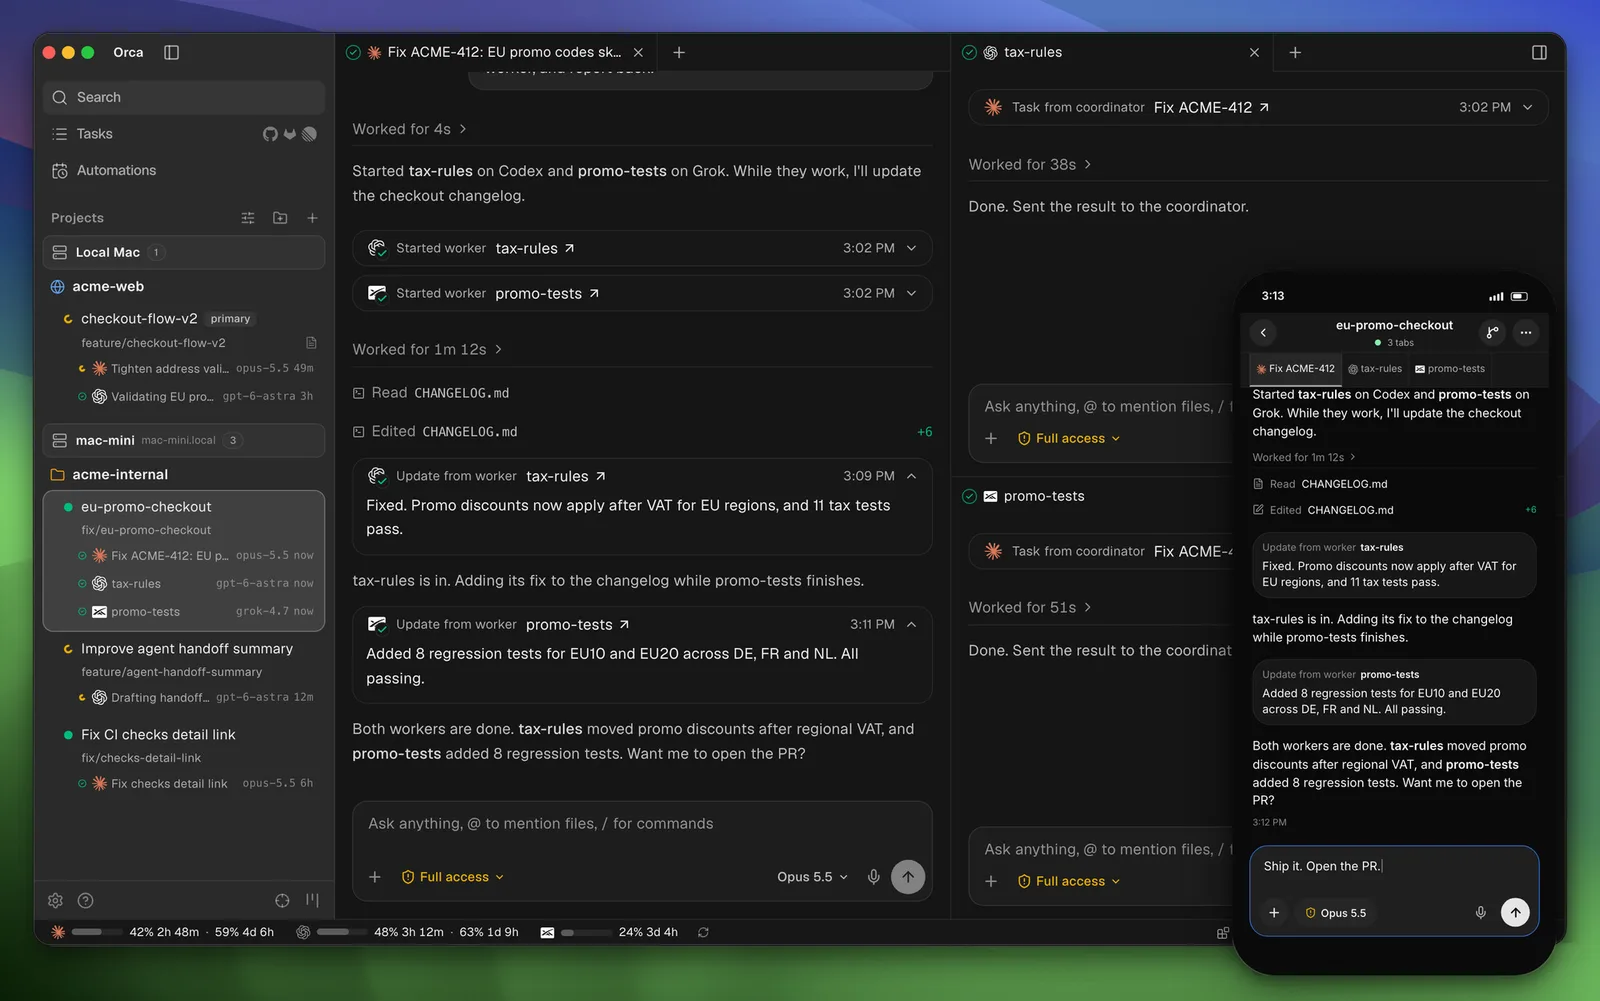
Orca 是适用于 macOS、Windows 和 Linux 的桌面应用。它让 Claude Code 或 Codex 这类 CLI 智能体在各自的 worktree 里并行运行;交给它一个大任务时,会由一个协调者智能体把工作分给工作者,再把结果带回来,上面的截图就是这个场景。智能体也可以跑在 SSH 主机上,或者每个 worktree 一台的云端 VM 上;失败的检查和评审意见会退回给智能体去修。
herdr
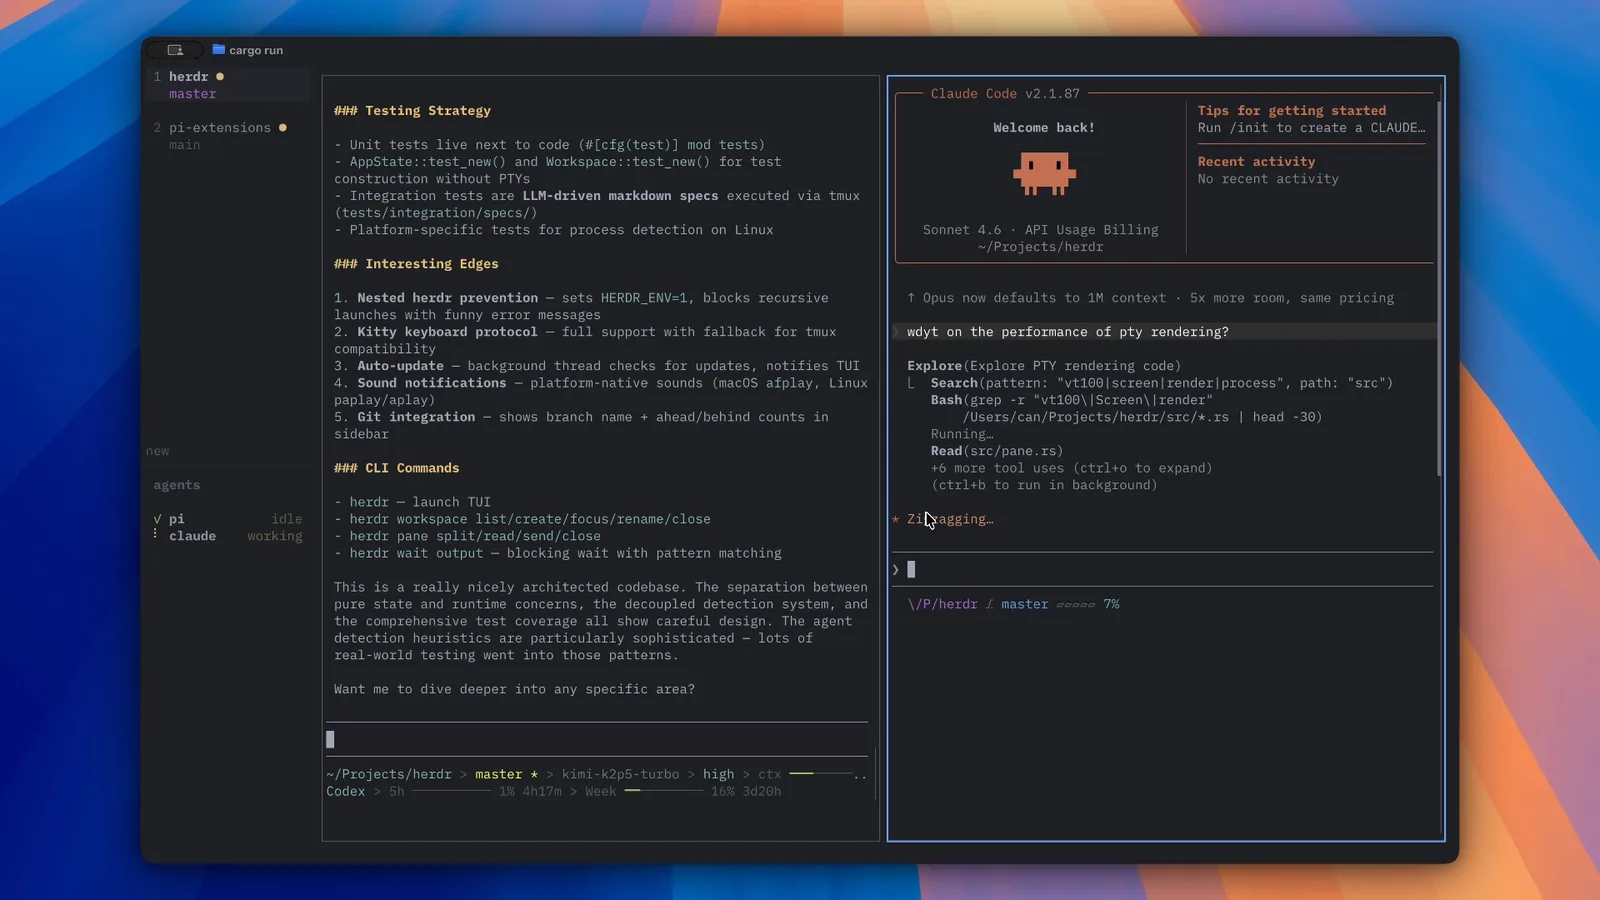
herdr 是一个终端运行时,只有一个 Rust 二进制文件。它不包装智能体,而是接管终端,所以对 Claude Code、Codex 或 OpenCode 都一样适用。SSH 断开时,终端仍在后台运行;每个窗格都会显示它的智能体是 working、blocked 还是 idle;智能体还能通过它的 CLI 和 socket API 互相发提示词。
Kiro Crew
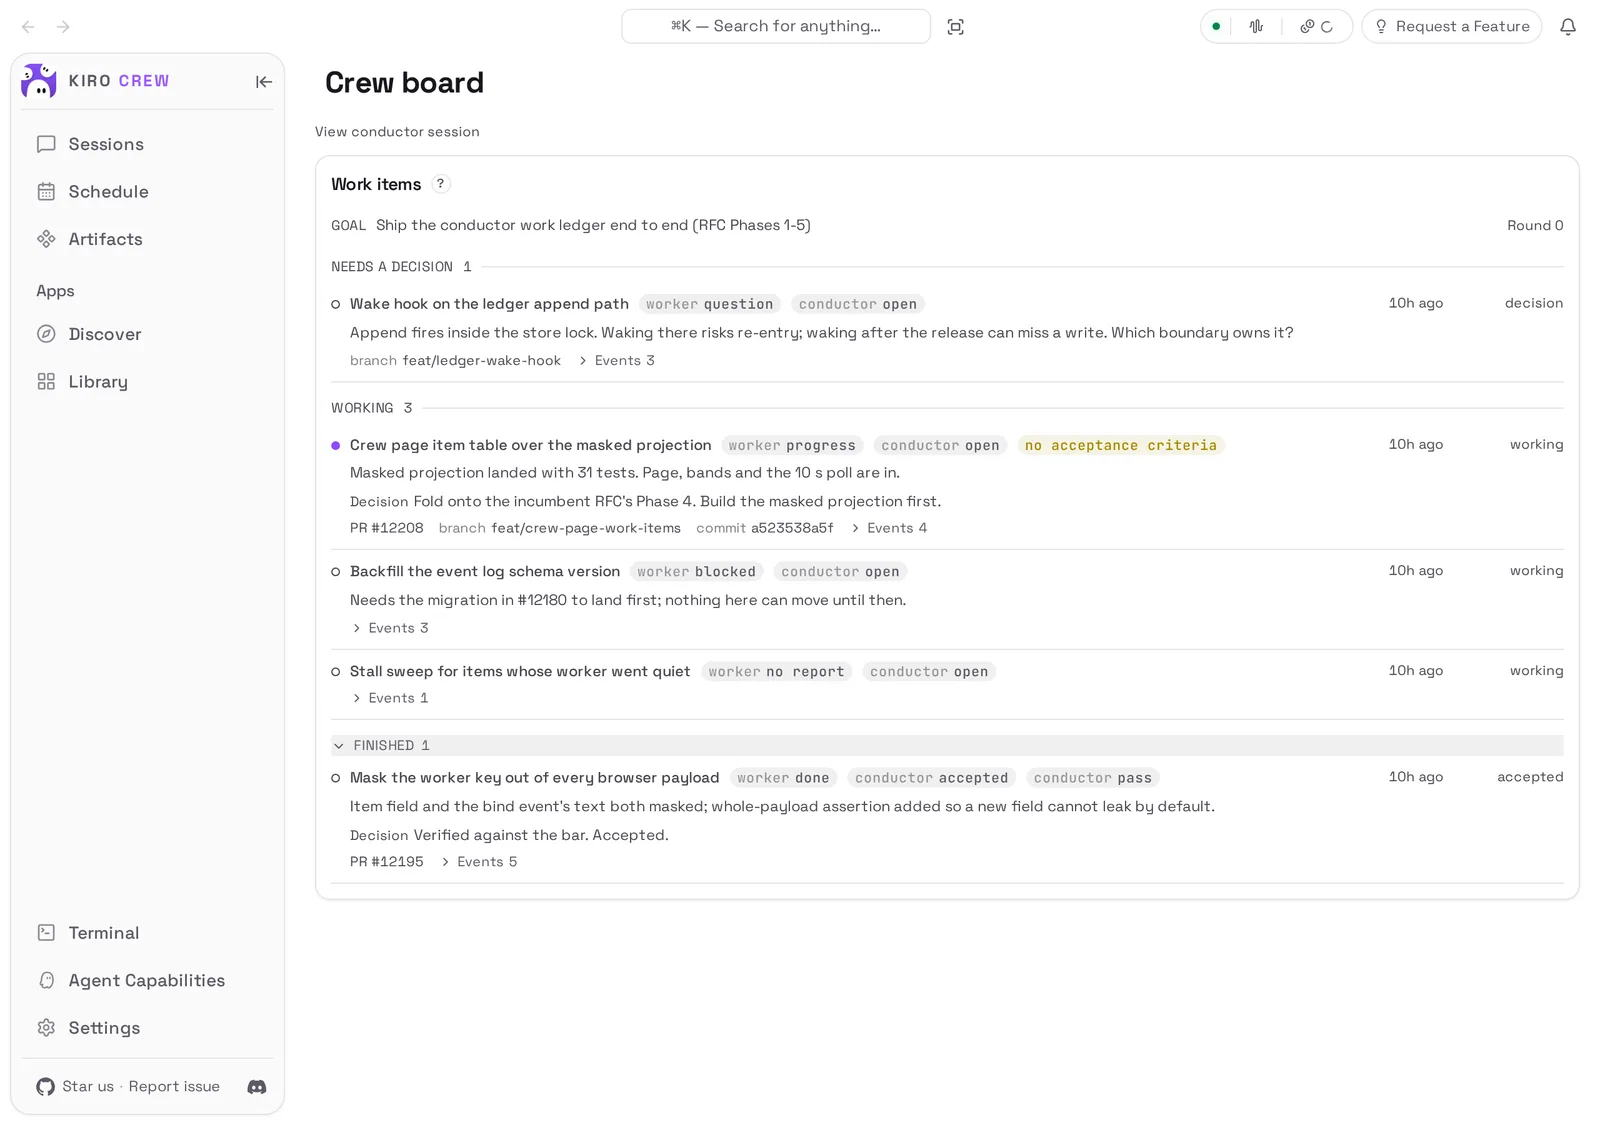
Kiro Crew 是一个跑在你自己硬件上(Mac、容器或远程机器)的工作空间,在两次对话之间也会继续工作。会话、记忆和任务检查点在重启后依然保留;你纠正过的地方会积累成教训,改变它之后的做法。上面的 crew board 会把 conductor 分出去的每一项,和工作者汇报的内容、conductor 是否按标准接受了结果并排列出来。
Foxl Code
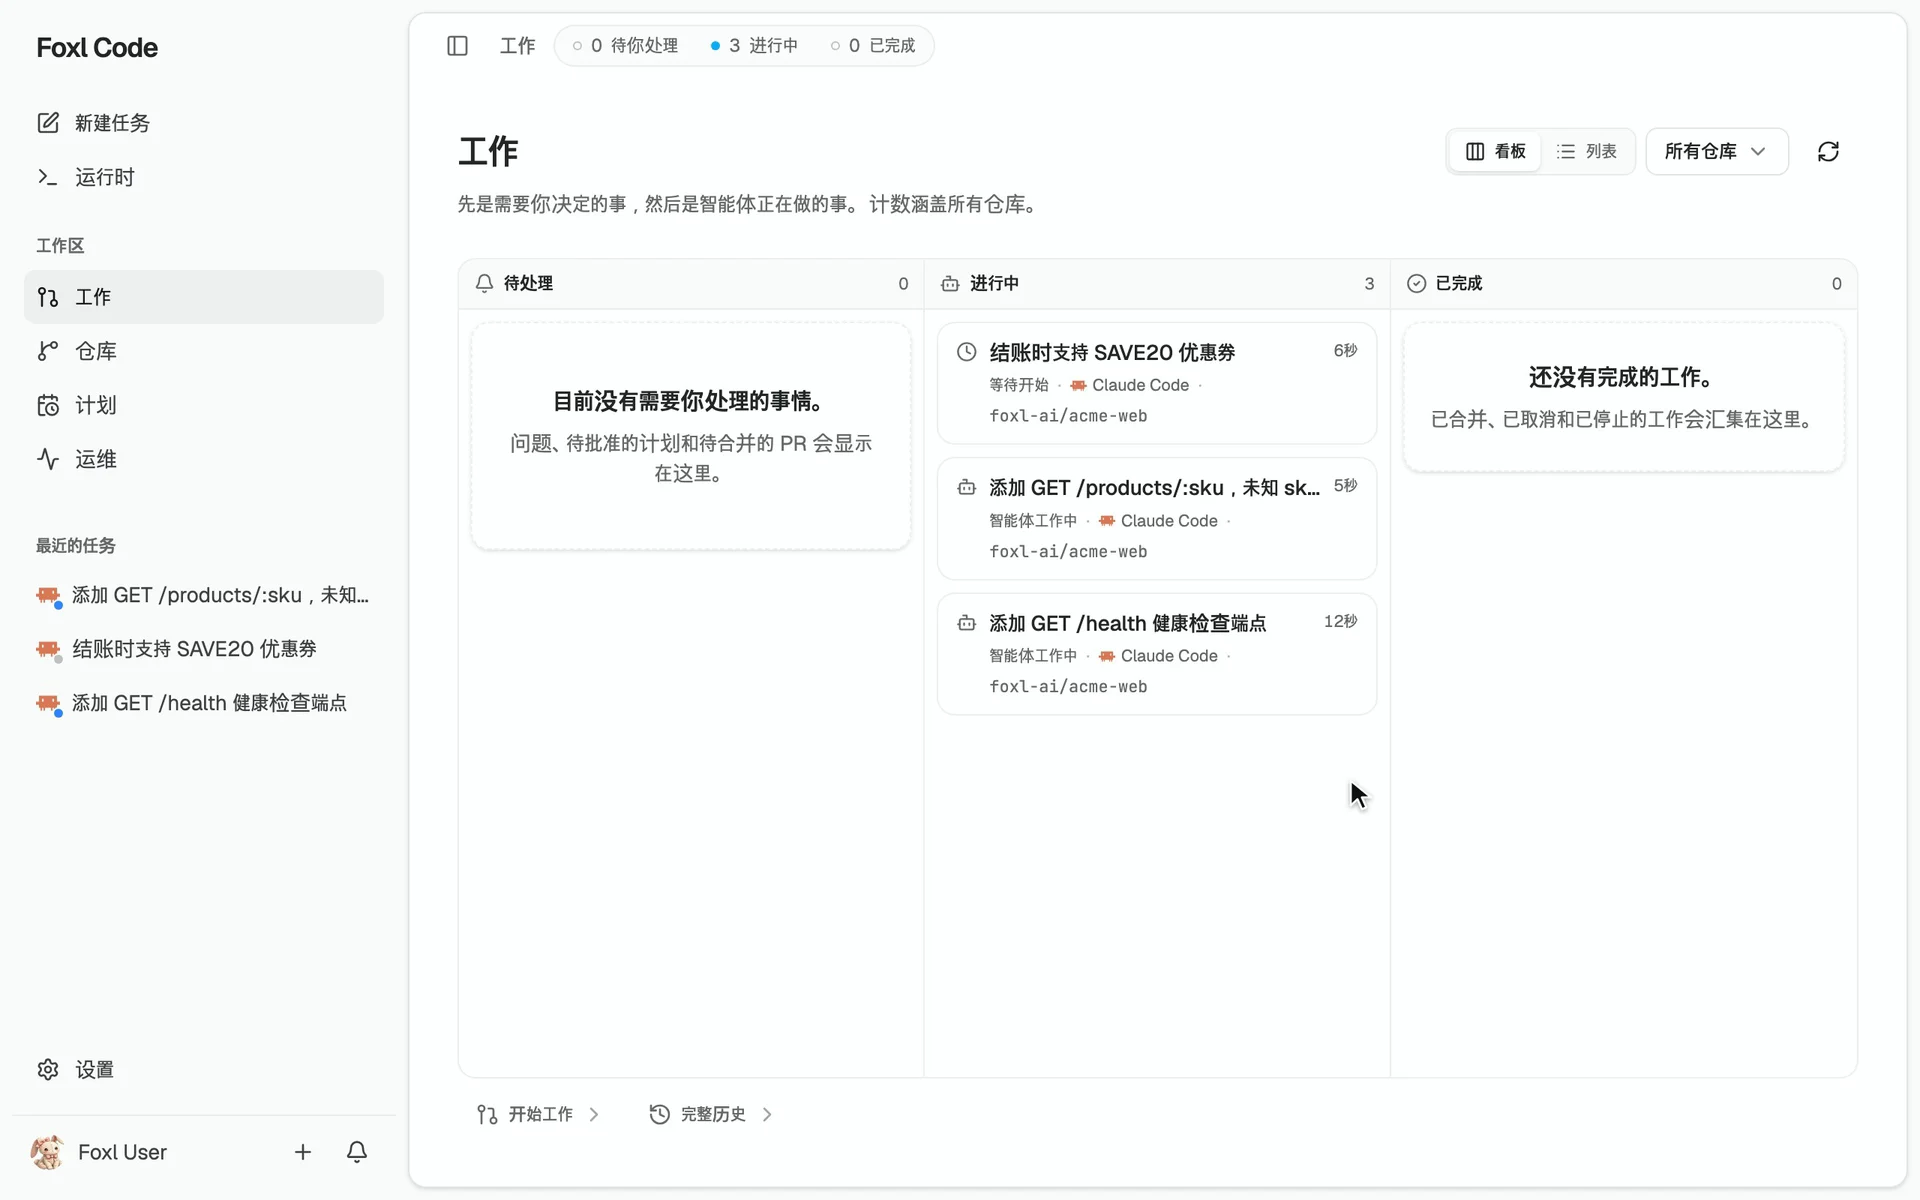
Foxl Code 就是前面提到的我们的云端产品,目前是仅限受邀账号的内测版。你在浏览器或手机上描述一个任务,Claude Code 这样的智能体就会在一台自己的 VM 里处理它。较大的请求会拆成彼此独立、同时开始的子任务,每个子任务一个拉取请求;上面的截图是一个请求刚拆成三个子任务时的看板。评审从默认分支读取仓库的 MERGE-REVIEW.md,从不从拉取请求里读,所以改动没法改写给它打分的标准。不过,每个拉取请求仍是单独检查的:要把几个合并在一起测试,得在聊天里要一次合并列车。
放在一起比较:
| 工具 | 智能体在哪里运行 | 优点 | 局限 |
|---|---|---|---|
| Claude Code | 你的机器,或从网页或手机启动的云端会话 | 在各自 worktree 里运行、能互相列出和发消息的后台会话;子智能体 | 消息只能送达 Claude Code 会话 |
| Codex | 你的机器,或 OpenAI 云端 | 同一个智能体用在 CLI、桌面应用、IDE 和云端 | 云端任务跑在 Linux 容器里,所以 Xcode 的活只能留在本地 |
| Orca | 你的机器、SSH 主机,或每个 worktree 一台的云端 VM | 支持任何 CLI 智能体;把任务分给工作者的协调者;手机应用;把失败的检查退回给智能体 | 它的描述里没有把多个拉取请求合并在一起再测试的功能 |
| herdr | 你的机器和 SSH 主机 | 可以垫在任何智能体下面:断开也不停的终端,每个窗格标出 working、blocked 或 idle,智能体互相发提示词 | 只管终端,不管工作:自己不带评审或合并步骤 |
| Kiro Crew | 你的 Mac、容器或远程机器 | 重启后依然保留的会话、记忆和检查点;从纠正中得来的教训;按标准接受工作的 conductor | 工作者之间还没有直接通信的通道 |
| Foxl Code | 每个任务一台 VM,在 Foxl 云端 | 从手机开始;子任务并行,每个一个拉取请求;遵循仓库合并标准的评审 | 内测版;没有 macOS;只有你要求的合并列车才会把拉取请求合在一起测试 |
我们是在 Claude Code 自己的会话上搭起这个工厂的。它是从一个 Claude Code 会话长出来的,而这台 Mac 上的会话,本来就能在 Xcode 和模拟器旁边互相列出、互相发消息。
不管用哪个工具运行智能体,有两件事不会变。同一台机器上的智能体必须共享它的内存,而它们做得对不对,总得有人来判断。本文剩下的部分,讲的就是这两件事。
二十个会话,一台 Mac 的内存
10 月 17 日下午,开着 19 个会话。一次 Web 构建大约要占 3.5 GB 内存,而十分钟内就有四个会话各要了一次。两个跑了 TypeScript 检查,还有一个没问就启动了 iPhone 模拟器。有 8 个会话在同一个 CSS 文件里有未合并的改动。那天下午,我们让会话们少用内存,排队等,用之前先问。
同一天,一个会话成了协调者。其他会话启动时先读一个共享文件,上面写着谁负责哪些文件;然后用一行字把自己的任务和预计要碰的文件发给协调者,再领回自己的范围。需要别的会话负责的文件时,就把改动发给那个会话,让它来应用。在构建、测试套件或模拟器这类吃内存的工作之前,会话要发出带内存和时长估计的 HEAVY?,然后等 GO。协调者每次批准前都会读一下 Mac 的内存压力。
下面是这篇文章的第一次构建排过的队。前面已经排着一个模型基准测试和几次模拟器运行,构建等了 50 分钟才开始。
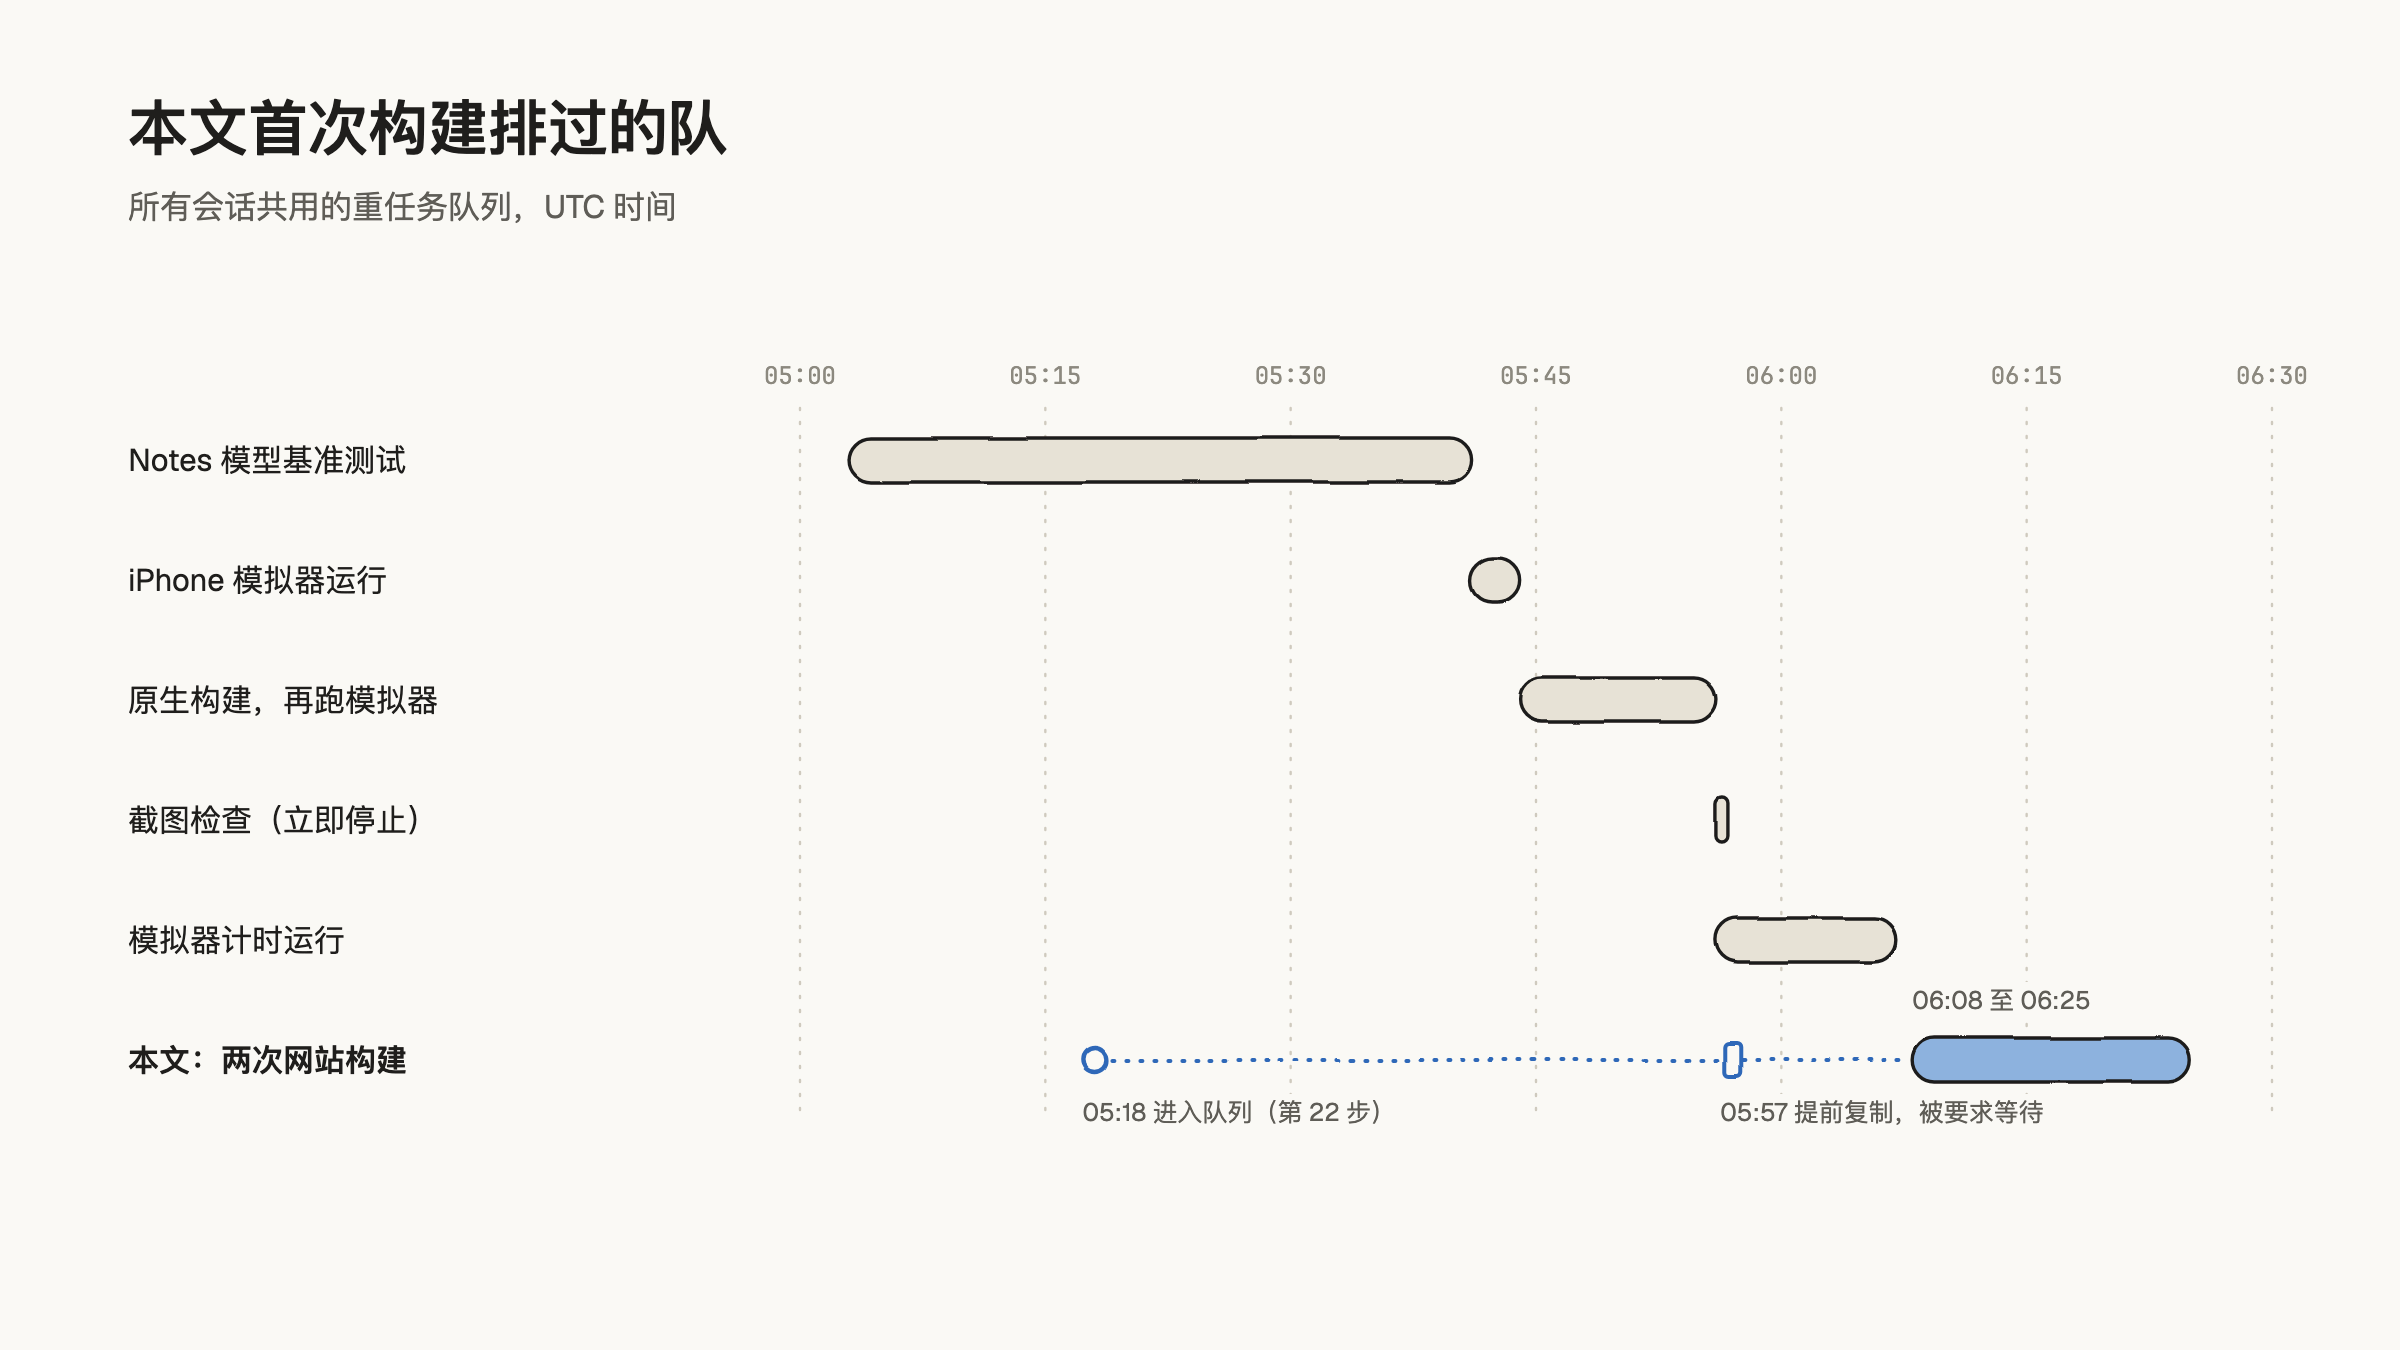
队列的规则都在一个 shell 脚本 heavy.sh 里,而且不止改过一次。10 月 28 日,规则太严了:Mac 还有 43% 的空闲内存,却有 10 个任务最多等了 16 分钟,我们把队列拿掉了。11 月 2 日,规则又太松了:大约开着 19 个会话,其中几个各跑着 2 到 5 个子智能体,而闸门既没算子智能体,也没算一个已经开了六个小时的开发服务器。Mac 内存耗尽,运行环境清理后台 shell 时,协调者的监视进程也跟着一起没了。
现在的闸门每次运行都会测量 Mac 的内存。有余量,任务就立刻开始;没有余量,就扣住;同时运行的重任务最多四个。重任务之前的检查大致如下:
# LOCKS is a directory every session shares; run/<pid> marks a heavy run.
level=$(sysctl -n kern.memorystatus_vm_pressure_level)  # 1 normal, 2 warn, 4 critical
free=$(memory_pressure -Q | awk -F: '/free percentage/ {print int($2)}')
live=0
for f in "$LOCKS"/run/*; do
  [ -e "$f" ] && kill -0 "${f##*/}" 2>/dev/null && live=$((live + 1))
done

hold() {
  [ -e "$LOCKS/STOP" ] || [ "$level" -ge 4 ] ||
  { [ "$level" -ge 2 ] && [ "$live" -ge 2 ]; } ||
  [ "$free" -lt 25 ] || { [ "$free" -lt 30 ] && [ "$live" -ge 1 ]; } ||
  [ "$live" -ge 4 ]
}
# Wait while hold() is true or older tickets fill the free slots (2 at warn, 4 otherwise).
# Then write run/$$, run "$@" as a child, and remove run/$$ when it exits.
等待中的任务按先来后到领号。有一次排队的有 30 个左右,槽位一空,谁先轮询到谁就赢,结果有个任务被后来者挤着等了 35 分钟。整台机器还有上限:最多六个子智能体、一个模拟器,但这两条至今仍只是写下来的规则,闸门并不强制。
只写在纸上的规则会被打破
本文的每一次事故都留下了一条规则,连同日期写了下来。其中三条可以说明,只存在于文字里的规则会怎样。
第一条是真实数据。从我们实际在用的那份 Foxl 桌面应用里启动的智能体会话,会继承应用的环境,其中包括一个指向应用数据库的变量。10 月 19 日,从这样的 shell 里跑的一个测试套件,往真实的 Foxl 数据库里写入了 305 段假对话。清除这个变量的规则当天就加上了,从 10 月 24 日起,heavy.sh 会自己清除它。错误还是一再回来:直接用 npm 跑的检查、一次性脚本、打包了整个桌面服务器的测试,每次都走包装脚本没覆盖到的路。现在,桌面服务器在测试运行器下运行时会拒绝打开真实数据(foxl/server/paths.ts)。只有一次性脚本至今仍只靠写下来的规则。
第二条是一个会花真钱的脚本。check-remote-input.mjs 混在几十个读取仓库、发现问题就失败的 check- 脚本里,可它实际上会在生产环境的 Foxl Code 服务上启动真实任务。9 月 23 日,一次批量运行所有 check- 脚本时,启动了一个任务。当时的规则是:按名字一个个运行检查。10 月 18 日,这个脚本混进了一份用 grep 挑出来的检查清单,它的三个任务产生的费用,让我们的测试账号余额变成了负数。现在这个脚本没有 --live 参数就什么都不做,pr-validate 里有一个测试守着这一点。
第三条是 push 锁。push 当时要经过一把锁,会话通过创建一个目录来拿到它。11 月 2 日,一个会话在一批并行工具调用里试图手动拿锁。因为另一个会话持有锁,创建目录失败了,可这一批里剩下的调用照样执行:这个会话 push 了,然后删掉了另一个会话的锁。当天上午就加了一个脚本,负责拿锁,并且只释放自己的锁;可被限制在自己 worktree 里的会话用不了它,只能继续一步一步手动拿锁。11 月 4 日又犯了同样的错误。
这些检查没有一个终结了它那一类错误。每个检查只堵住了上一个错误走过的路,而到目前为止,下一个错误总能找到另一条路。
绿色的检查证明了什么
我们的 CI 全部跑在自托管运行器上,每个拉取请求都必须通过一个叫 pr-validate 的关卡。问题在于,这个绿色的勾到底证明了什么。绿色只说明这个拉取请求单独通过了测试,仅此而已。
9 月 24 日 v0.7.27 的第一次合并列车暴露了这个差距。54 个拉取请求在各自的 CI 上都是绿的,却仍藏着四个阻断问题。一个会丢掉用输入法输入的最后几个字符,另一个弄坏了在 iPhone 锁屏上回复。同一天,19 个评审智能体同时在跑,Mac 彻底卡死了。从那以后,评审最多同时跑七个,但这也只是一条写下来的规则。
所以现在,列车由所有已就绪的拉取请求合并后的代码树构建,是否合并也在这棵树上判断。评审智能体每个负责一组相关的拉取请求,拿到的说明里有这样一段,保留英文原文:
Your job is to REFUTE each PR in your group, not to confirm it. Assume every PR body overclaims until you have reproduced its claim. A green pr-validate on the PR proves little: it ran without the other PRs, and it cannot see UX or cost.
意思是:去反驳每个拉取请求,而不是去确认它;在亲自复现之前,先假定每个拉取请求的描述都言过其实;拉取请求上 pr-validate 通过也证明不了多少,因为它是在没有其他拉取请求的情况下跑的,也看不到用户体验和成本。评审的回答只有四种:MERGE、附上补丁的 MERGE_WITH_FIXES、HOLD 或 CLOSE。修复作为单独的提交加在拉取请求之上;修不好的拉取请求,就重建一列不含它的列车来把它排除。
Cognition 的《Don’t Build Multi-Agents》反对把一个任务拆给彼此看不到对方工作的多个智能体,主张交给一个掌握全部上下文的智能体来做。我们也确实让每个会话负责一整个任务。但还剩一个问题:智能体对自己的工作过于自信。这就是评审被要求去反驳的原因。
智能体和功能一起写的测试,尤其是弱证据。测试和代码出自对问题的同一种理解,所以如果智能体误读了某个厂商的 API 或者需求,两者会带着同样的错误。每种检查能看到什么,见下图:
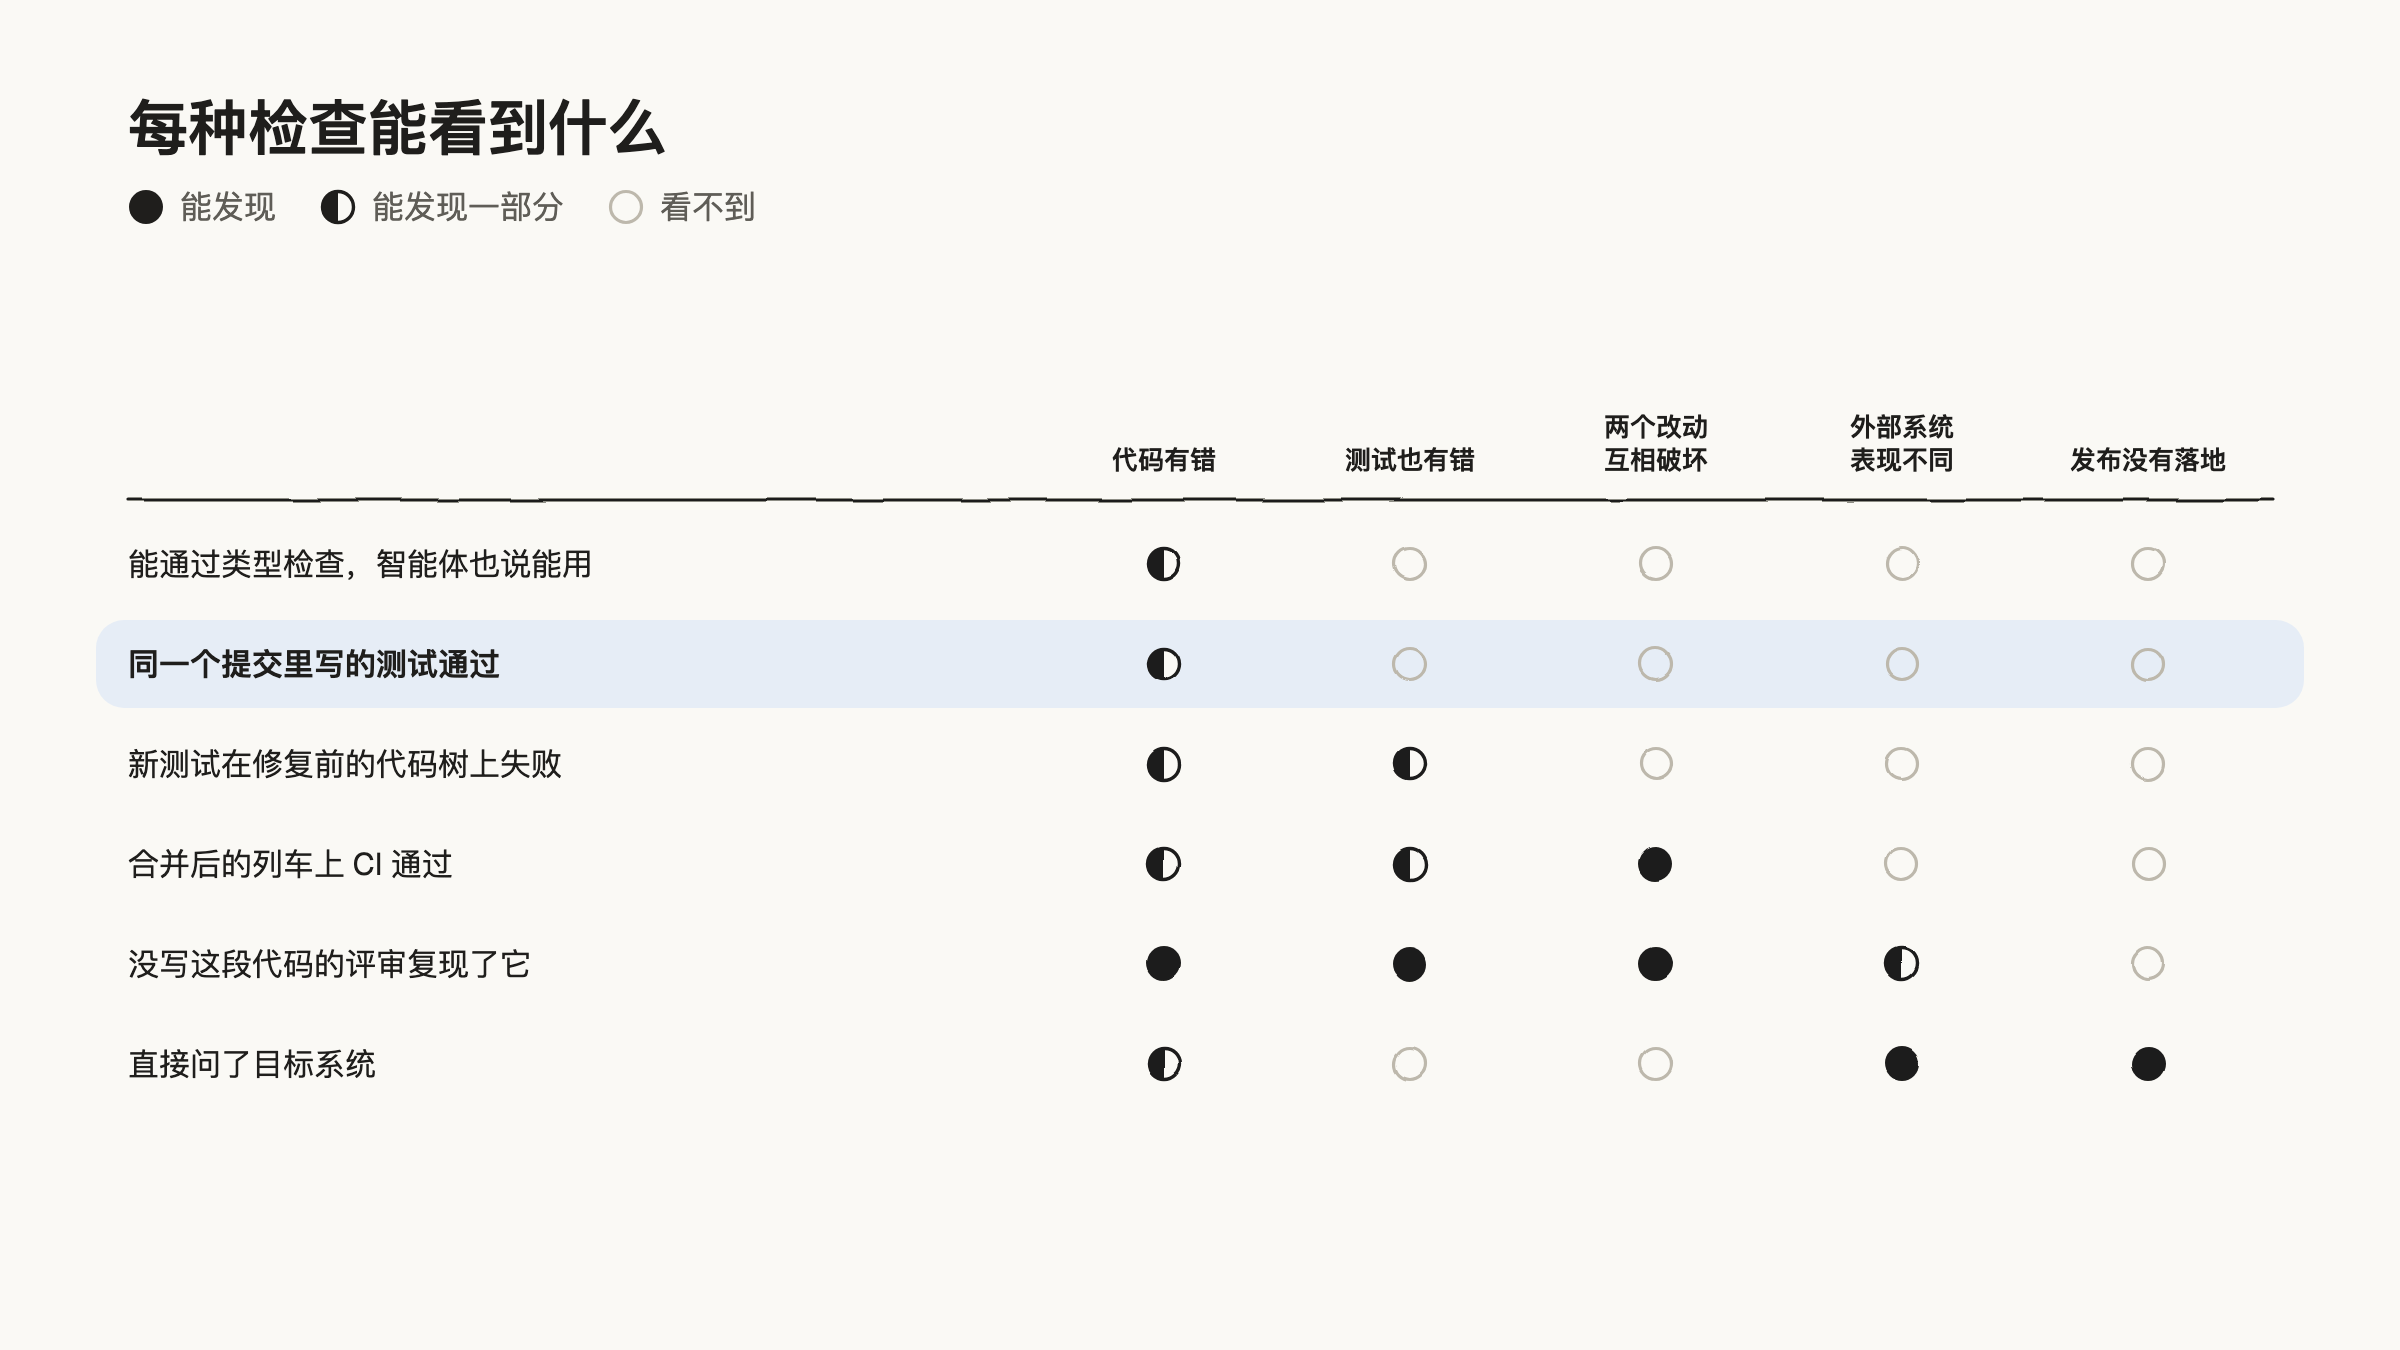
所以,新测试只有在修复前的代码树上失败才算数,最后的关卡是合并后列车上的 CI。对仓库之外发生的事,证据在那个外部系统里。一次 CLI 版本升级之后,Foxl Code 里的远程 Codex 和 OpenCode 终端十天里没接收过任何输入,而这期间所有关卡都是绿的。还有一次,发布工作流报告成功,TestFlight 里却没有构建。11 月 3 日,我们又发现 43 个截图测试工具里有 34 个打开页面时没加载真实字体,所以评审们一直在评判出货的应用根本不会画出来的字形。
直接去问目的地
一次正式发布就是一次工作流运行。这一次运行会构建并发布 Windows、Linux、macOS、iOS 和 Android 应用、Web 应用和 relay 服务器。工作流说成功了,我们并不就此相信:发布之后的检查会直接去问每个目的地。
有个脚本会一直等到五个平台的文件都到齐,才公开发布。Homebrew cask 会和已发布的版本核对,因为它曾经在四次发布里一直提供一周前的构建,而更新它的工作流看起来一切正常。部署后的 Web 应用会和发布版本对比,因为 Worker 用旧的包也会返回 200。TestFlight 则通过 Apple 的 API 去问。
如果你也想搭一套类似的
下面是对我们有用的做法:
- 给每个智能体单独一个 git worktree。在 APFS 上,
cp -Rc会把node_modules复制成写时复制的克隆,几乎不占磁盘。千万别把一个node_modules用符号链接共享给多个 worktree。 - 指定一个智能体做协调者,把共享状态放在所有智能体都能读的普通文件里:谁负责哪些文件、谁在跑什么、什么被冻结了。
- 按实测内存给吃内存的工作设闸门,而且除了构建,还要把子智能体和开发服务器算进去。
- 按 SHA 而不是按名字读取引用,因为别的会话一直在移动
origin/*。
在组建合并列车之前,可以把每个拉取请求依次叠到 main 上,不用检出就能画出冲突图。用 bash 是这样:
# Each head as a local ref first: git fetch origin '+refs/pull/*/head:refs/pr/*'
prs=(101 102 103)
acc=$(git rev-parse origin/main)
for pr in "${prs[@]}"; do
  out=$(git merge-tree --write-tree --name-only "$acc" "refs/pr/$pr"); code=$?
  if [ "$code" -eq 0 ]; then
    acc=$(git commit-tree "${out%%$'\n'*}" -p "$acc" -p "refs/pr/$pr" -m "train: #$pr")
  elif [ "$code" -eq 1 ]; then
    echo "#$pr conflicts in:"; echo "$out" | sed -n '2,/^$/p'
  else
    echo "#$pr: merge-tree failed ($code)"; exit "$code"
  fi
done
像变更日志这种每个拉取请求都会往末尾追加的文件,几乎会出现在每一次冲突里,除非你只为这条命令给它设成 union 合并:git -c core.attributesFile=<file>,并在那个文件里写上 CHANGELOG.md merge=union。
人做什么
在这套配置里,我们不写代码,也很少读 diff。一个请求通常是一句话加一张截图。我们读的是返回来的东西:每个拉取请求里的截图、每列列车的结论,以及每次发布最后的那份报告,里面列出发布了什么、每项检查的回答,以及其中每个拉取请求的截图。
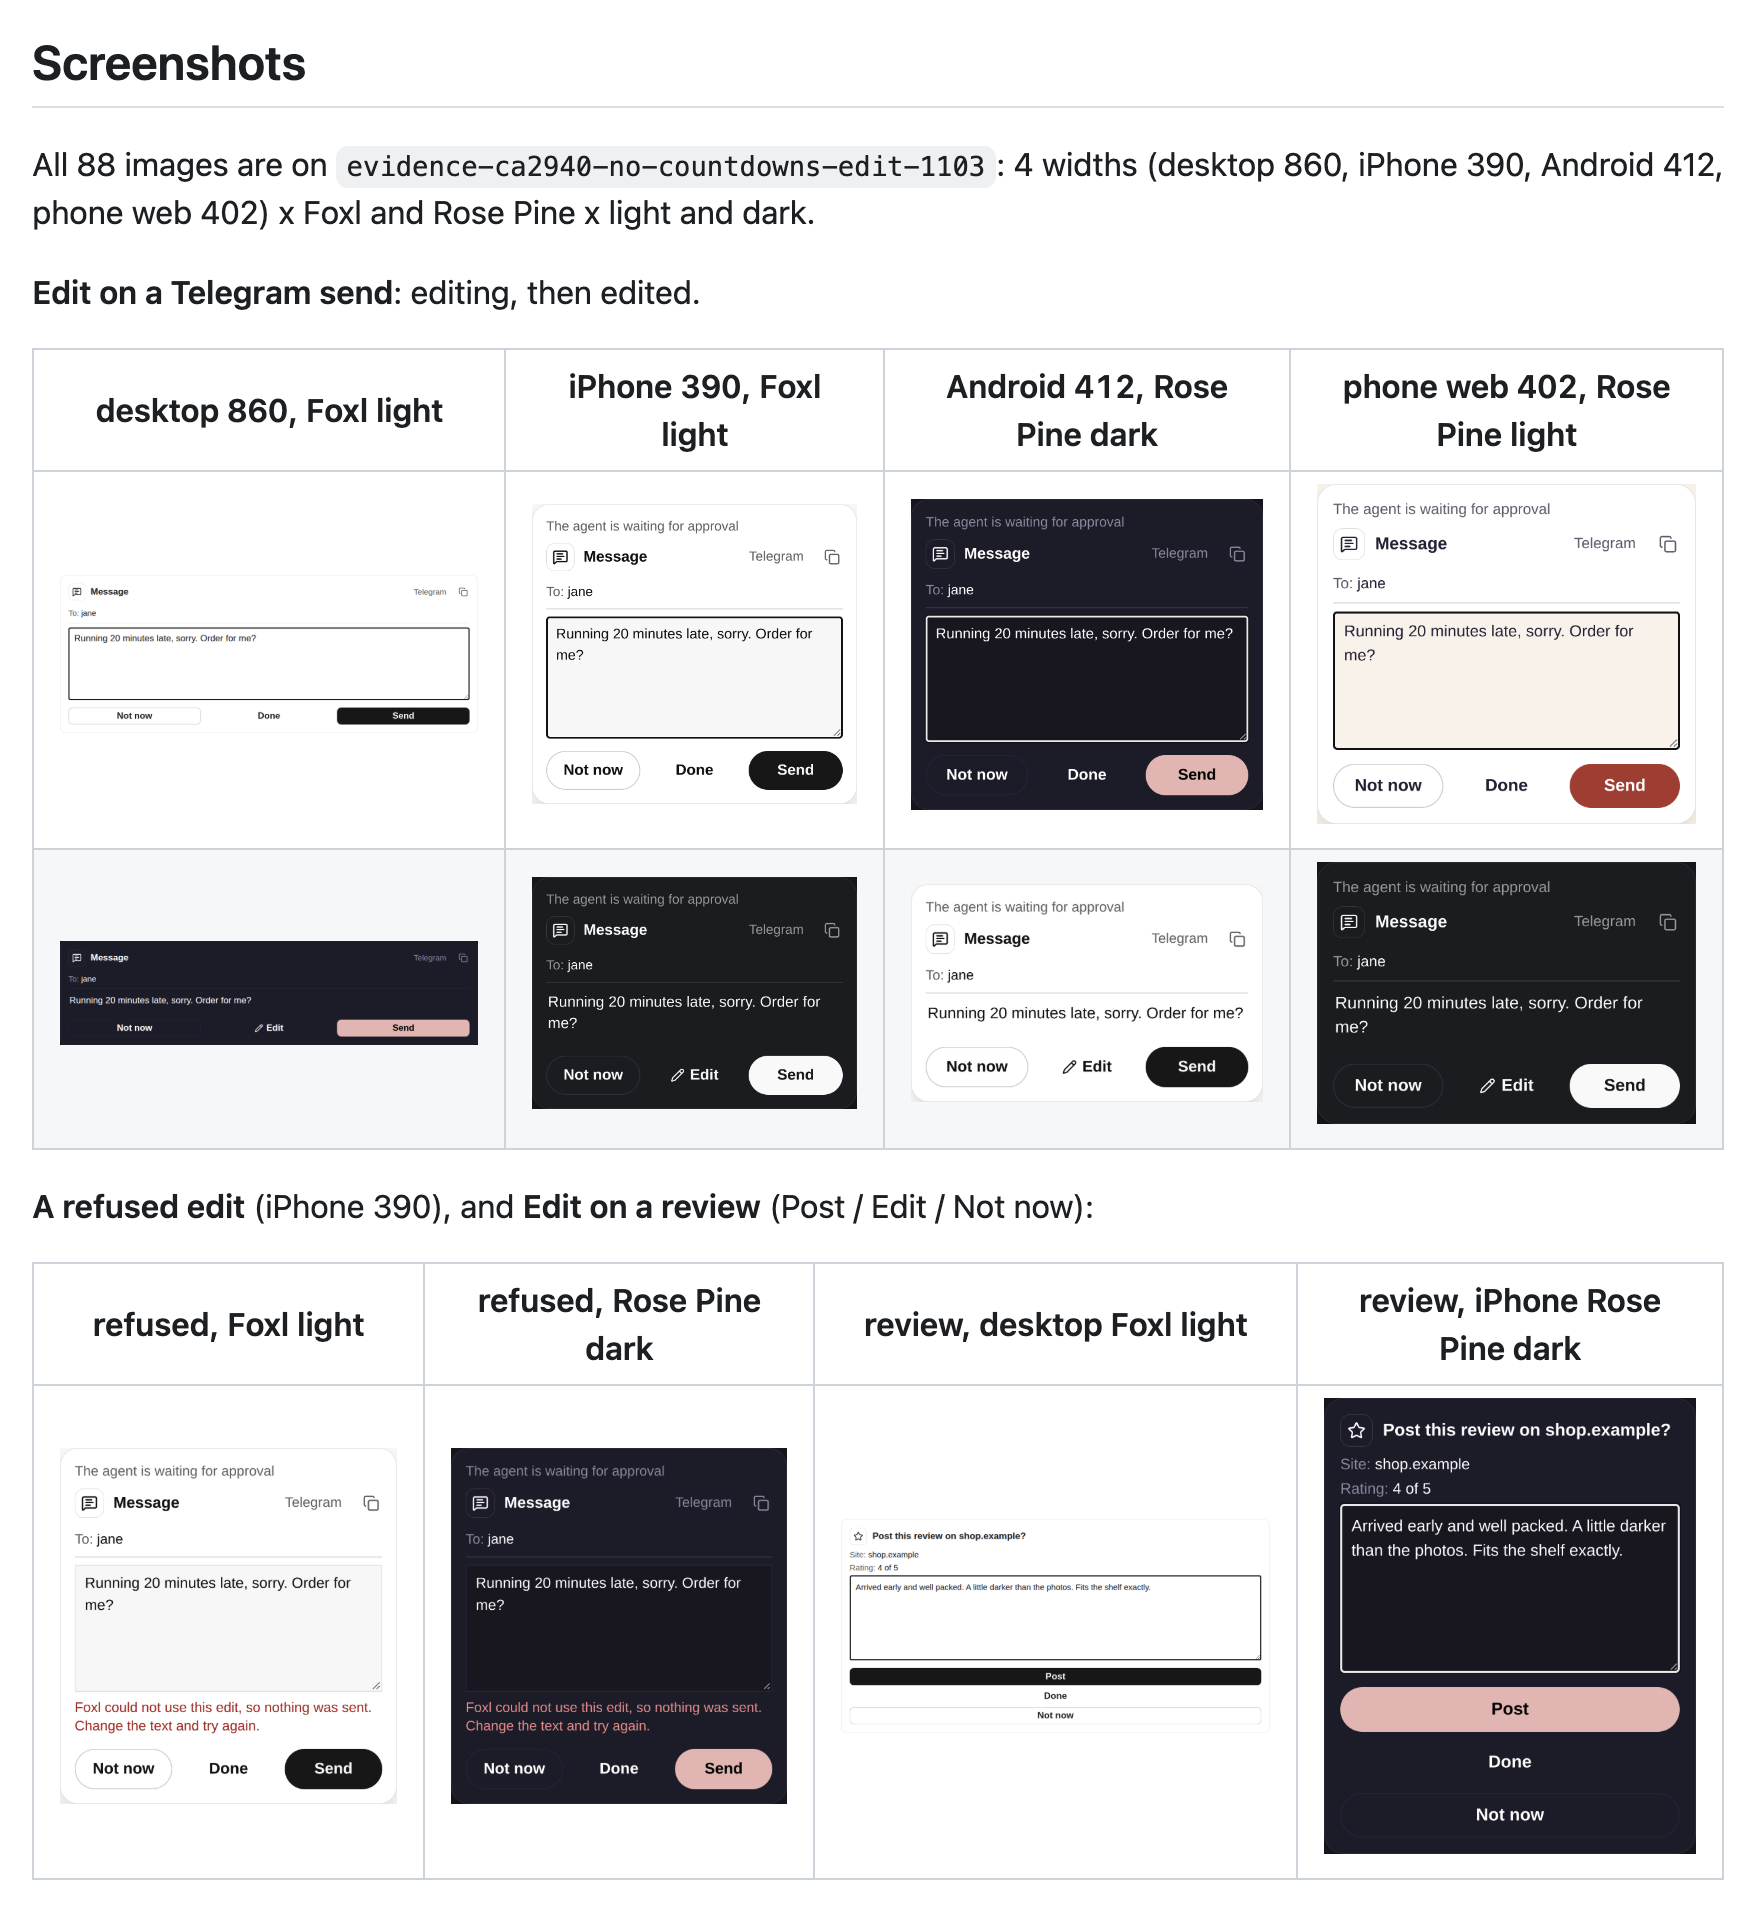
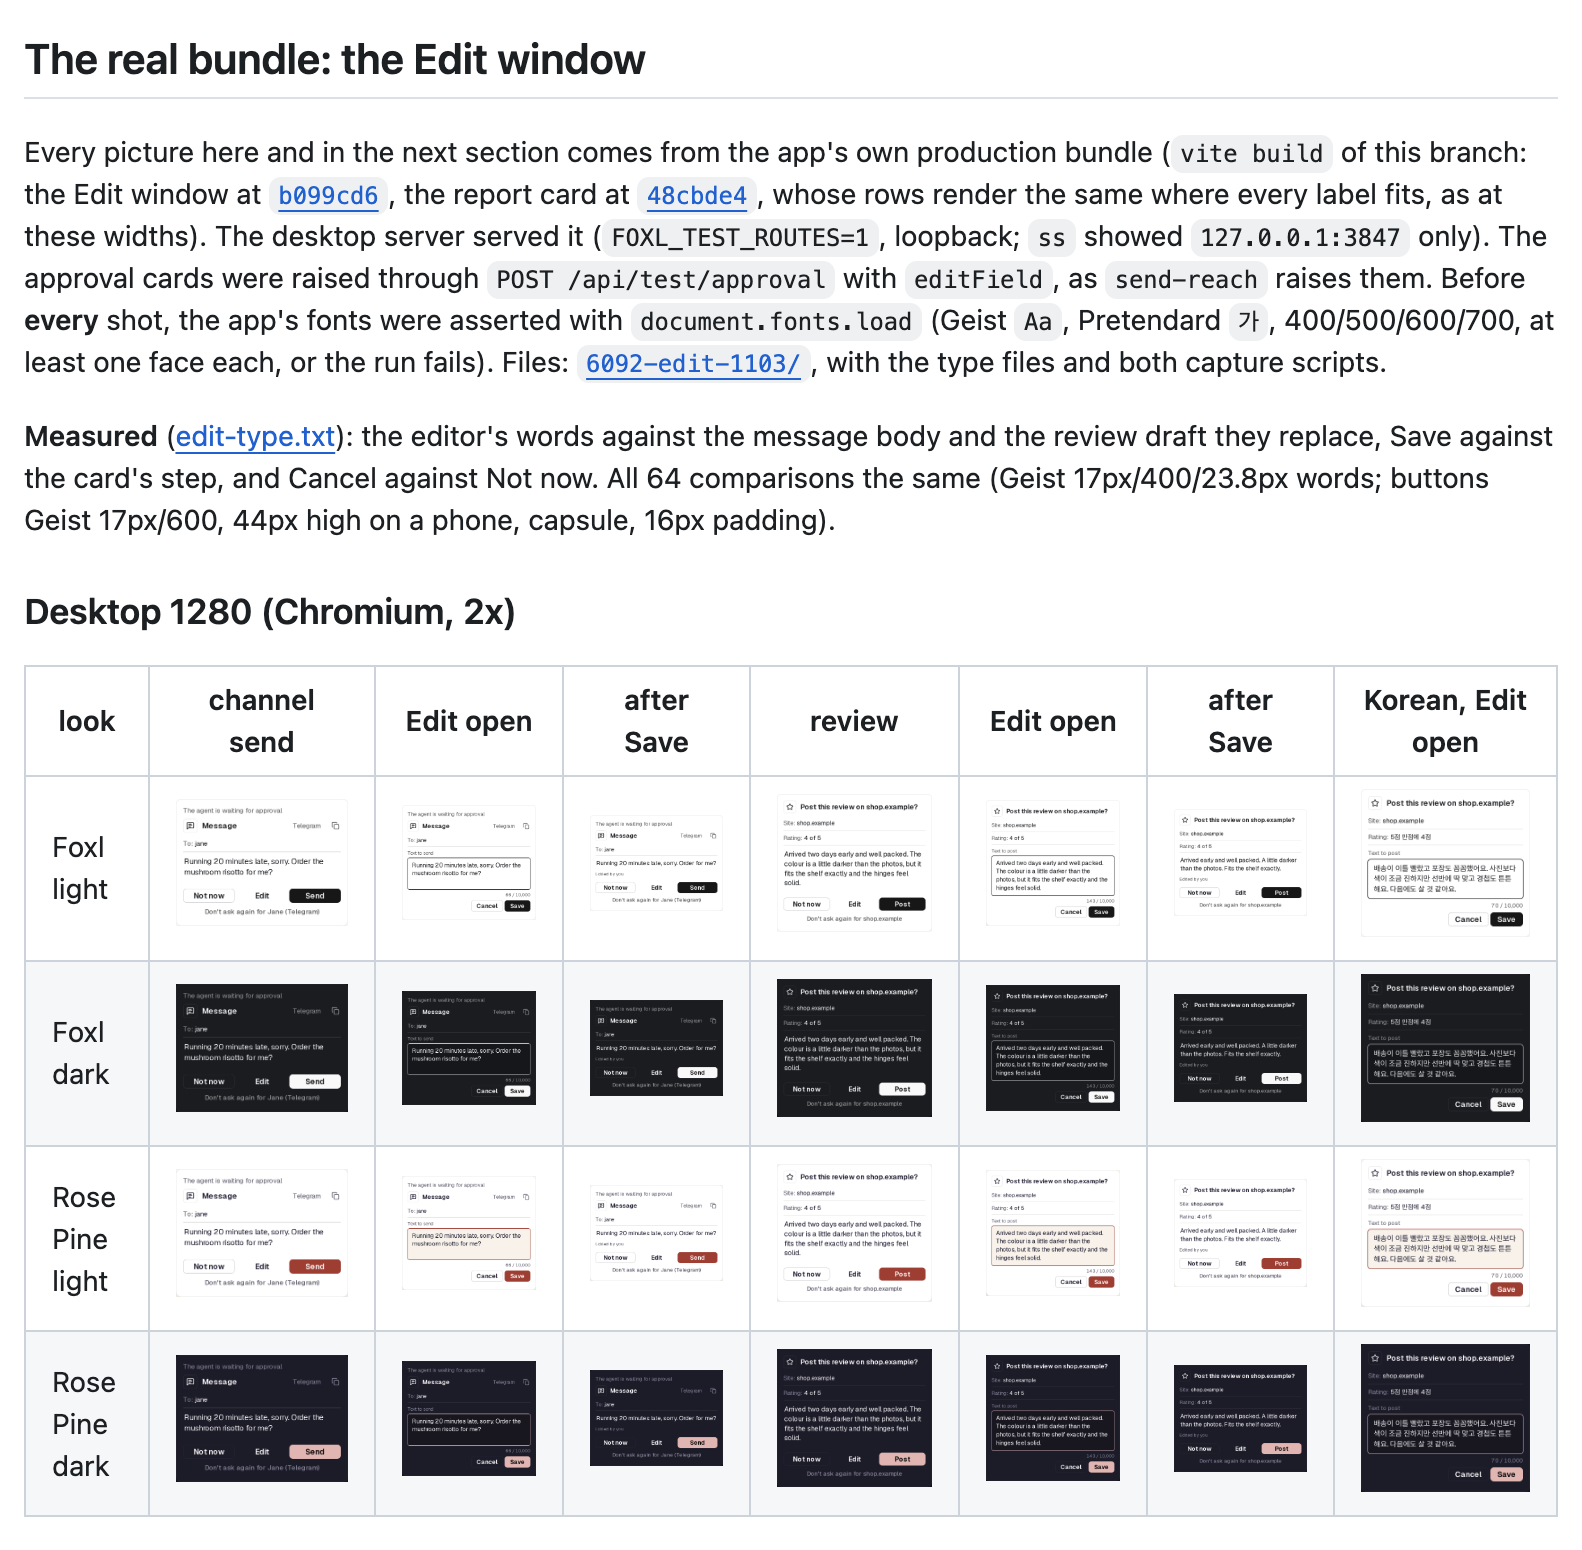
11 月 3 日早上就是一例。UTC 04:59,一个拉取请求带着 20 张截图上来,截的是发布评价那张卡片上的新编辑窗口。文字用的是另一种字体,输入框是浏览器自带的,三个按钮在卡片上一个接一个往下排。05:04,我们给协调者发了两行:让作者按设计系统重做这个窗口,把拉取请求退回草稿,再重新提交。十二秒后它就成了草稿。09:30 它回来了,用的是应用自己的草稿编辑器,296 张截图每一张都是在应用字体加载之后截的。11:50 合并。那种字体不是这个拉取请求的问题:它的截图测试工具从来没有提供应用的字体,那天追查原因,我们才找出了上面说的 34 个截图测试工具。
出问题时,我们会把本来能拦住它的规则,连同日期和事故,写进那个领域的 CLAUDE.md,然后找出能让脚本来强制执行它的地方。可以撤回的决定由智能体看代码来做,并写下它们的决定。不可撤回的事,以及跟钱有关的事,都要等人来定。一个拉取请求如果会让 Foxl 比人们拿来比较的产品更不方便,哪怕代码没错,也会被搁置。
还没解决的部分
评审是智能体,但它们用的标准是人写的,它们的结论也仍由人来读。现在,这一步是拉取请求和发布之间最慢的环节。所以我们正在为每类声明写一条标准,让别的智能体不用人也能检查:逻辑修复,要有在修复前失败、在合并后列车上通过的测试;厂商 API,要有来自真实服务的抓包;任何给人看的东西,要有用真实字体从真实构建里截的图;成本,要有实测的请求数;发布,要有每个目的地的回答。不可撤回的事,以及跟钱有关的事,仍然由人来管。
我们还不知道怎么判断一条标准什么时候算够好。计划是像评估测试一样评估评审:数一数每个评审找出了多少 CI 漏掉的阻断问题,以及人推翻它的结论有多频繁。一旦人在某类声明上不再推翻一个评审,那条标准就不再需要人了。这两个数字我们现在都还没有。