Ce que nous avons appris en construisant une usine logicielle IA
L’équipe Foxl publie des dizaines de versions par mois grâce à une usine logicielle IA où 15 à 20 agents de programmation travaillent en même temps. Écrire le code était la partie facile ; savoir s’il était juste a été bien plus difficile. Voici ce que nous avons appris en construisant les vérifications.
Sur cette page
L’équipe Foxl publie des dizaines de versions par mois. En octobre, il y en a eu 66, dont 22 stables et 44 bêtas. Chaque version embarque l’app de bureau pour Windows, macOS et Linux, et chaque version stable embarque aussi les apps iOS et Android et l’app web. À chaque fois, il faut vérifier que tout cela fonctionne.
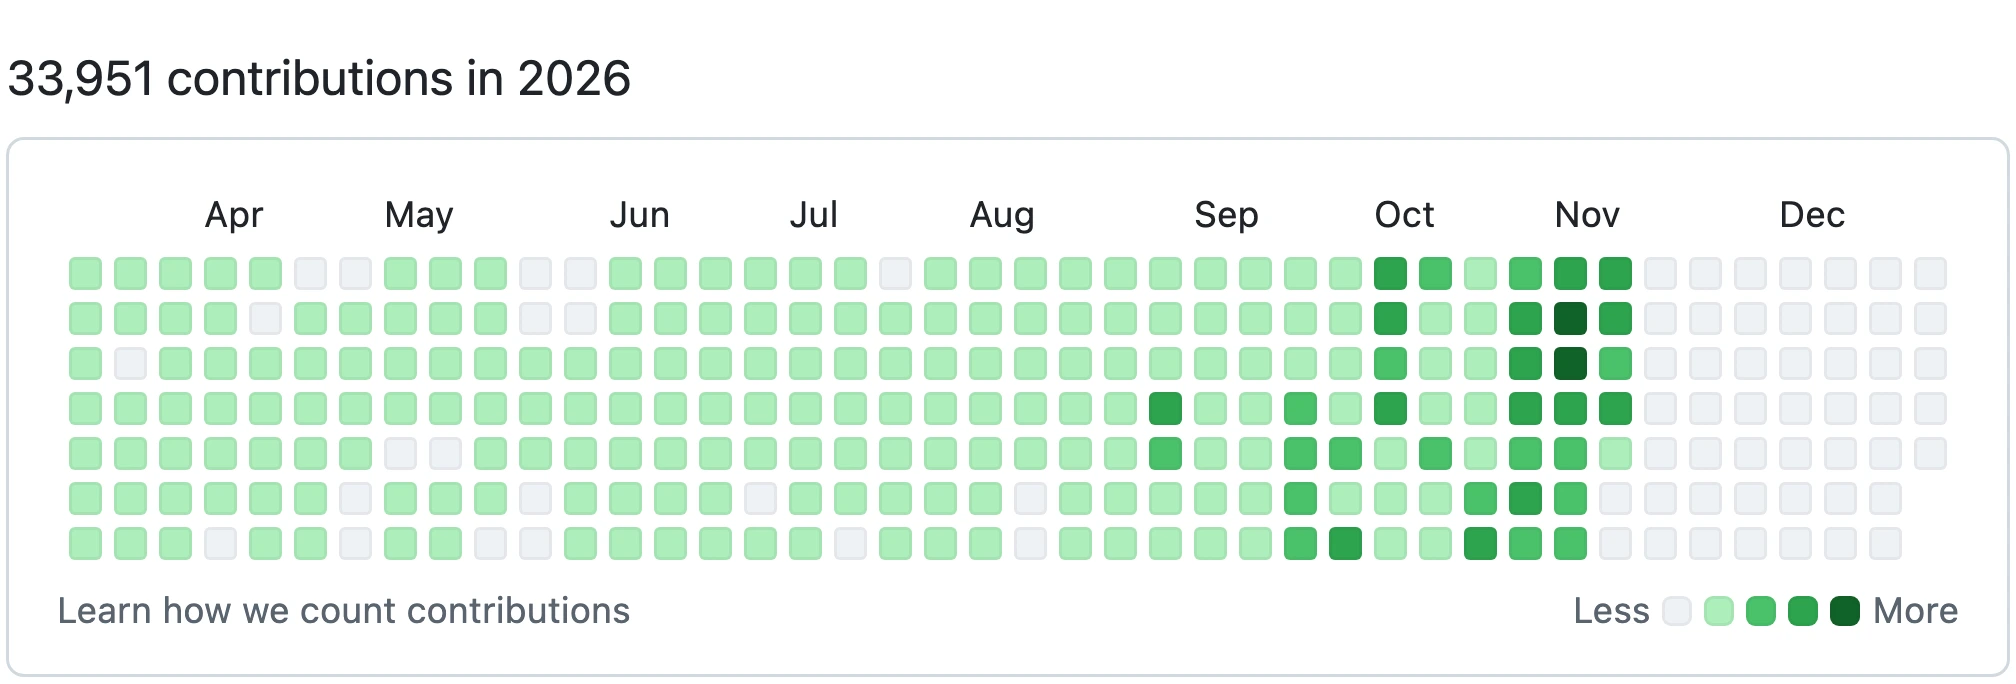
Le même mois, 2 140 pull requests ont été ouvertes dans notre dépôt et 2 040 ont été fusionnées, soit près de 70 ouvertes par jour. L’essentiel de ce code a été écrit par des agents de programmation, pas par des personnes : 15 à 20 sessions Claude Code ouvertes en même temps sur un seul Mac, chacune sur sa propre branche. Le graphique de contributions du compte GitHub sous lequel ces sessions font leurs commits montre le changement d’un coup d’œil. Les deux années précédentes, il comptait quelques centaines de contributions. Cette année, il dépasse 30 000.
Un développement où des agents planifient le travail, écrivent le code, le testent et le relisent, c’est ce qu’on a pris l’habitude d’appeler une usine logicielle IA. Les personnes décident de ce qu’on construit et ont le dernier mot sur ce qui sort. La nôtre fonctionne ainsi. Mais une fois le code confié aux agents, en mars, le plus difficile ne s’est pas révélé être de l’écrire. C’était de savoir si le code écrit par les agents était vraiment juste, et s’il tenait sur les cinq plateformes.
Cet article raconte ce que nous avons appris en construisant ces vérifications. En bref : toutes les règles que nous nous sommes contentés d’écrire pour les agents ont été enfreintes. La plupart n’ont pas tenu plus de quelques jours. Ce qui a tenu, ce sont des vérifications placées exactement sur le chemin par lequel une erreur était arrivée, et l’erreur suivante arrivait presque toujours par un chemin qui n’avait pas encore de vérification.
D’une session à vingt
Pendant les quatre premiers mois, nous gardions une seule session ouverte toute la journée, et une personne lisait chaque diff dès qu’il arrivait. Presque tout partait directement sur main ; le dépôt ne compte qu’une pull request pour tout le mois de juin. La limite, c’était l’attention humaine. Une session, c’était à peu près tout ce qu’on pouvait suivre correctement.
En juillet, nous avons branché Foxl Code, notre agent de programmation dans le cloud, sur le propre dépôt de Foxl. Chaque tâche avait sa propre VM cloud, et le 22 juillet cette configuration a sorti cinq versions en production en une journée. Ces VM ne contiennent pas macOS, cependant, si bien que tout ce qui demandait Xcode ou le simulateur d’iPhone devait encore revenir sur le Mac.
En août, nous avons changé notre façon de travailler : un git worktree par session et une pull request par changement. Les sessions ont cessé de s’écraser les unes les autres, si bien que plusieurs pouvaient tourner en même temps, et les pull requests sont passées de 598 en août à 946 en septembre et 2 140 en octobre.
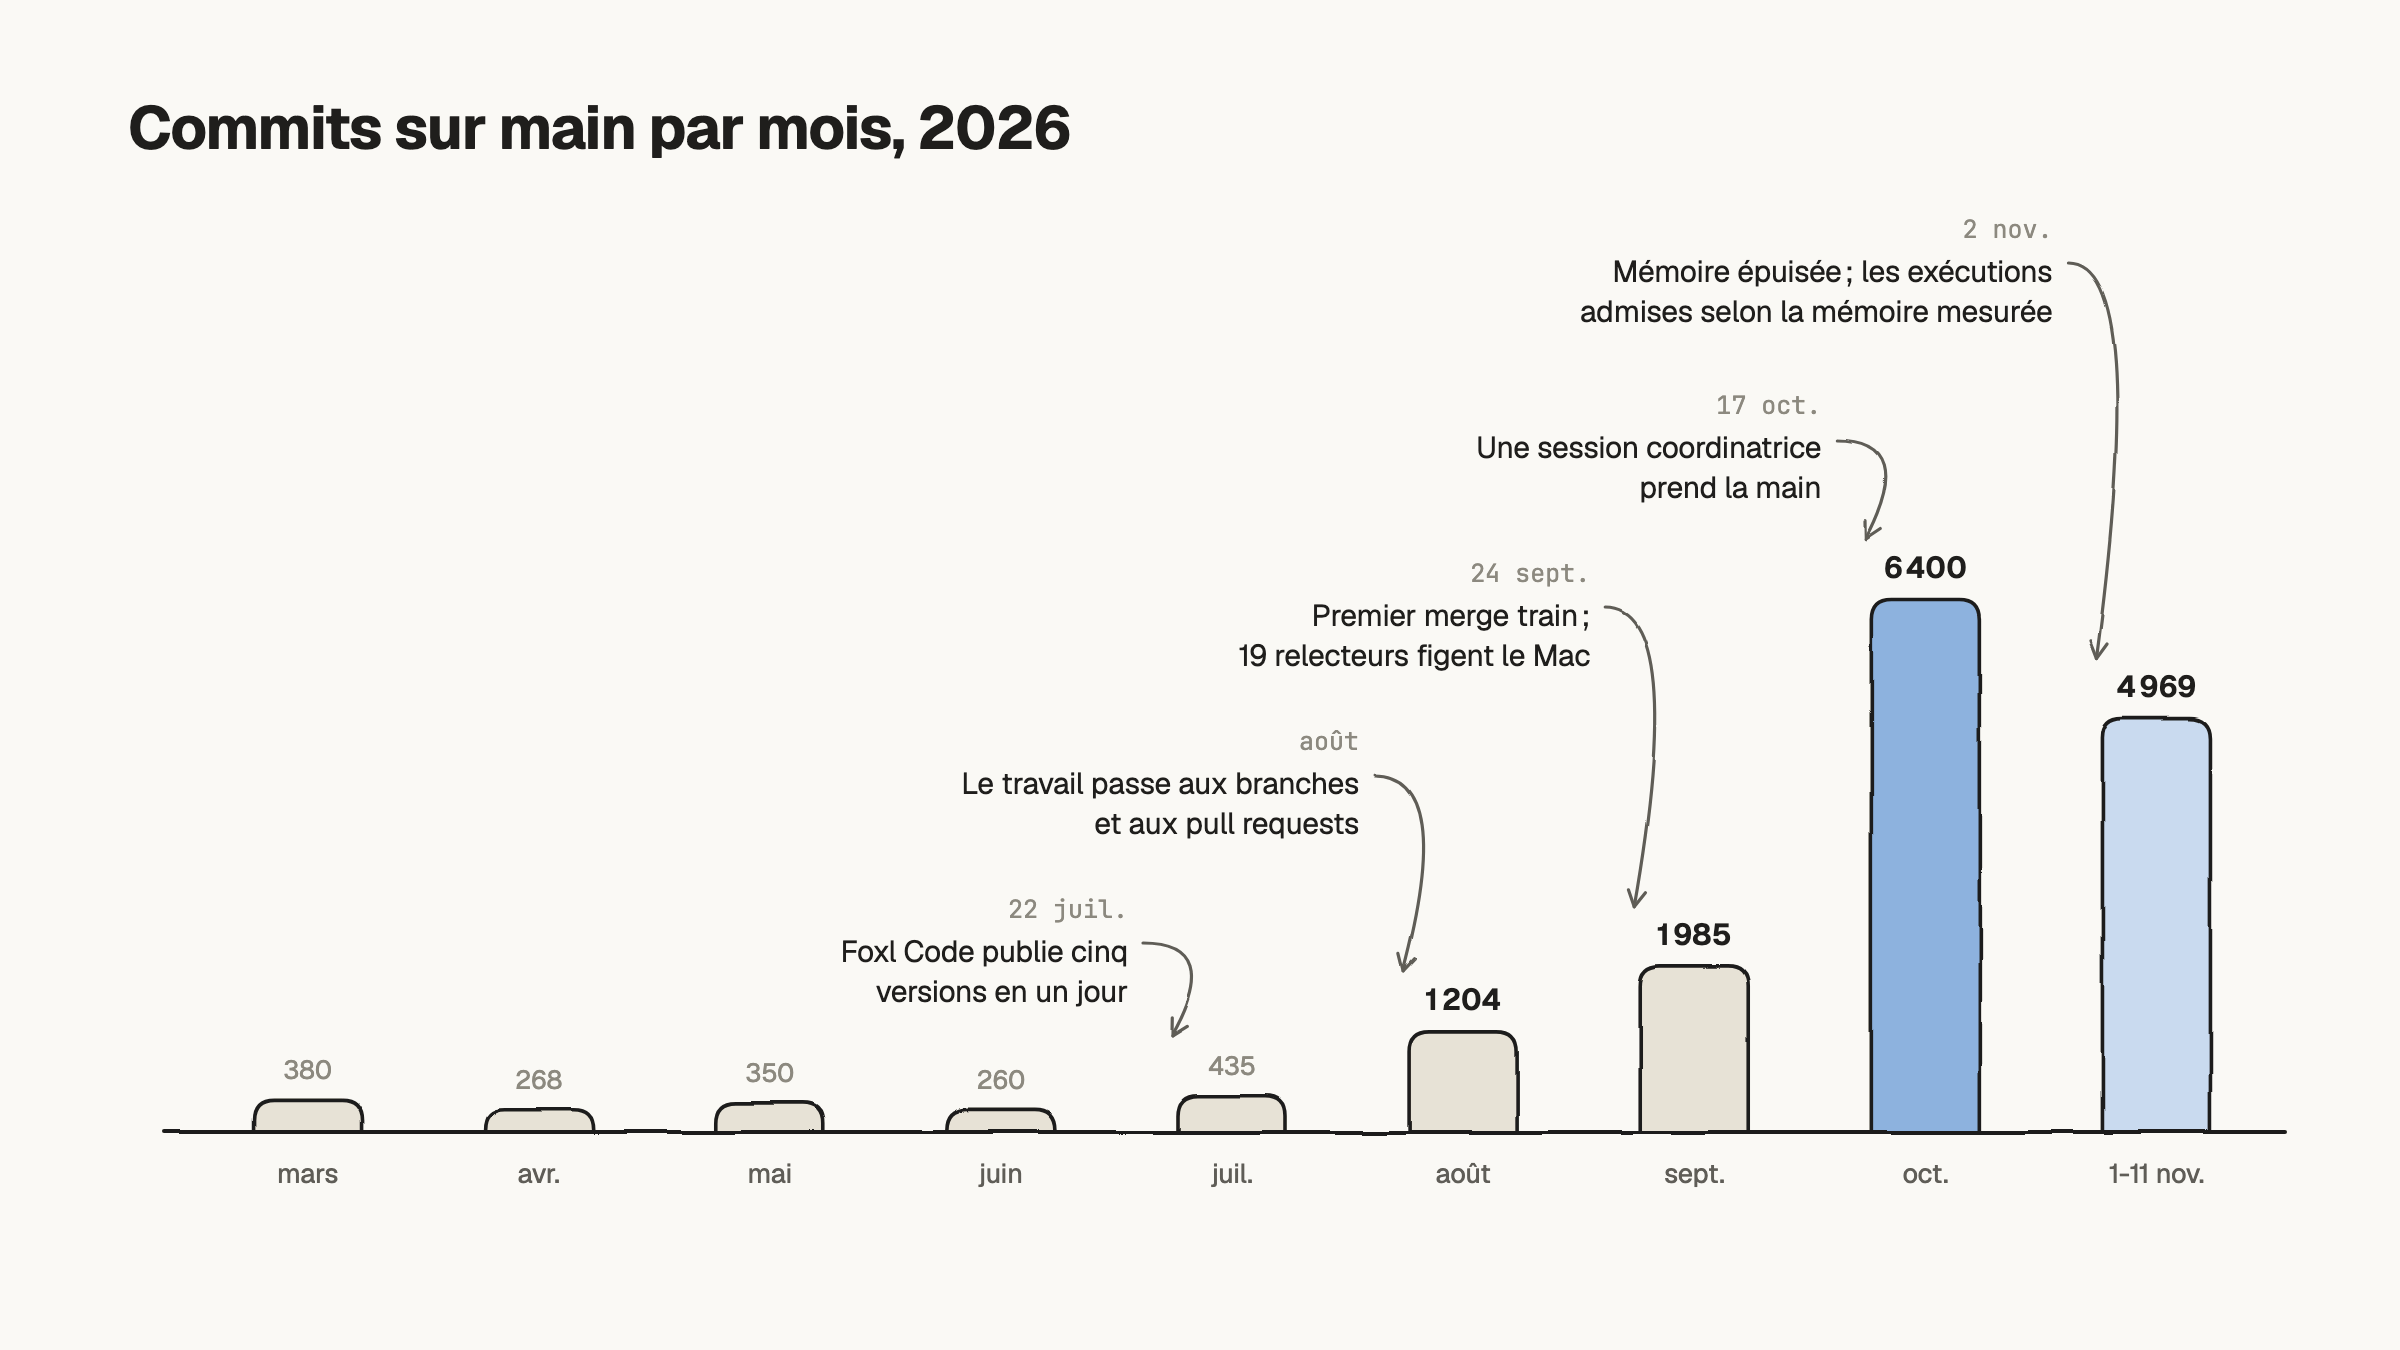
À mesure que les chiffres montaient, de nouveaux problèmes sont apparus. Des sessions modifiaient les mêmes fichiers en même temps, et le Mac manquait de mémoire. Surtout, le premier merge train, le 24 septembre, a montré qu’une CI au vert ne veut pas dire qu’une pull request est juste. Nous y reviendrons plus bas.
L’endroit où l’on peut vérifier décide où l’on travaille
Vérifier cinq plateformes commence par avoir des machines capables de les faire tourner. Nous en utilisons trois types, et chacun peut vérifier des choses différentes.
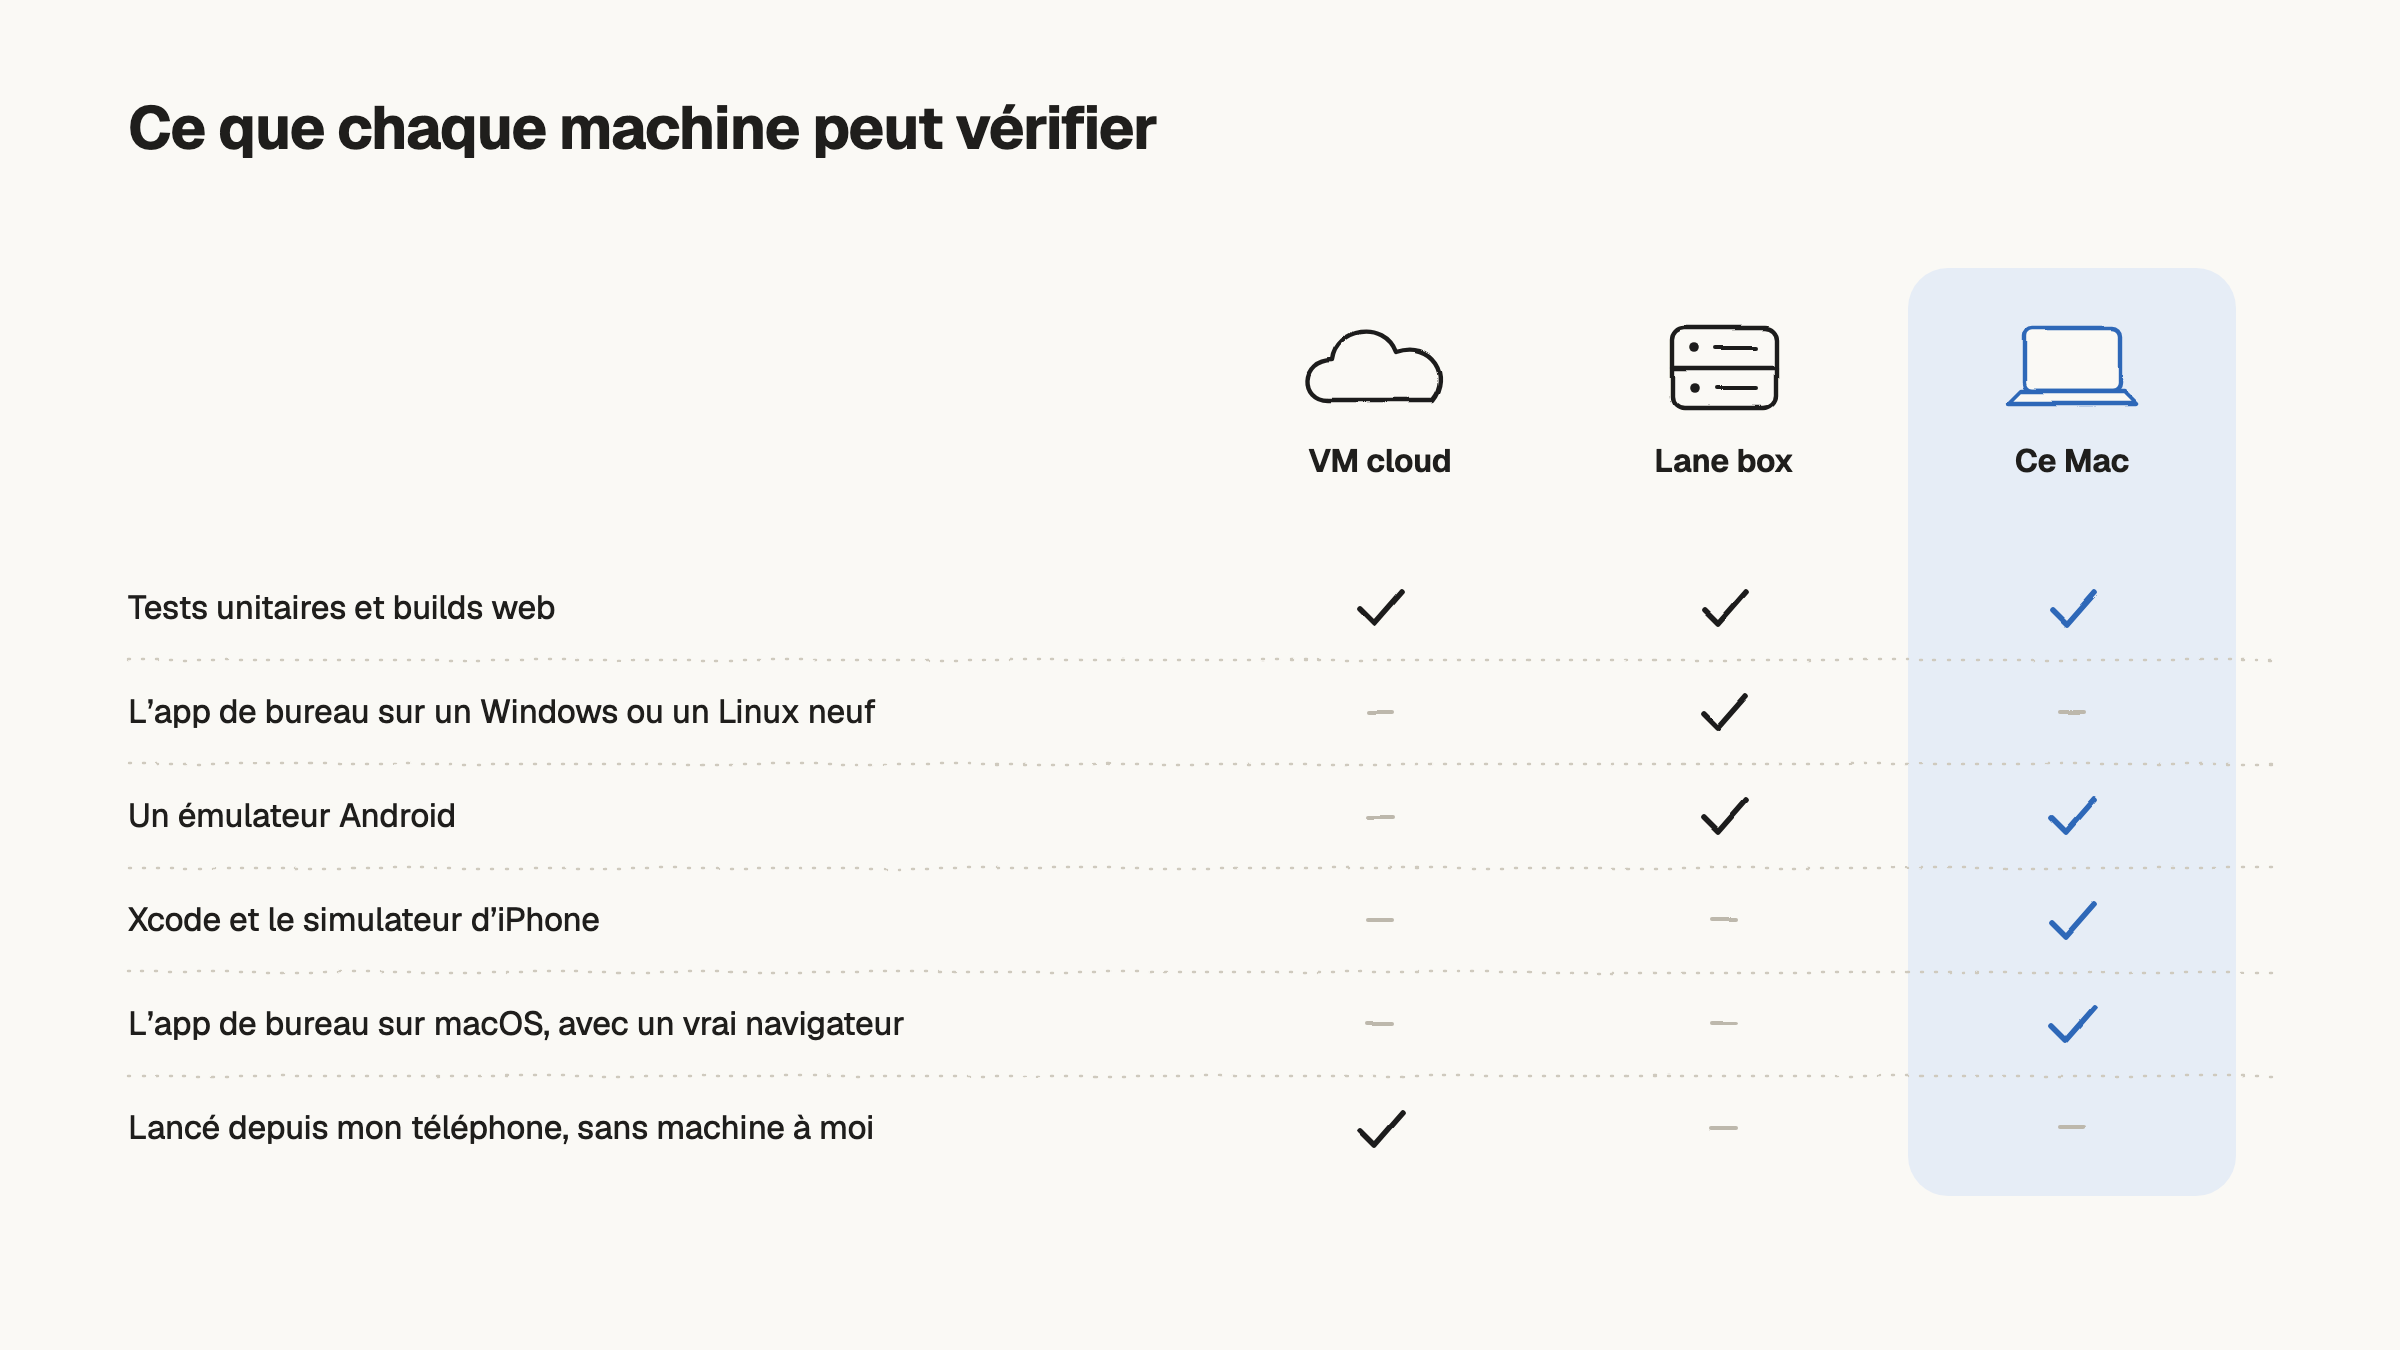
Les VM cloud conviennent au travail Linux isolé, et on peut les lancer directement depuis un téléphone. Quand une session a besoin de l’app de bureau sur un Windows ou un Linux fraîchement installé, ou d’un émulateur Android, elle reçoit une instance EC2 jetable que nous appelons une lane box. Et seul le Mac peut vérifier tout le reste : Xcode, le simulateur d’iPhone, un vrai Chrome et l’app de bureau sur macOS.
La plupart des sessions ont donc fini sur un seul Mac. C’est aussi un ordinateur dont nous nous servons tous les jours : toutes les sessions se partagent la mémoire d’une seule machine et travaillent juste à côté de vraies données.
Lancer des agents, c’est la partie résolue
Les outils pour faire tourner beaucoup d’agents à la fois ne manquent pas. Tous ceux que nous avons regardés rendent l’exécution en parallèle facile, et certains permettent aux agents de se parler. Ils diffèrent par l’endroit où tournent les agents, et par la part de la vérification de leurs résultats qu’ils prennent en charge.
Claude Code et Codex
Ces deux-là sont les agents eux-mêmes. Claude Code fait tourner des sessions en arrière-plan qui continuent après la fermeture du terminal, chacune dans son propre worktree (claude --bg --worktree), et les sessions peuvent s’envoyer des messages ou lancer des sous-agents. Il existe aussi des sessions cloud, lancées depuis le web ou un téléphone. Codex existe en CLI, en app de bureau et en extensions d’IDE, et Codex Web exécute des tâches dans des conteneurs Linux, dans le cloud d’OpenAI.
Orca
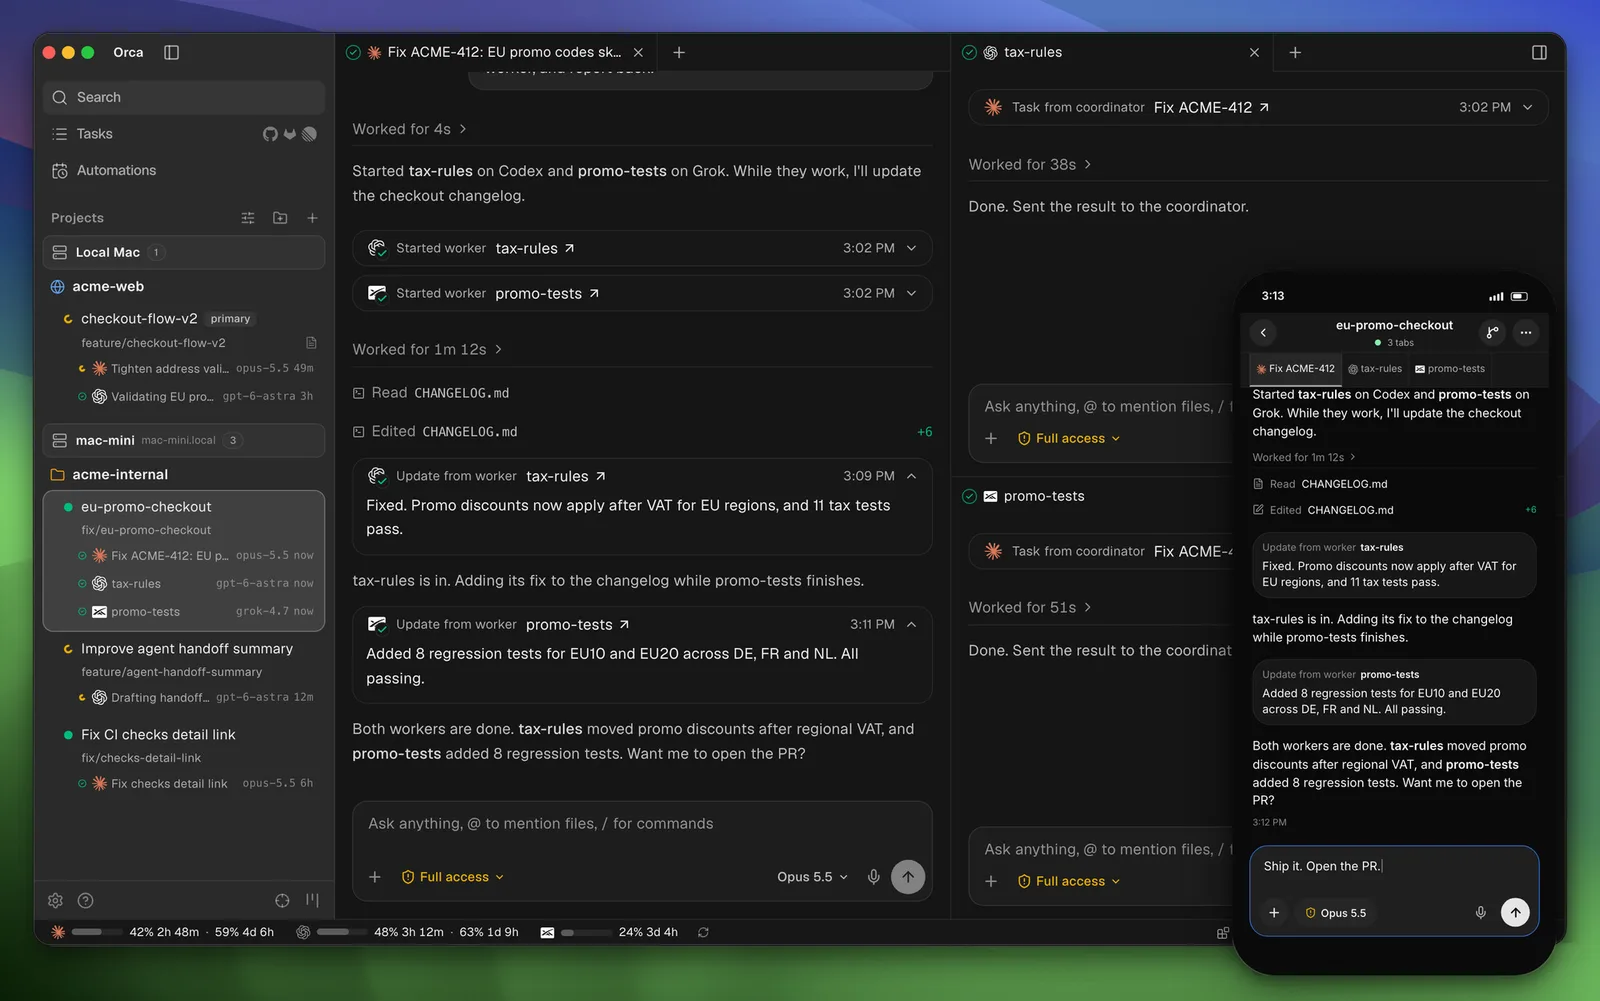
Orca est une app de bureau pour macOS, Windows et Linux. Elle fait tourner en parallèle des agents en CLI comme Claude Code ou Codex, chacun dans son propre worktree, et quand on lui confie une grosse tâche, un agent coordinateur répartit le travail entre des workers et rapporte leurs résultats : c’est la scène de la capture ci-dessus. Les agents peuvent aussi tourner sur un hôte SSH ou sur une VM cloud par worktree, et les vérifications en échec et les commentaires de relecture repartent vers l’agent pour qu’il les corrige.
herdr
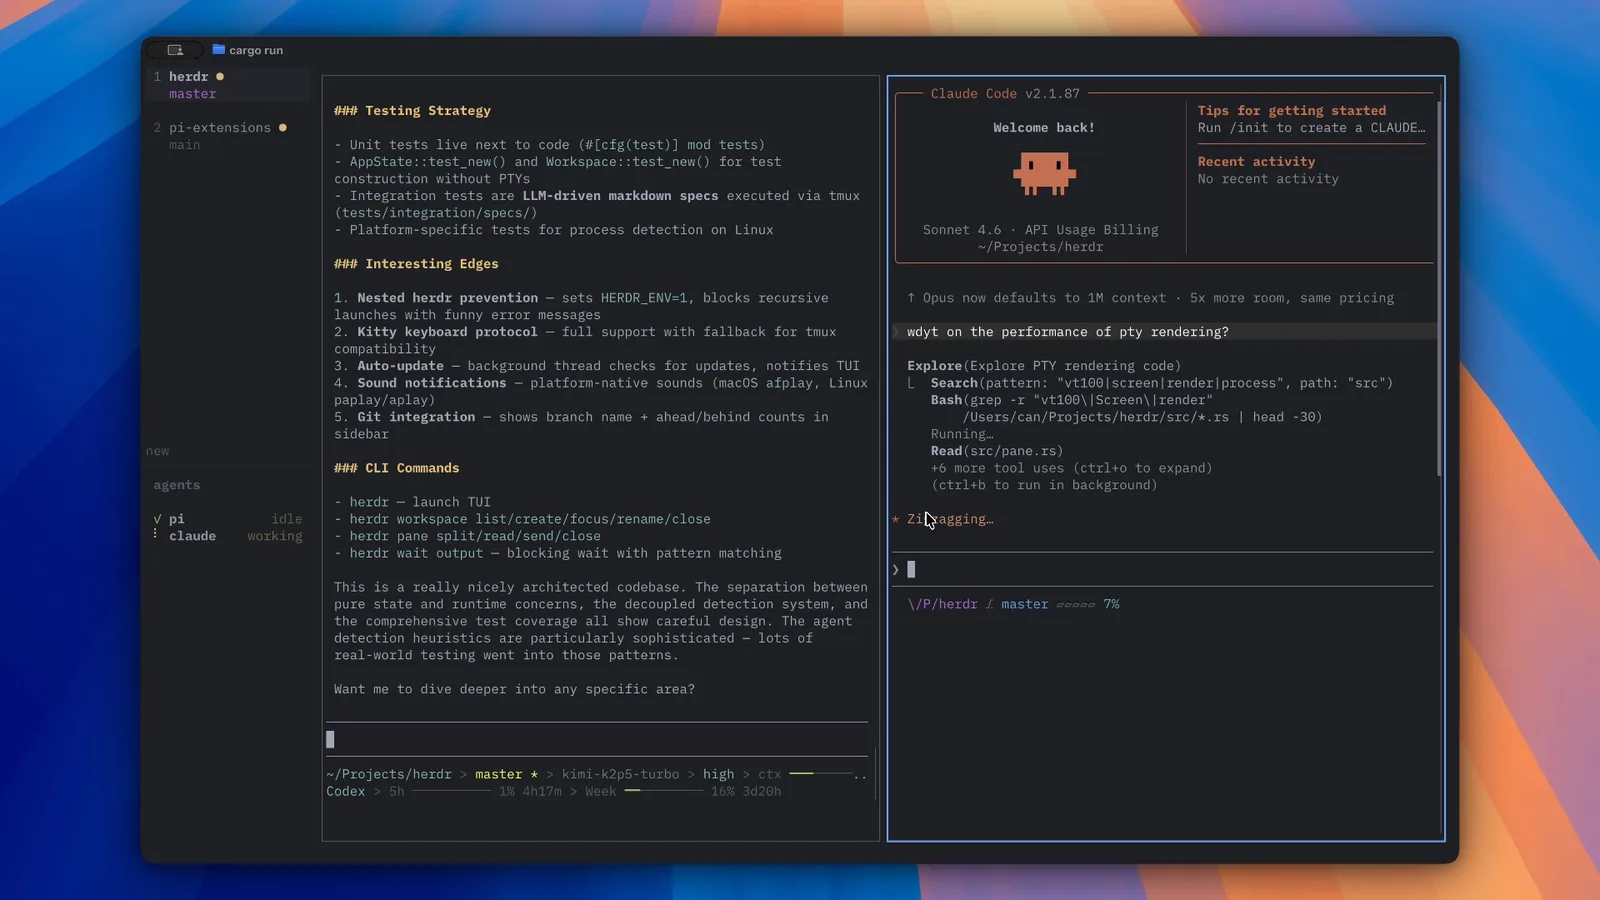
herdr est un runtime de terminal en un seul binaire Rust. Il prend en charge les terminaux au lieu d’envelopper les agents, si bien qu’il fonctionne de la même façon avec Claude Code, Codex ou OpenCode. Les terminaux continuent de tourner en arrière-plan quand une connexion SSH tombe, chaque panneau indique si son agent est working, blocked ou idle, et les agents peuvent s’envoyer des prompts via sa CLI et son API de socket.
Kiro Crew
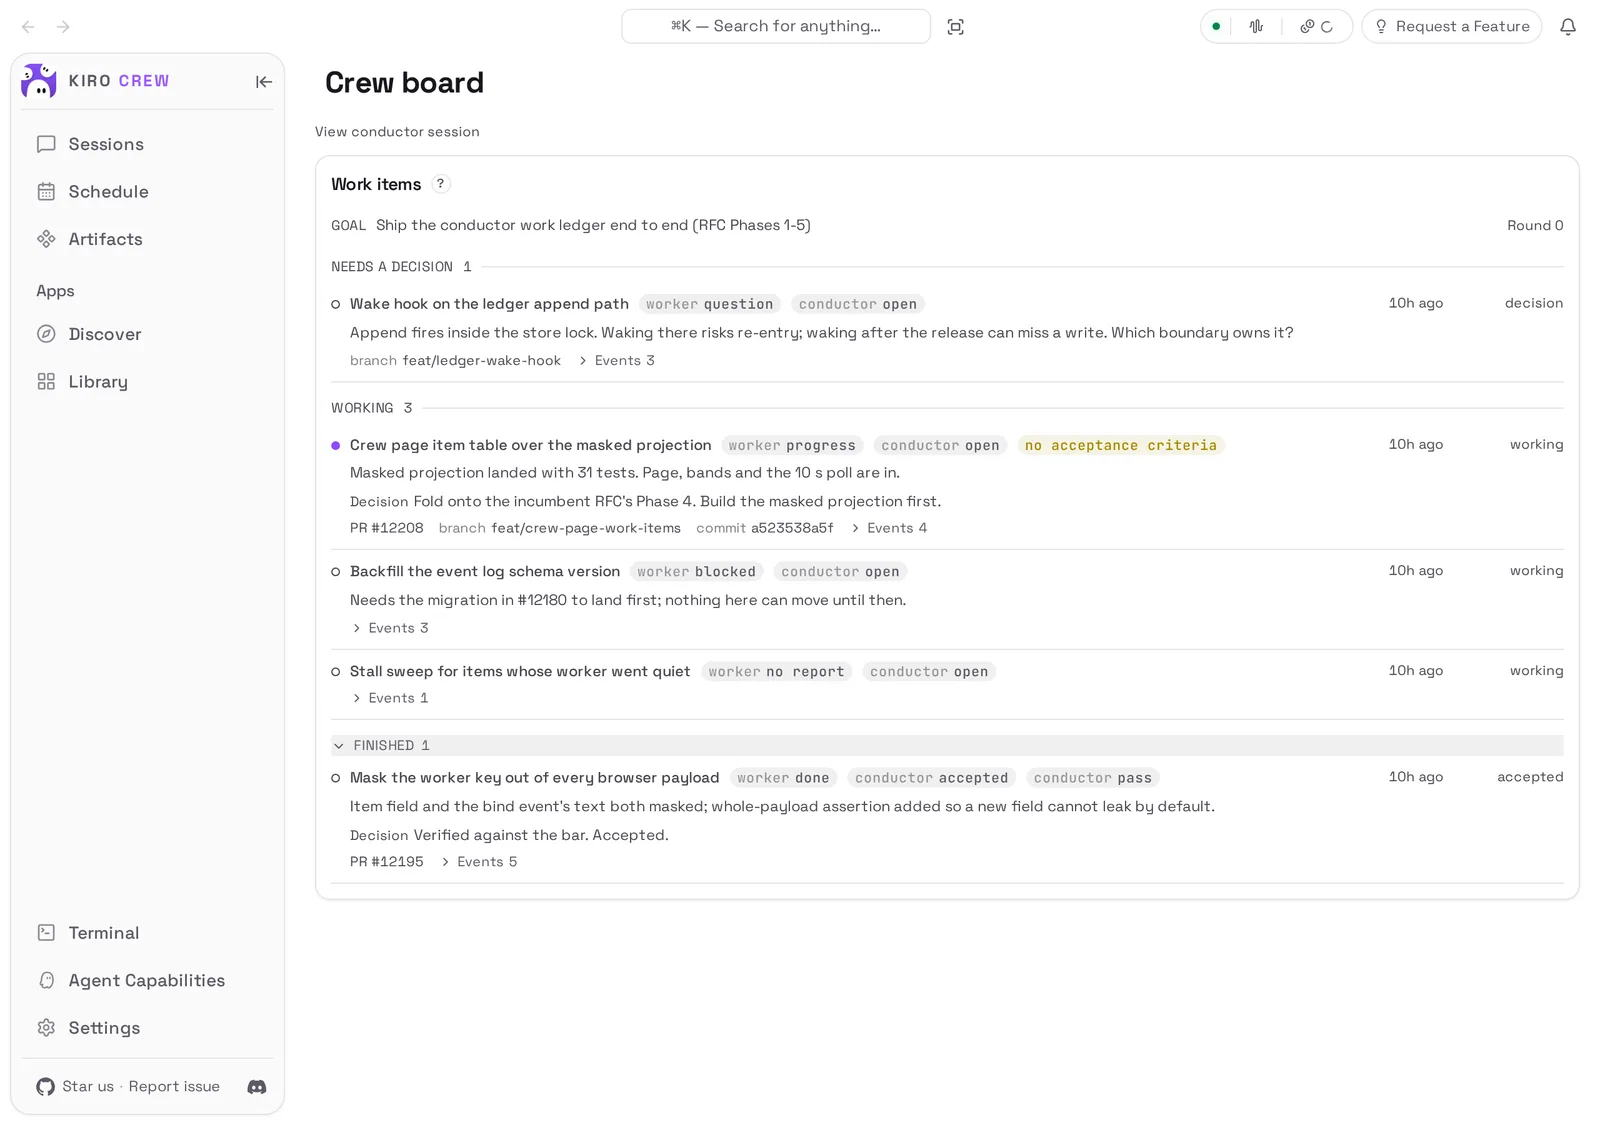
Kiro Crew est un espace de travail qui tourne sur votre propre matériel, un Mac, un conteneur ou une machine distante, et continue de travailler entre les conversations. Les sessions, la mémoire et les points de reprise des tâches survivent aux redémarrages, et les corrections s’accumulent en leçons qui changent ce qu’il fait ensuite. Son crew board, ci-dessus, montre chaque élément distribué par le conductor à côté de ce que le worker a rapporté, et indique si le conductor a accepté le résultat au regard de la barre.
Foxl Code
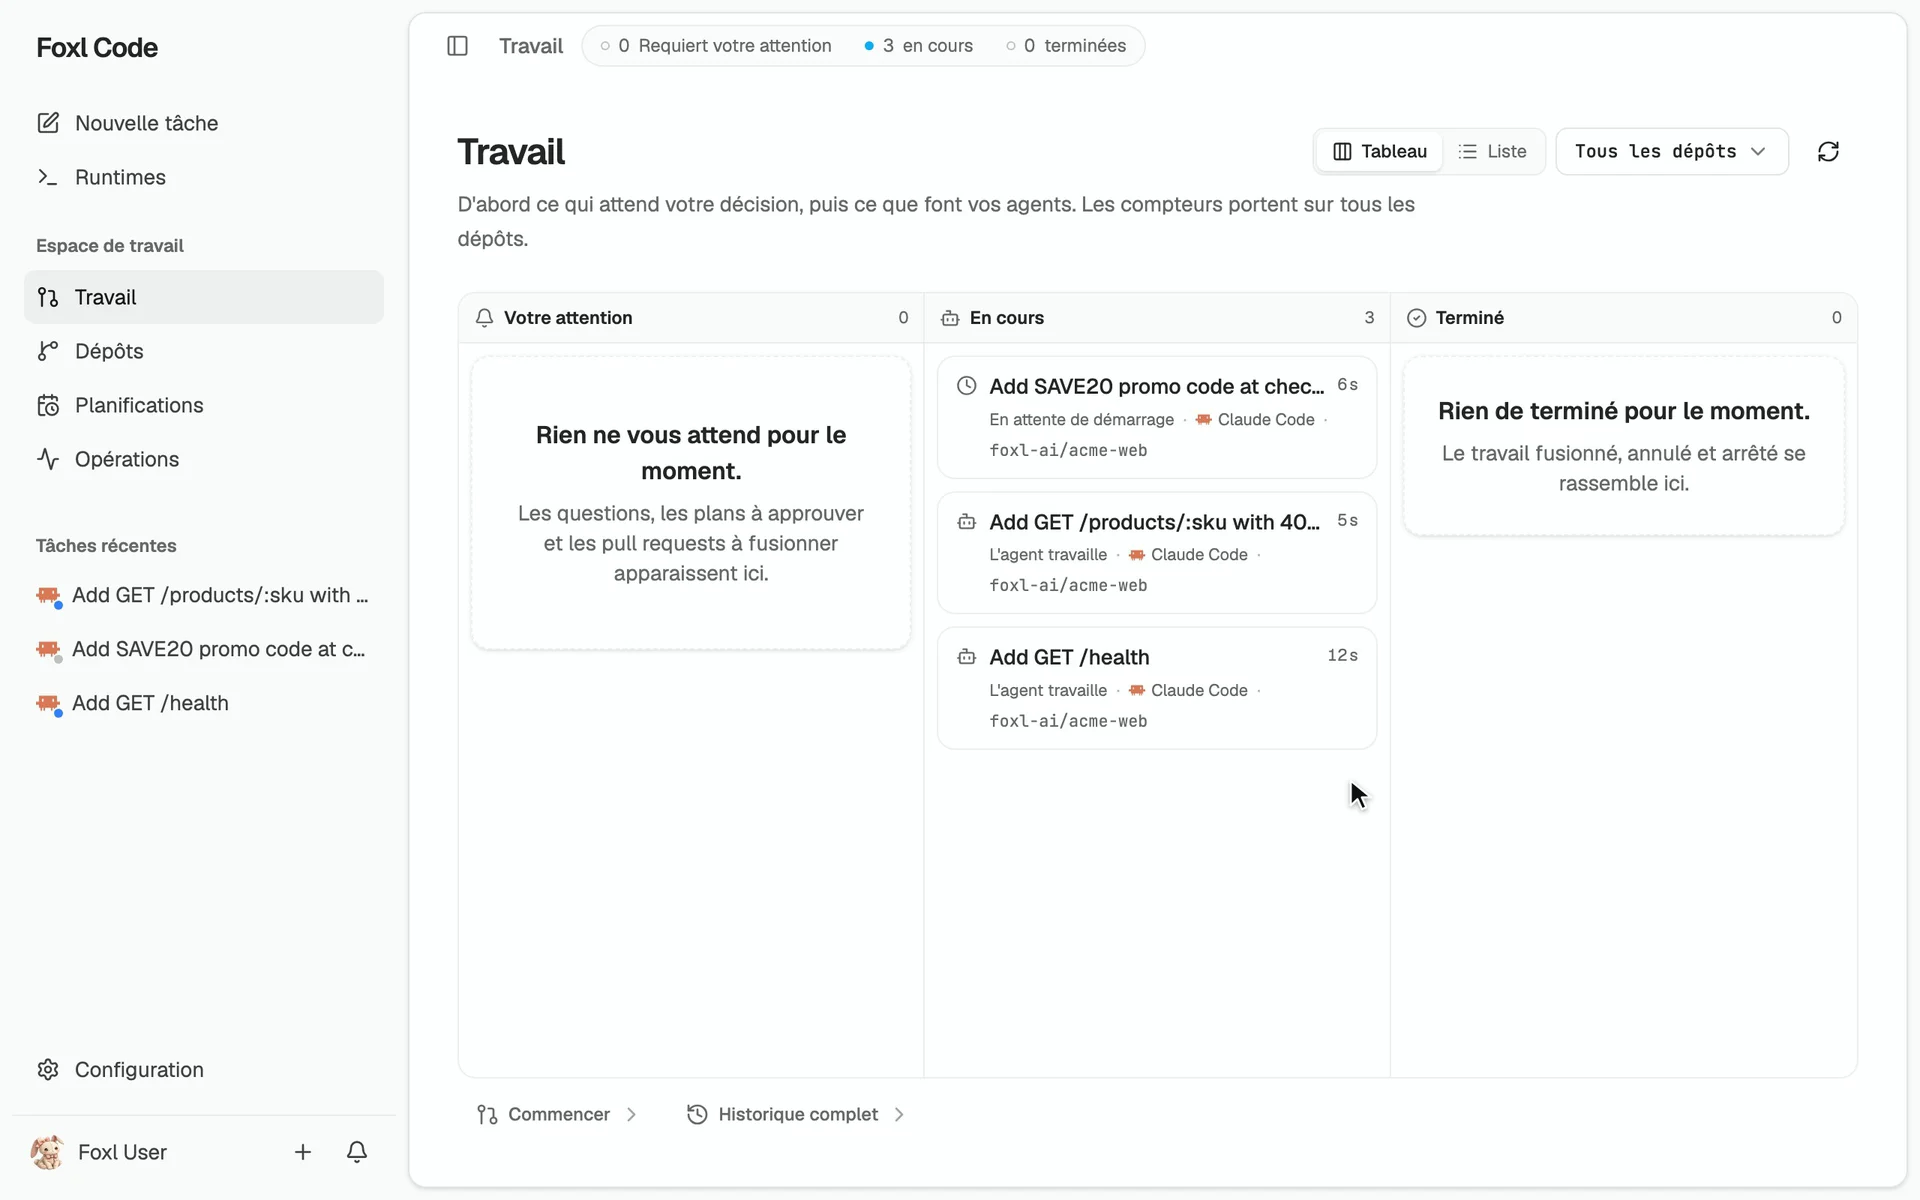
Foxl Code est le produit cloud dont nous parlions plus haut, en bêta privée pour des comptes invités. Vous décrivez une tâche depuis un navigateur ou votre téléphone, et un agent comme Claude Code y travaille dans sa propre VM. Une demande plus large est découpée en sous-tâches indépendantes qui démarrent en même temps, une pull request chacune ; le tableau ci-dessus montre une demande quelques secondes après son découpage en trois. Le relecteur lit le MERGE-REVIEW.md du dépôt depuis la branche par défaut, jamais depuis la pull request, si bien qu’un changement ne peut pas réécrire la barre au regard de laquelle il est noté. Chaque pull request reste pourtant vérifiée seule : pour en tester plusieurs une fois fusionnées ensemble, on demande un merge train dans le chat.
Côte à côte :
| Outil | Où tournent les agents | Points forts | Limites |
|---|---|---|---|
| Claude Code | Votre machine, ou une session cloud lancée depuis le web ou un téléphone | Des sessions en arrière-plan dans leurs propres worktrees, qui se listent et s’envoient des messages ; des sous-agents | Ses messages n’atteignent que des sessions Claude Code |
| Codex | Votre machine, ou le cloud d’OpenAI | Un même agent dans une CLI, une app de bureau, des IDE et le cloud | Les tâches cloud tournent dans un conteneur Linux, donc le travail sous Xcode reste en local |
| Orca | Votre machine, un hôte SSH, ou une VM cloud par worktree | N’importe quel agent en CLI ; un coordinateur qui répartit une tâche entre des workers ; une app mobile ; les vérifications en échec renvoyées à l’agent | Rien dans sa description ne teste plusieurs pull requests fusionnées ensemble |
| herdr | Votre machine et des hôtes SSH | Se place sous n’importe quel agent : terminaux qui survivent à la déconnexion, working, blocked ou idle par panneau, agents qui s’envoient des prompts | Gère les terminaux, pas le travail : il n’ajoute aucune étape de relecture ni de fusion |
| Kiro Crew | Votre Mac, un conteneur, ou une machine distante | Sessions, mémoire et points de reprise qui survivent aux redémarrages ; leçons tirées des corrections ; un conductor qui accepte le travail au regard d’une barre | Pas encore de canaux entre workers |
| Foxl Code | Une VM par tâche, dans le cloud de Foxl | Démarrer depuis son téléphone ; des sous-tâches en parallèle, une pull request chacune ; un relecteur tenu par la barre de fusion du dépôt | Bêta privée ; pas de macOS ; les pull requests ne sont testées ensemble que dans un merge train demandé |
Nous avons construit notre usine sur les sessions de Claude Code lui-même. Elle est née d’une seule session Claude Code, et les sessions sur ce Mac savaient déjà se lister et s’envoyer des messages, juste à côté de Xcode et des simulateurs.
Deux choses ne changent pas, quel que soit l’outil qui fait tourner les agents. Les agents d’une même machine doivent se partager sa mémoire, et quelqu’un doit décider si ce qu’ils ont fait est juste. Le reste de cet article parle de ces deux choses.
Vingt sessions, la mémoire d’un seul Mac
L’après-midi du 17 octobre, dix-neuf sessions étaient ouvertes. Un build web prend environ 3,5 Go de mémoire, et en dix minutes quatre sessions en ont demandé un. Deux ont lancé des vérifications TypeScript, et une a démarré un simulateur d’iPhone sans demander. Huit sessions avaient des modifications ouvertes dans le même fichier CSS. Cet après-midi-là, nous avons dit aux sessions d’utiliser moins de mémoire, d’attendre leur tour et de demander avant de s’en servir.
Le même jour, une session est devenue le coordinateur. Toutes les autres lisent au démarrage un fichier partagé qui dit qui s’occupe de quels fichiers, envoient au coordinateur une ligne avec leur tâche et les fichiers qu’elles comptent toucher, et reçoivent un périmètre en retour. Une session qui a besoin d’un fichier détenu par une autre envoie à celle-ci le changement à appliquer. Avant tout ce qui consomme beaucoup de mémoire, comme un build, une suite de tests ou un simulateur, elle envoie HEAVY? avec son estimation de la mémoire et des minutes, et attend le GO. Le coordinateur lit la pression mémoire du Mac avant chaque accord.
Voici la file dans laquelle a attendu le premier build de cet article. Un benchmark de modèle et des passages dans le simulateur étaient déjà en ligne, et le build n’a démarré qu’après 50 minutes d’attente.
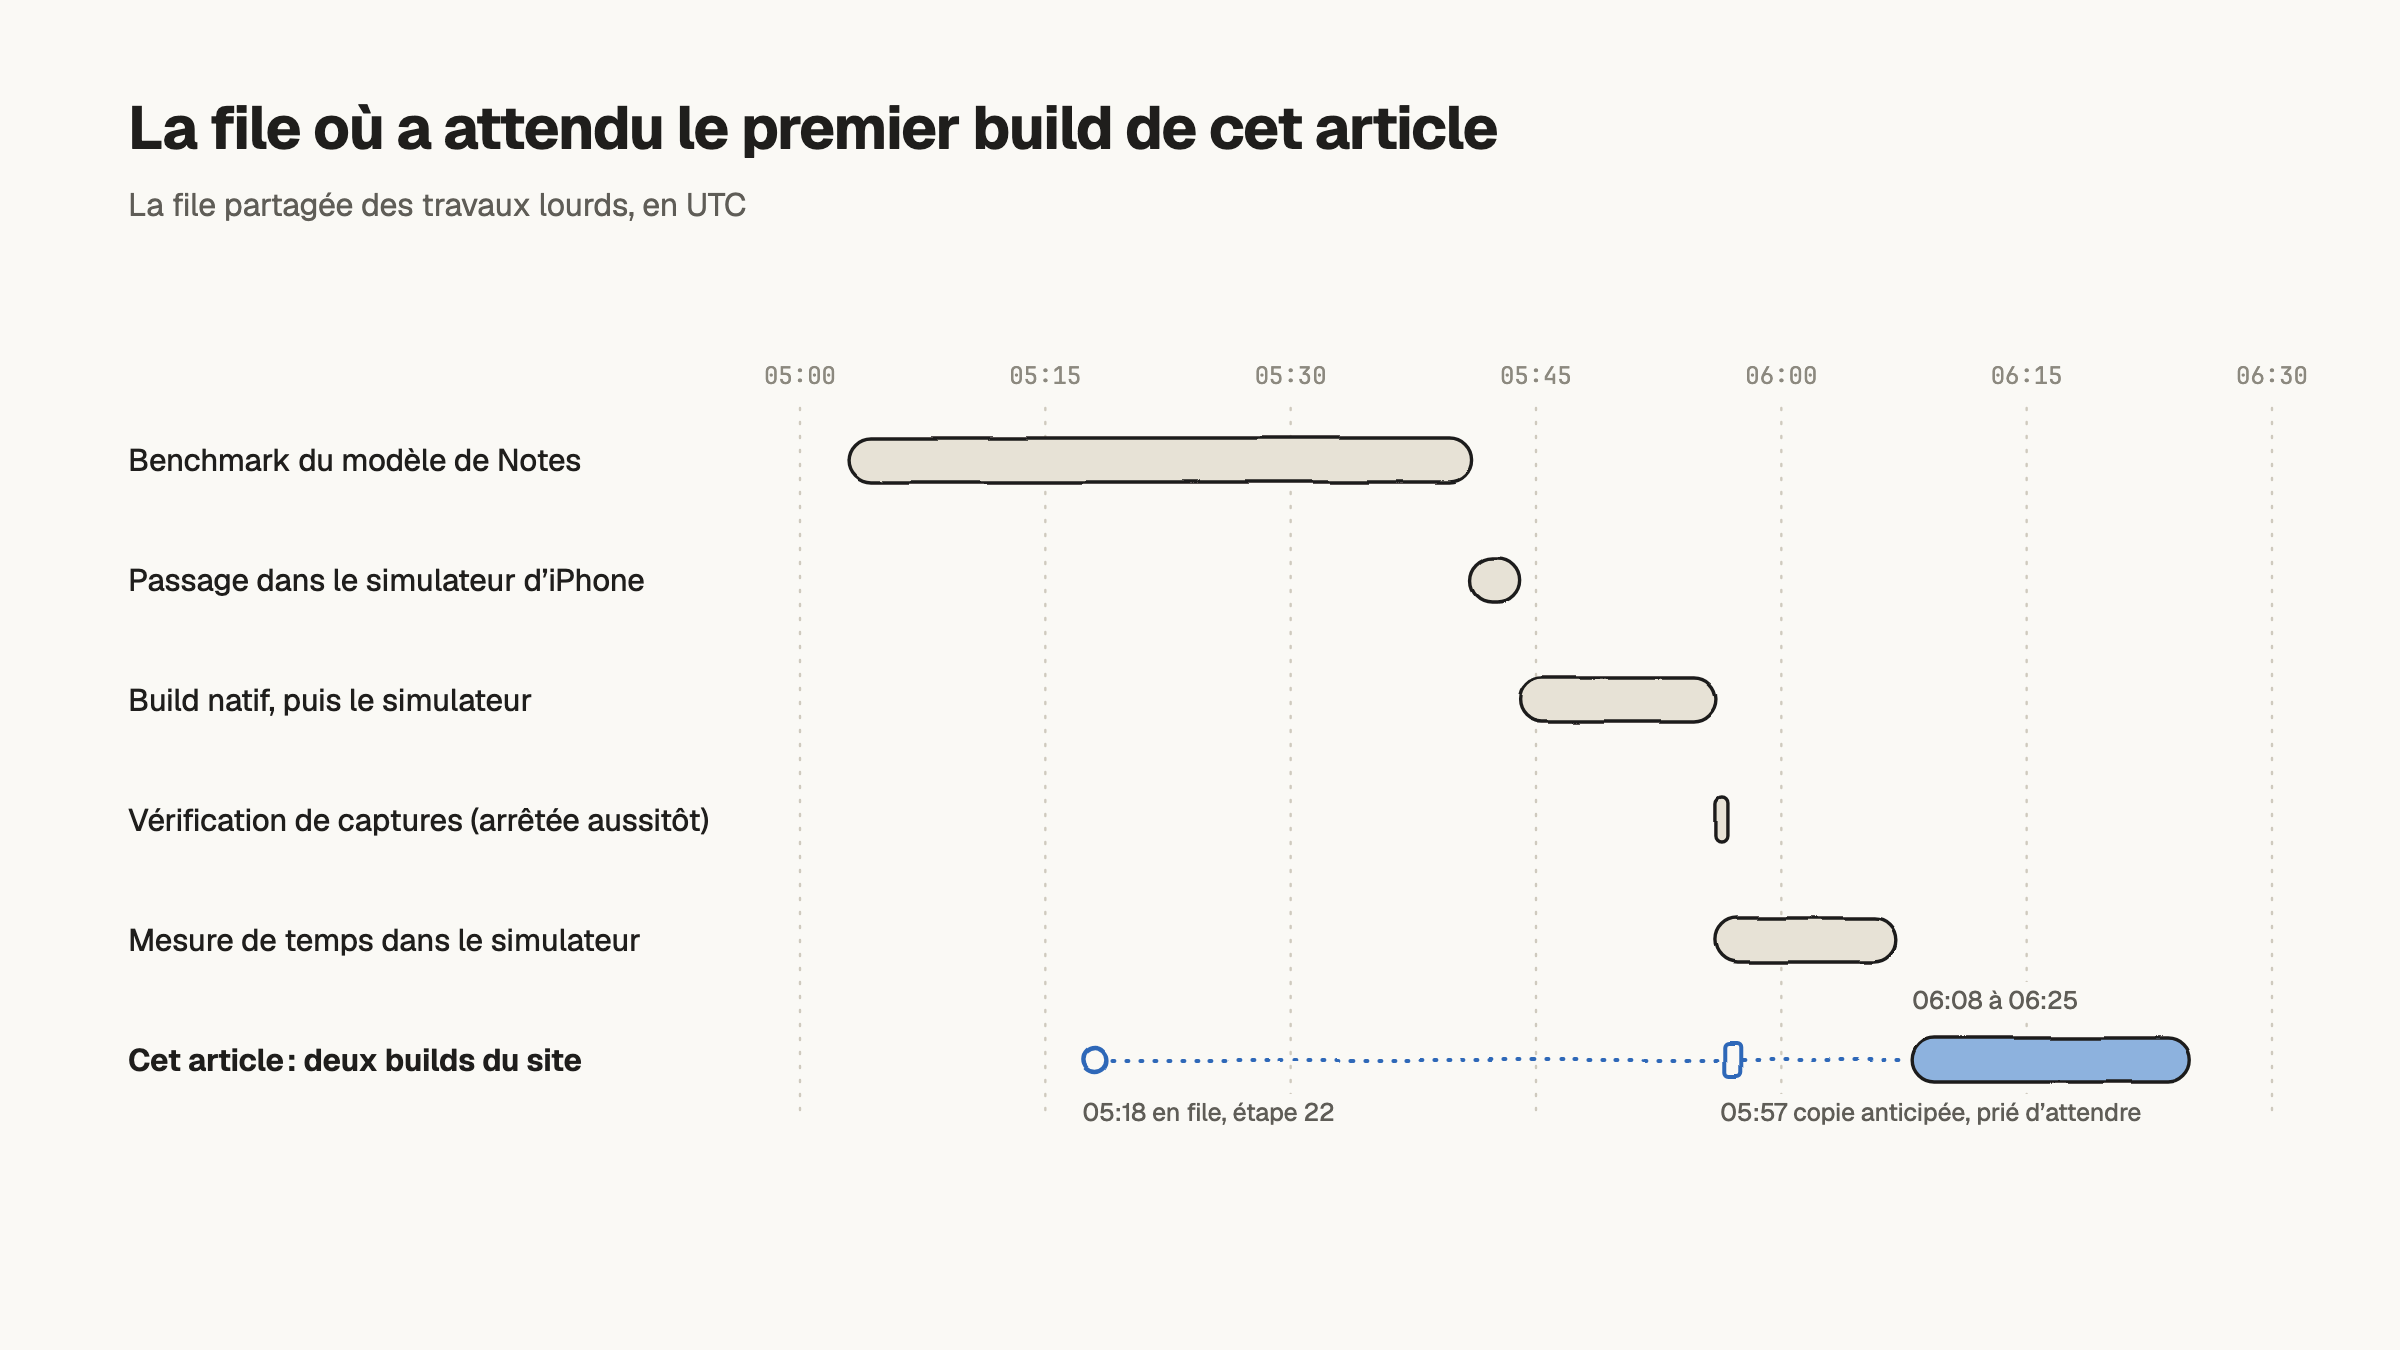
Les règles de la file se trouvent dans un seul script shell, heavy.sh, et elles ont changé plus d’une fois. Le 28 octobre, elles étaient trop strictes : dix tâches ont attendu jusqu’à 16 minutes alors que le Mac avait 43 % de sa mémoire libre, et nous avons retiré la file. Le 2 novembre, elles étaient trop laxistes. Environ 19 sessions étaient ouvertes, plusieurs avec deux à cinq sous-agents chacune, et la barrière ne comptait ni les sous-agents ni un serveur de développement qui tournait depuis six heures. Le Mac a manqué de mémoire, et quand le harness a fait le ménage dans les shells en arrière-plan, les surveillants du coordinateur sont morts avec eux.
La barrière actuelle mesure la mémoire du Mac à chaque exécution. S’il y a de la place, une tâche démarre tout de suite ; sinon, elle est retenue ; et jamais plus de quatre tâches lourdes ne tournent en même temps. Le test placé devant le travail lourd ressemble à peu près à ceci :
# LOCKS is a directory every session shares; run/<pid> marks a heavy run.
level=$(sysctl -n kern.memorystatus_vm_pressure_level)  # 1 normal, 2 warn, 4 critical
free=$(memory_pressure -Q | awk -F: '/free percentage/ {print int($2)}')
live=0
for f in "$LOCKS"/run/*; do
  [ -e "$f" ] && kill -0 "${f##*/}" 2>/dev/null && live=$((live + 1))
done

hold() {
  [ -e "$LOCKS/STOP" ] || [ "$level" -ge 4 ] ||
  { [ "$level" -ge 2 ] && [ "$live" -ge 2 ]; } ||
  [ "$free" -lt 25 ] || { [ "$free" -lt 30 ] && [ "$live" -ge 1 ]; } ||
  [ "$live" -ge 4 ]
}
# Wait while hold() is true or older tickets fill the free slots (2 at warn, 4 otherwise).
# Then write run/$$, run "$@" as a child, and remove run/$$ when it exits.
Les tâches en attente prennent un ticket dans l’ordre d’arrivée. Une fois, avec une trentaine en attente, celle qui interrogeait la première quand un emplacement se libérait gagnait, et une tâche a attendu 35 minutes derrière des arrivées plus tardives. Il y a aussi des limites pour toute la machine, au plus six sous-agents et un seul simulateur, mais ces deux-là ne sont encore que des règles écrites que la barrière n’impose pas.
Les règles qu’on se contente d’écrire sont enfreintes
Chaque incident de cet article a laissé une règle derrière lui, mise par écrit avec sa date. Trois d’entre elles montrent ce qui arrive à une règle qui n’existe que par écrit.
La première concerne les vraies données. Les sessions d’agents lancées depuis la copie de l’app de bureau Foxl que nous utilisons vraiment héritent de l’environnement de l’app, y compris d’une variable qui pointe vers sa base de données. Le 19 octobre, une suite de tests lancée depuis un tel shell a écrit 305 fausses conversations dans la vraie base de données Foxl. La règle d’effacer cette variable est entrée le jour même, et à partir du 24 octobre heavy.sh l’effaçait lui-même. L’erreur est revenue malgré tout : une vérification lancée directement avec npm, des scripts ponctuels, des tests qui embarquent tout le serveur de bureau, chaque fois par un chemin que le wrapper ne couvrait pas. Désormais, le serveur de bureau refuse d’ouvrir les vraies données quand il tourne sous un exécuteur de tests (foxl/server/paths.ts). Seuls les scripts ponctuels reposent encore sur la règle écrite.
La deuxième concerne un script qui dépense de l’argent réel. check-remote-input.mjs se trouve parmi des dizaines de scripts check- qui lisent le dépôt et échouent sur ce qu’ils trouvent, mais lui démarre de vraies tâches sur le service Foxl Code de production. Le 23 septembre, un passage sur tous les scripts check- en a démarré une. La règle, alors, était de lancer les vérifications une par une, par leur nom. Le 18 octobre, le script s’est glissé dans une liste de vérifications choisies avec grep, et la facture de ses trois tâches a fait passer notre compte de test sous zéro. Désormais, il ne fait rien sans l’option --live, et un test dans pr-validate le maintient ainsi.
La troisième concerne le verrou de push. Les push passaient par un verrou qu’une session prenait en créant un répertoire. Le 2 novembre, une session a essayé de le prendre à la main, dans un lot d’appels d’outils en parallèle. La création du répertoire a échoué, parce qu’une autre session détenait le verrou, mais le reste du lot s’est exécuté quand même : la session a poussé, puis supprimé le verrou de l’autre session. Un script qui prend le verrou et ne libère que le sien est arrivé le matin même, mais une session confinée à son propre worktree ne pouvait pas s’en servir et continuait de prendre le verrou à la main, une étape à la fois. La même erreur s’est reproduite le 4 novembre.
Aucune de ces vérifications n’a mis fin à sa catégorie d’erreurs. Chacune a bloqué le chemin par lequel était arrivée la précédente, et jusqu’ici la suivante en a toujours trouvé un autre.
Ce que prouve une vérification au vert
Toute notre CI tourne sur des runners auto-hébergés, et chaque pull request doit passer une barrière appelée pr-validate. La question est de savoir ce que prouve cette vérification au vert. Le vert veut dire que la pull request a passé les tests toute seule, et rien de plus.
Le premier merge train, celui de la v0.7.27 le 24 septembre, a montré l’écart. Cinquante-quatre pull requests étaient chacune au vert sur leur propre CI et contenaient pourtant quatre blocages. L’une perdait les derniers caractères saisis avec une méthode de saisie ; une autre cassait la réponse depuis l’écran verrouillé de l’iPhone. Le même jour, le Mac s’est complètement figé pendant que 19 agents relecteurs tournaient en même temps. Depuis, les relecteurs tournent au plus à sept à la fois, mais cela aussi n’est qu’une règle écrite.
Désormais, un train est donc construit à partir de l’arbre fusionné de toutes les pull requests prêtes, et la décision de fusion se prend sur cet arbre. Chaque agent relecteur prend un groupe de pull requests liées, avec des consignes qui comprennent ceci, dans l’anglais d’origine :
Your job is to REFUTE each PR in your group, not to confirm it. Assume every PR body overclaims until you have reproduced its claim. A green pr-validate on the PR proves little: it ran without the other PRs, and it cannot see UX or cost.
Autrement dit : réfuter chaque pull request, pas la confirmer ; tenir le texte de chaque pull request pour exagéré tant qu’on n’a pas reproduit ce qu’il affirme ; et savoir qu’un pr-validate au vert sur la pull request prouve peu, parce qu’il a tourné sans les autres pull requests et ne voit ni l’expérience d’usage ni le coût. Un relecteur répond MERGE, MERGE_WITH_FIXES avec le correctif écrit, HOLD ou CLOSE. Les correctifs arrivent comme des commits distincts au-dessus de la pull request, et une pull request qu’on ne peut pas corriger est écartée en reconstruisant le train sans elle.
« Don’t Build Multi-Agents », de Cognition, plaide contre le fait de répartir une tâche entre des agents qui ne voient pas le travail des autres, et pour la confier à un seul agent qui détient tout le contexte. Nous donnons bien une tâche entière à chaque session. Un problème demeure : les agents ont trop confiance en leur propre travail. C’est pourquoi on demande aux relecteurs de réfuter.
Un test que l’agent écrit en même temps que sa fonctionnalité est une preuve particulièrement faible. Le test et le code viennent de la même compréhension du problème, donc quand l’agent lit mal l’API d’un fournisseur ou ce qui était demandé, les deux portent la même erreur. Voici ce que chaque type de vérification peut voir :
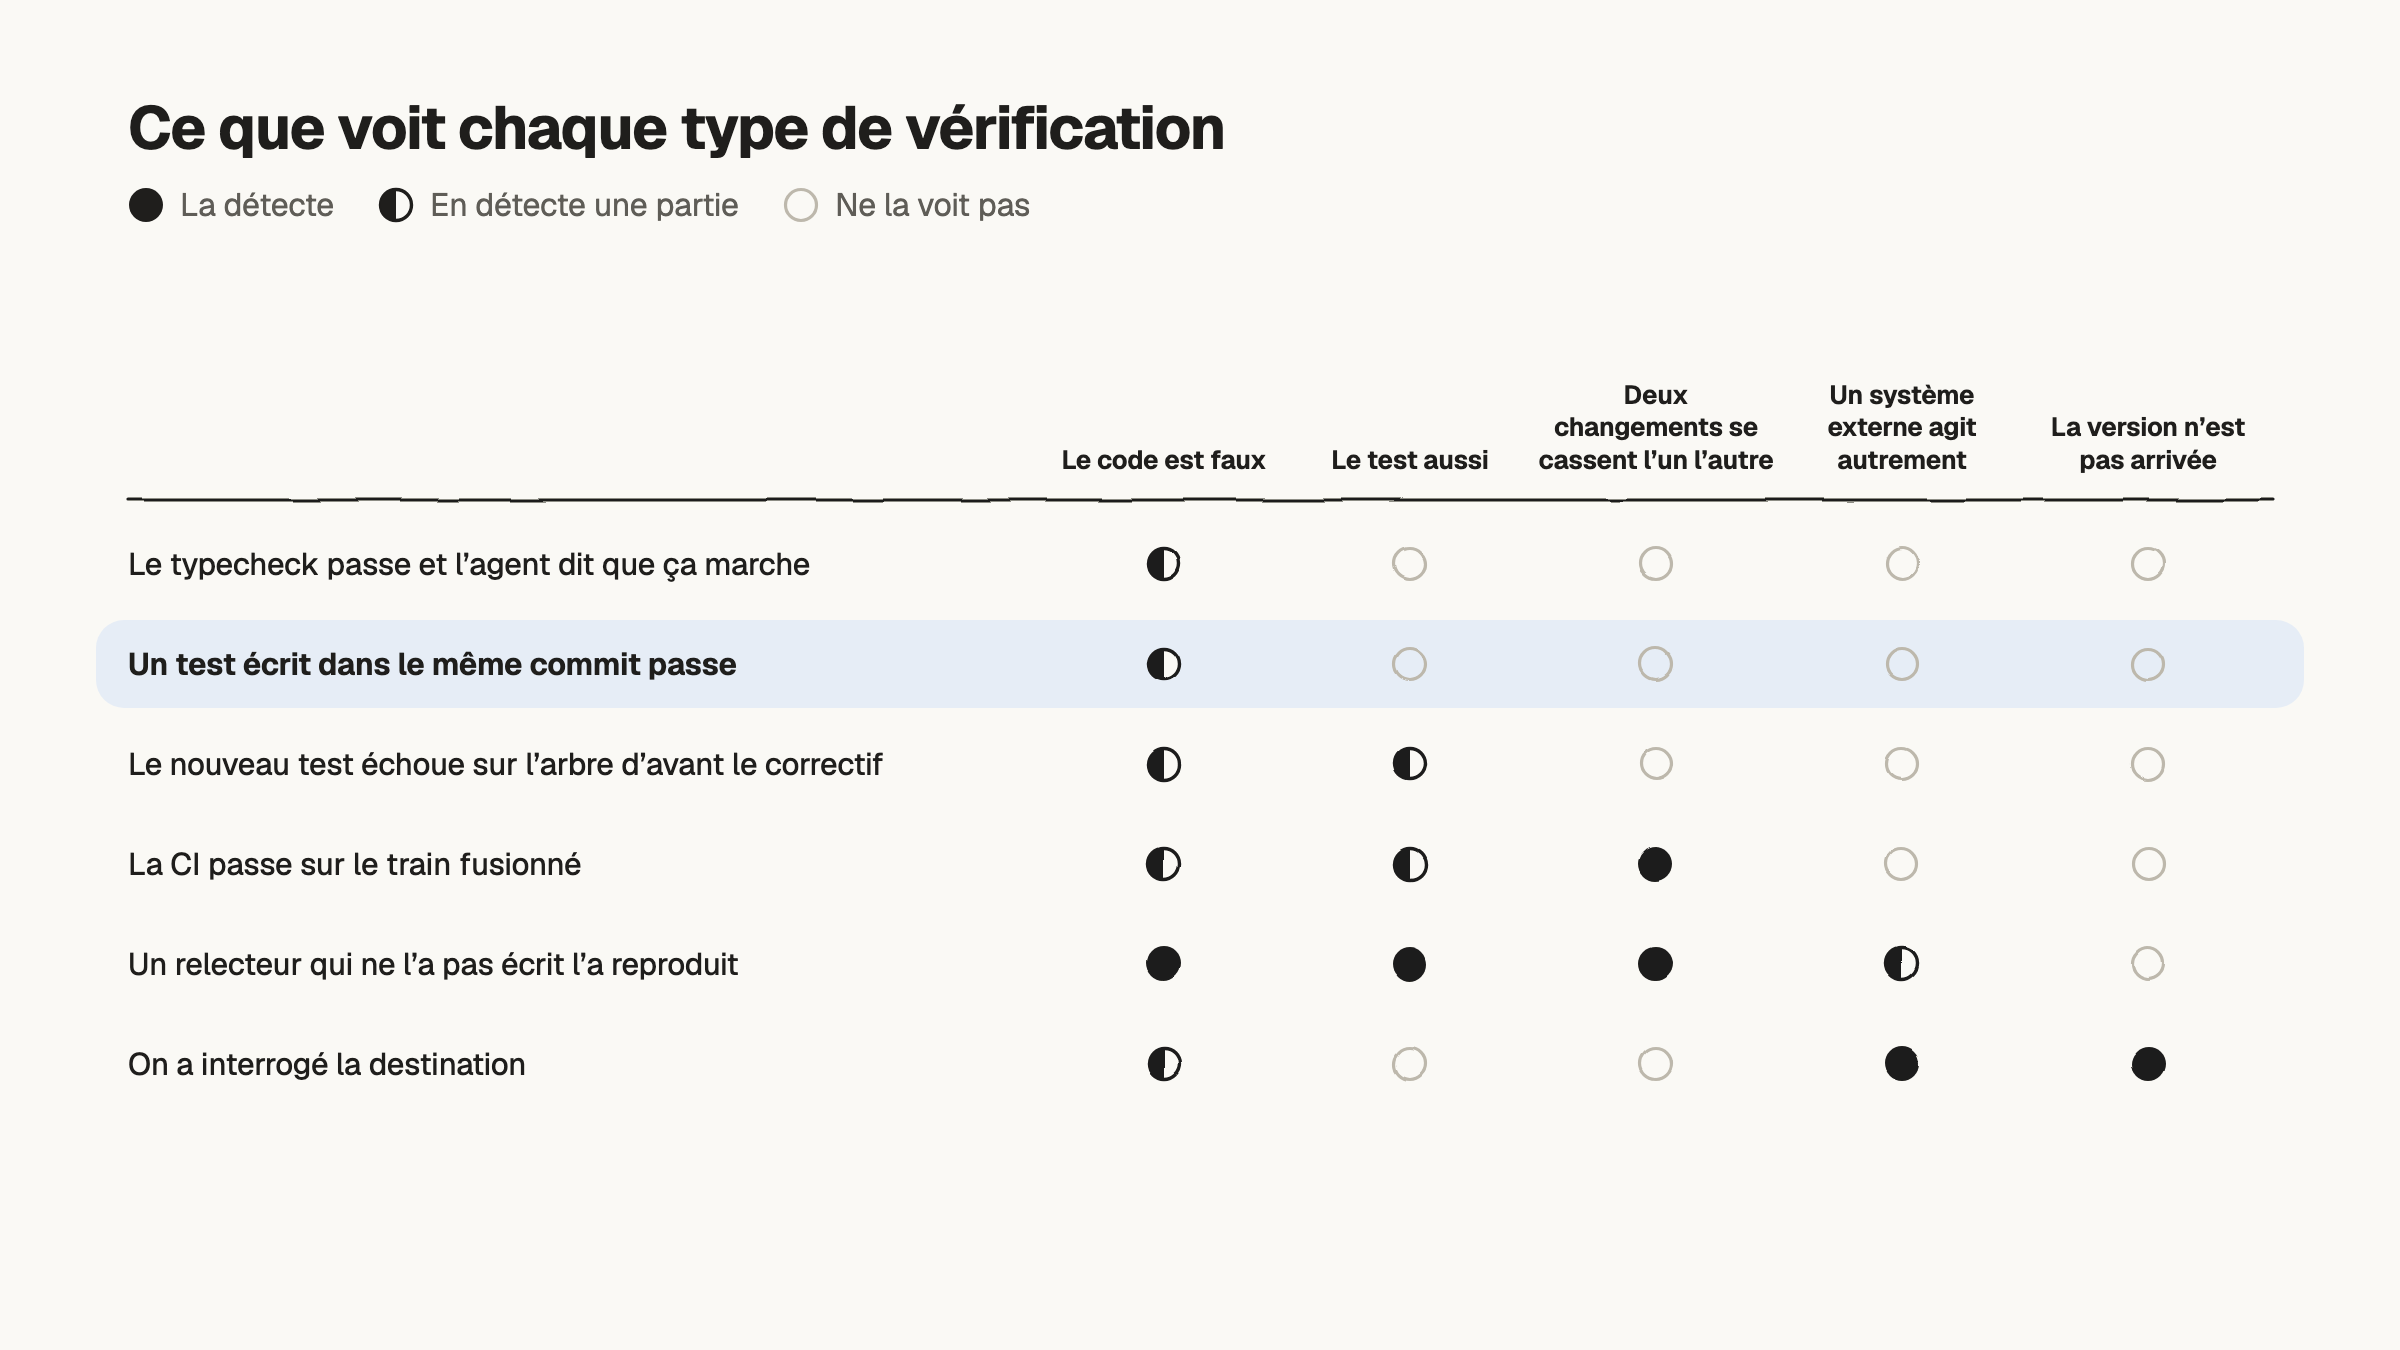
Un nouveau test ne compte donc que s’il échoue sur l’arbre d’avant le correctif, et la barrière finale est la CI sur le train fusionné. Pour tout ce qui se passe hors du dépôt, la preuve se trouve dans ce système extérieur. Après une montée de version d’une CLI, les terminaux distants Codex et OpenCode de Foxl Code n’ont accepté aucune frappe pendant dix jours, alors que toutes les barrières étaient au vert. Un workflow de version a un jour annoncé un succès alors que TestFlight ne contenait aucune build. Et le 3 novembre, nous avons découvert que 34 harnesses de captures sur 43 servaient des pages sans les vraies polices : les relecteurs jugeaient des formes de lettres que l’app livrée ne dessine jamais.
Demander à la destination
Une version stable, c’est un seul lancement de workflow. Ce seul lancement construit et livre les apps Windows, Linux, macOS, iOS et Android, les apps web et le serveur de relais. Nous ne croyons pas le workflow sur parole quand il annonce un succès : les vérifications qui suivent une version interrogent directement chaque destination.
Un script attend que les cinq plateformes aient leurs fichiers avant de publier la version. Le cask Homebrew est comparé à la version publiée, parce qu’il a un jour servi une build vieille d’une semaine pendant quatre versions, alors que le workflow qui le met à jour semblait aller bien. Les apps web déployées sont comparées au numéro de la version, parce qu’un Worker répond 200 avec un bundle périmé. TestFlight est interrogé par l’API d’Apple.
Si vous construisez quelque chose de semblable
Voici ce qui a marché pour nous :
- Donnez à chaque agent son propre git worktree. Sur APFS,
cp -Rccopienode_modulessous forme de clone copy-on-write qui ne prend presque pas de disque. Ne reliez jamais un mêmenode_modulesà plusieurs worktrees par un lien symbolique. - Faites d’un agent le coordinateur, et gardez l’état partagé dans de simples fichiers que tous les agents peuvent lire : qui détient quels fichiers, qui exécute quoi, ce qui est gelé.
- Conditionnez le travail gourmand en mémoire à la mémoire mesurée, et comptez les sous-agents et les serveurs de développement en plus des builds.
- Lisez les refs par SHA plutôt que par leur nom, parce que d’autres sessions déplacent sans cesse
origin/*.
Avant de construire un merge train, vous pouvez cartographier ses conflits sans checkout, en repliant chaque pull request sur main à tour de rôle. En bash :
# Each head as a local ref first: git fetch origin '+refs/pull/*/head:refs/pr/*'
prs=(101 102 103)
acc=$(git rev-parse origin/main)
for pr in "${prs[@]}"; do
  out=$(git merge-tree --write-tree --name-only "$acc" "refs/pr/$pr"); code=$?
  if [ "$code" -eq 0 ]; then
    acc=$(git commit-tree "${out%%$'\n'*}" -p "$acc" -p "refs/pr/$pr" -m "train: #$pr")
  elif [ "$code" -eq 1 ]; then
    echo "#$pr conflicts in:"; echo "$out" | sed -n '2,/^$/p'
  else
    echo "#$pr: merge-tree failed ($code)"; exit "$code"
  fi
done
Un fichier auquel chaque pull request ajoute des lignes à la fin, comme un changelog, apparaîtra dans presque tous les conflits, sauf si vous lui donnez une fusion union pour cette commande : git -c core.attributesFile=<file>, avec CHANGELOG.md merge=union dans ce fichier.
Ce que font les personnes
Dans cette organisation, nous n’écrivons pas de code, et nous lisons rarement un diff. Une demande, c’est généralement une phrase et une capture. Ce que nous lisons, c’est ce qui revient : les captures de chaque pull request, les verdicts de chaque train, et le rapport à la fin de chaque version, avec ce qui est sorti, ce que chaque vérification a répondu et les captures de chaque pull request qu’elle contient.
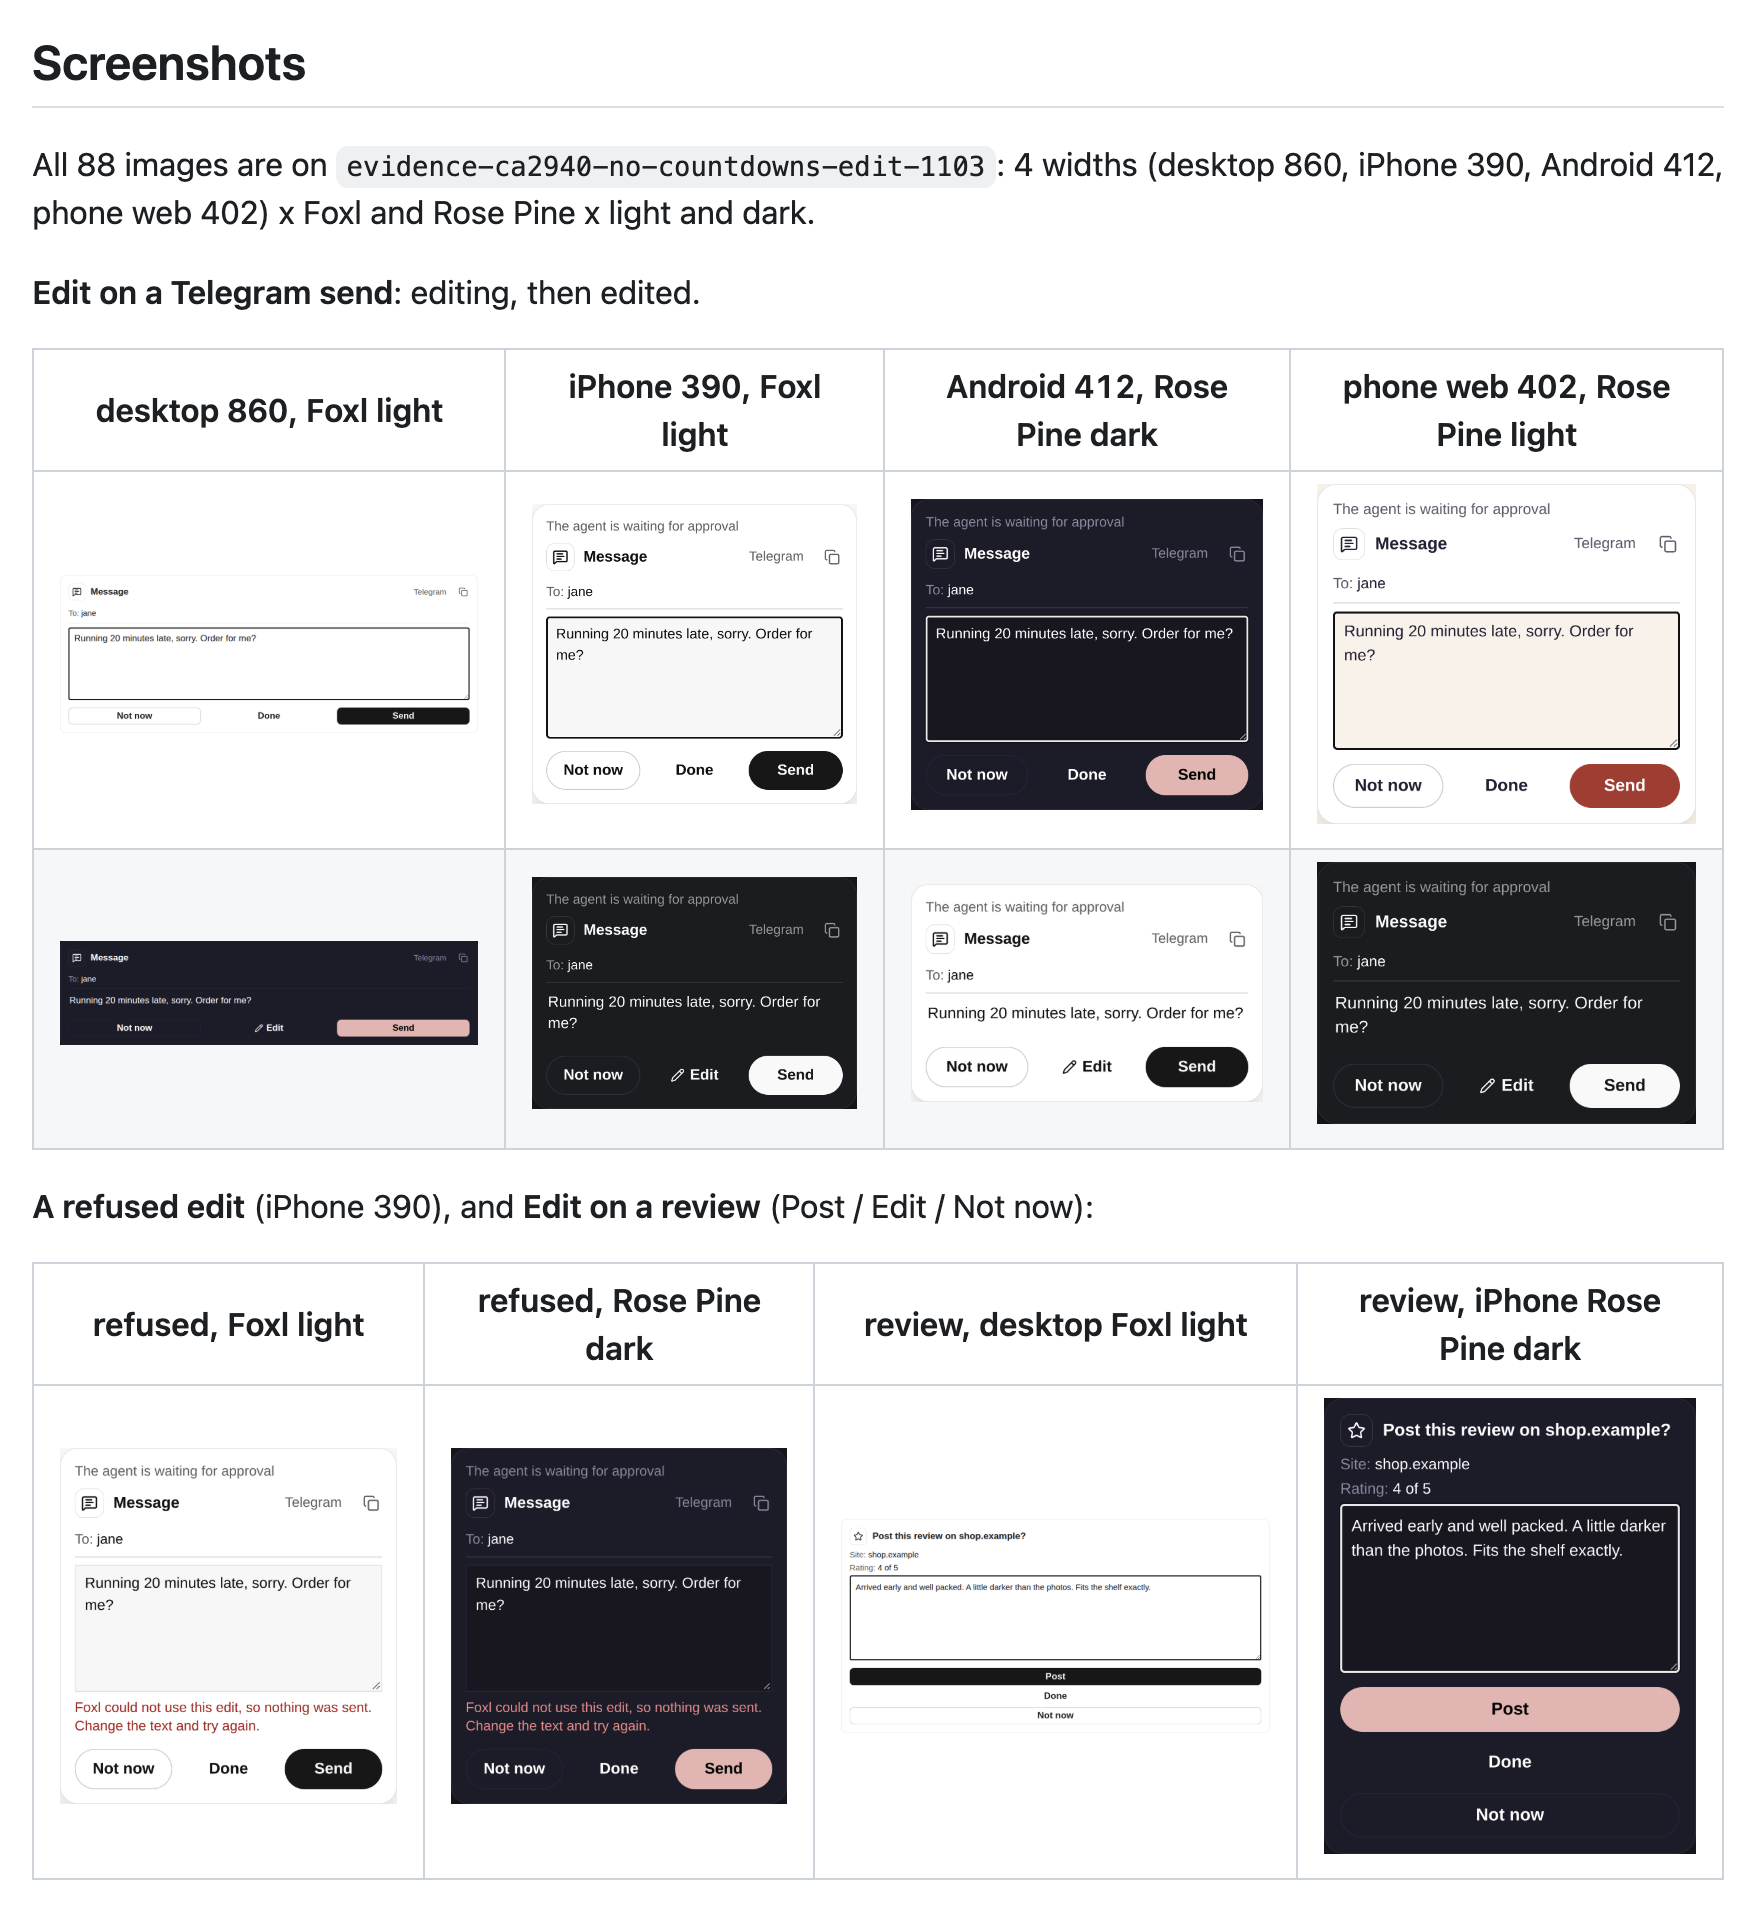
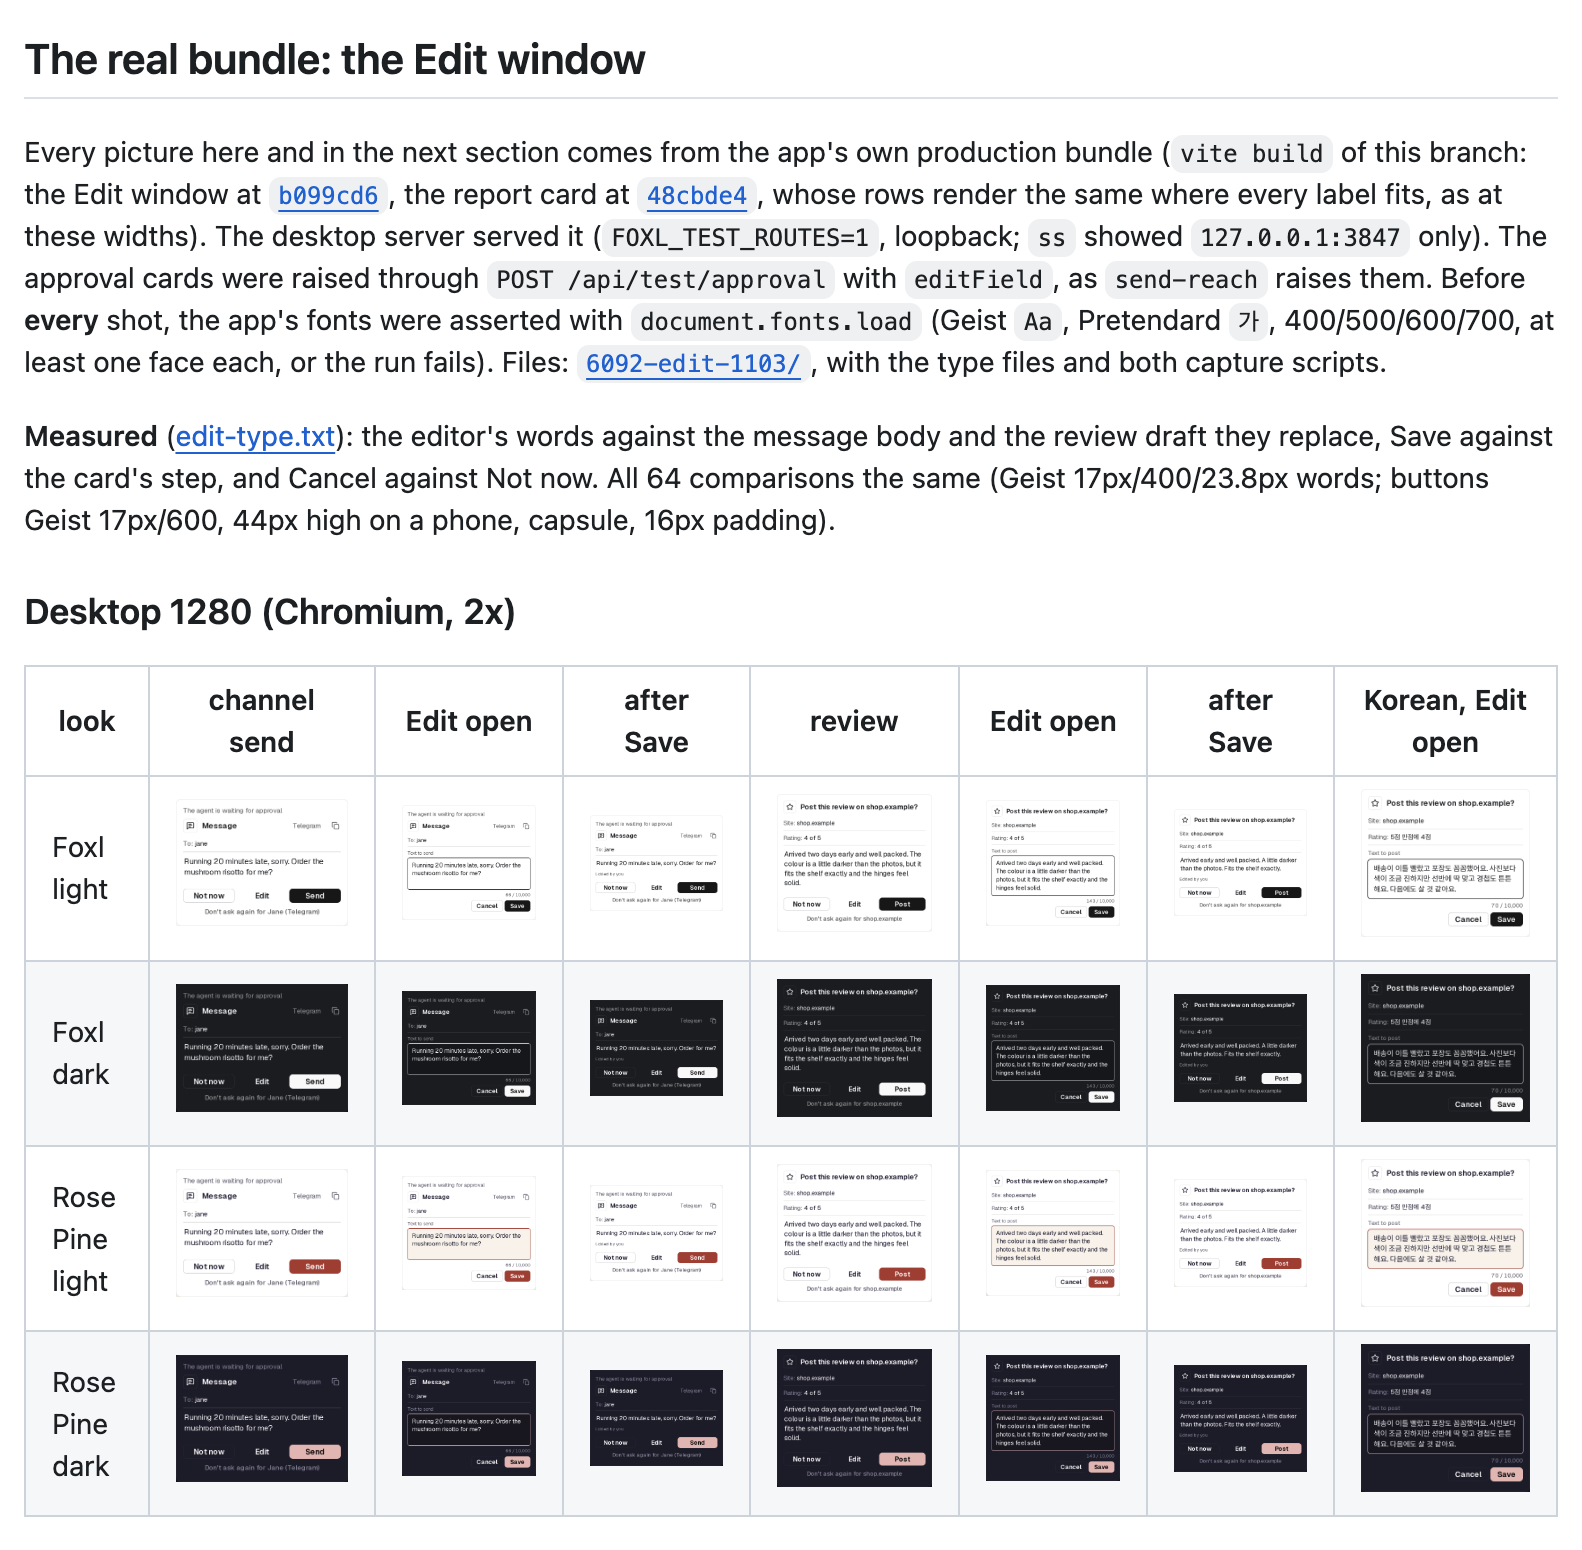
Une matinée en donne un exemple. Le 3 novembre à 04:59 UTC, une pull request est arrivée avec 20 captures d’une nouvelle fenêtre de modification sur la carte qui publie un avis. Le texte était dans une autre police, la zone de saisie était celle du navigateur, et trois boutons descendaient la carte l’un sous l’autre. À 05:04, nous avons envoyé deux lignes au coordinateur : que l’auteur refasse la fenêtre dans le système de design, repasse la pull request en brouillon et la remette en revue. Douze secondes plus tard, c’était un brouillon. À 09:30, elle est revenue sur l’éditeur de brouillons de l’app, avec 296 captures, chacune prise après le chargement des polices de l’app, et elle a été fusionnée à 11:50. L’autre police n’était pas le fait de la pull request : son harness de captures ne servait jamais les polices de l’app, et c’est en cherchant pourquoi, ce jour-là, que nous avons trouvé les 34 harnesses cités plus haut.
Quand quelque chose tourne mal, nous écrivons la règle qui l’aurait attrapé dans le fichier CLAUDE.md de ce domaine, avec la date et l’incident, puis nous cherchons l’endroit où un script pourrait l’imposer. Les agents prennent les décisions réversibles à partir du code et notent ce qu’ils ont décidé. Tout ce qui est irréversible, et tout ce qui touche à l’argent, attend une personne. Une pull request qui rend Foxl moins pratique que les produits auxquels on le compare est retenue, même quand son code est juste.
Ce que nous n’avons pas résolu
Les relecteurs sont des agents, mais les critères qu’ils appliquent ont été écrits par des personnes, et des personnes lisent encore leurs verdicts. Cette lecture est désormais l’étape la plus lente entre une pull request et une version. Nous écrivons donc un critère pour chaque type d’affirmation, qu’un autre agent puisse vérifier sans qu’une personne intervienne : pour un correctif de logique, un test qui échoue avant le correctif et passe sur le train fusionné ; pour l’API d’un fournisseur, une capture du vrai service ; pour tout ce qu’une personne voit, des captures de la vraie build avec les vraies polices ; pour un coût, des nombres de requêtes mesurés ; pour une version, la réponse de chaque destination. Tout ce qui est irréversible, et tout ce qui touche à l’argent, reste aux mains des personnes.
Nous ne savons pas encore comment savoir quand un critère est assez bon. Le plan est de noter les relecteurs comme on note les tests : compter les blocages que chacun trouve et que la CI a manqués, et la fréquence à laquelle une personne renverse son verdict. Quand les personnes cesseront de renverser un relecteur sur un type d’affirmation, ce critère n’aura plus besoin d’une personne. Nous n’avons encore aucun des deux chiffres.
Références et lectures complémentaires
- Journal des modifications de Claude CodeRéférence
- CodexRéférence
- OrcaRéférence
- herdrRéférence
- Kiro CrewRéférence
- Index des RFC de Kiro CrewRéférence
- Foxl CodeRéférence
- Cognition, « Don’t Build Multi-Agents »Référence