AI 소프트웨어 팩토리를 만들며 배운 것
Foxl 팀은 코딩 에이전트 15~20개가 동시에 일하는 AI 소프트웨어 팩토리로 한 달에 수십 번 릴리스합니다. 코드를 쓰는 일보다 그 코드가 맞는지 확인하는 일이 훨씬 어려웠고, 그 확인 장치를 만들며 배운 것을 정리했습니다.
이 페이지에서
Foxl 팀은 한 달에 릴리스를 수십 번 합니다. 지난 10월에는 정식 버전 22번, 베타 44번으로 모두 66번이었습니다. 릴리스마다 Windows, macOS, Linux 데스크톱 앱이 나가고, 정식 버전에는 iOS와 Android 앱, 웹 앱까지 함께 나갑니다. 그 전부가 제대로 동작하는지 매번 확인해야 합니다.
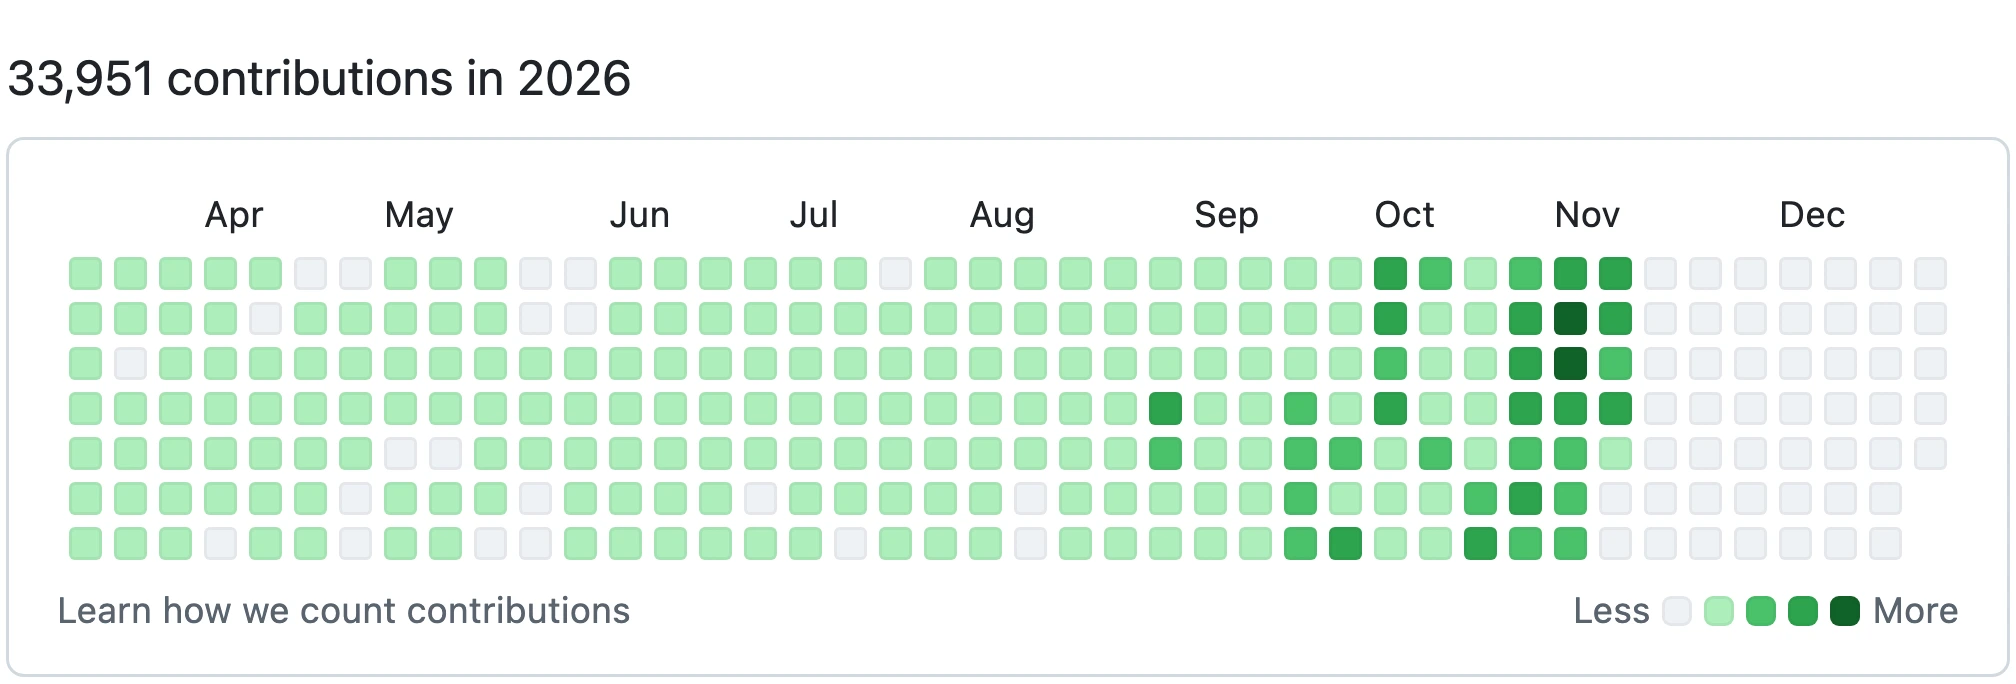
같은 달 저희 저장소에는 풀 리퀘스트가 2,140개 열렸고 2,040개가 머지됐습니다. 하루에 70개 가까이 열린 셈입니다. 이 코드는 대부분 사람이 아니라 코딩 에이전트가 썼습니다. Mac 한 대에서 Claude Code 세션 15~20개가 동시에, 저마다 자기 브랜치에서 일합니다. 에이전트 세션들이 커밋하는 GitHub 계정의 기여 그래프를 보면 변화가 한눈에 들어옵니다. 그 전 두 해에는 한 해 몇백 개이던 기여 수가 올해는 3만을 넘었습니다.
이렇게 에이전트가 계획을 세우고, 코드를 쓰고, 테스트하고, 리뷰까지 맡는 개발 체계를 요즘은 AI 소프트웨어 팩토리라고 부릅니다. 사람은 무엇을 만들지 정하고, 무엇을 내보낼지 마지막으로 판단합니다. 저희 팩토리도 이렇게 돌아갑니다. 그런데 올해 3월부터 에이전트에게 코드를 맡겨 보니, 어려운 건 코드를 쓰는 쪽이 아니었습니다. 에이전트가 쓴 코드가 정말 맞는지, 다섯 플랫폼 어디에서도 깨지지 않는지 아는 쪽이었습니다.
이 글은 그 확인 장치를 만들면서 저희가 배운 것을 정리한 글입니다. 결론부터 말씀드리면, 에이전트에게 글로만 써 둔 규칙은 하나도 빠짐없이 깨졌습니다. 대부분 며칠을 넘기지 못했습니다. 오래 버틴 건 실수가 들어온 바로 그 길목에 세워 둔 검사였고, 다음 실수는 거의 매번 아직 검사가 없는 길로 들어왔습니다.
세션 하나에서 스무 개로
처음 넉 달은 세션 하나를 하루 종일 띄워 두고, diff가 나올 때마다 사람이 전부 읽었습니다. 변경은 거의 다 main에 바로 들어갔고, 6월 한 달 동안 저장소에 남은 풀 리퀘스트는 단 하나입니다. 이때의 병목은 사람의 주의력이었습니다. 한 번에 제대로 따라갈 수 있는 세션은 하나가 고작이었습니다.
7월에는 저희 클라우드 코딩 에이전트인 Foxl Code를 Foxl 저장소에 직접 연결했습니다. 작업마다 클라우드 VM이 하나씩 붙었고, 7월 22일에는 이 구성으로 하루에 프로덕션 릴리스를 다섯 번 냈습니다. 다만 그 VM에는 macOS가 없습니다. Xcode나 iPhone 시뮬레이터가 필요한 일은 여전히 Mac으로 돌아와야 했습니다.
8월에는 일하는 방식을 바꿨습니다. 세션마다 git worktree를 하나씩 주고, 변경마다 풀 리퀘스트를 하나씩 열게 했습니다. 세션끼리 서로의 작업을 덮어쓰지 않으니 여러 세션을 동시에 돌릴 수 있게 됐고, 풀 리퀘스트는 8월 598개에서 9월 946개, 10월 2,140개로 늘었습니다.
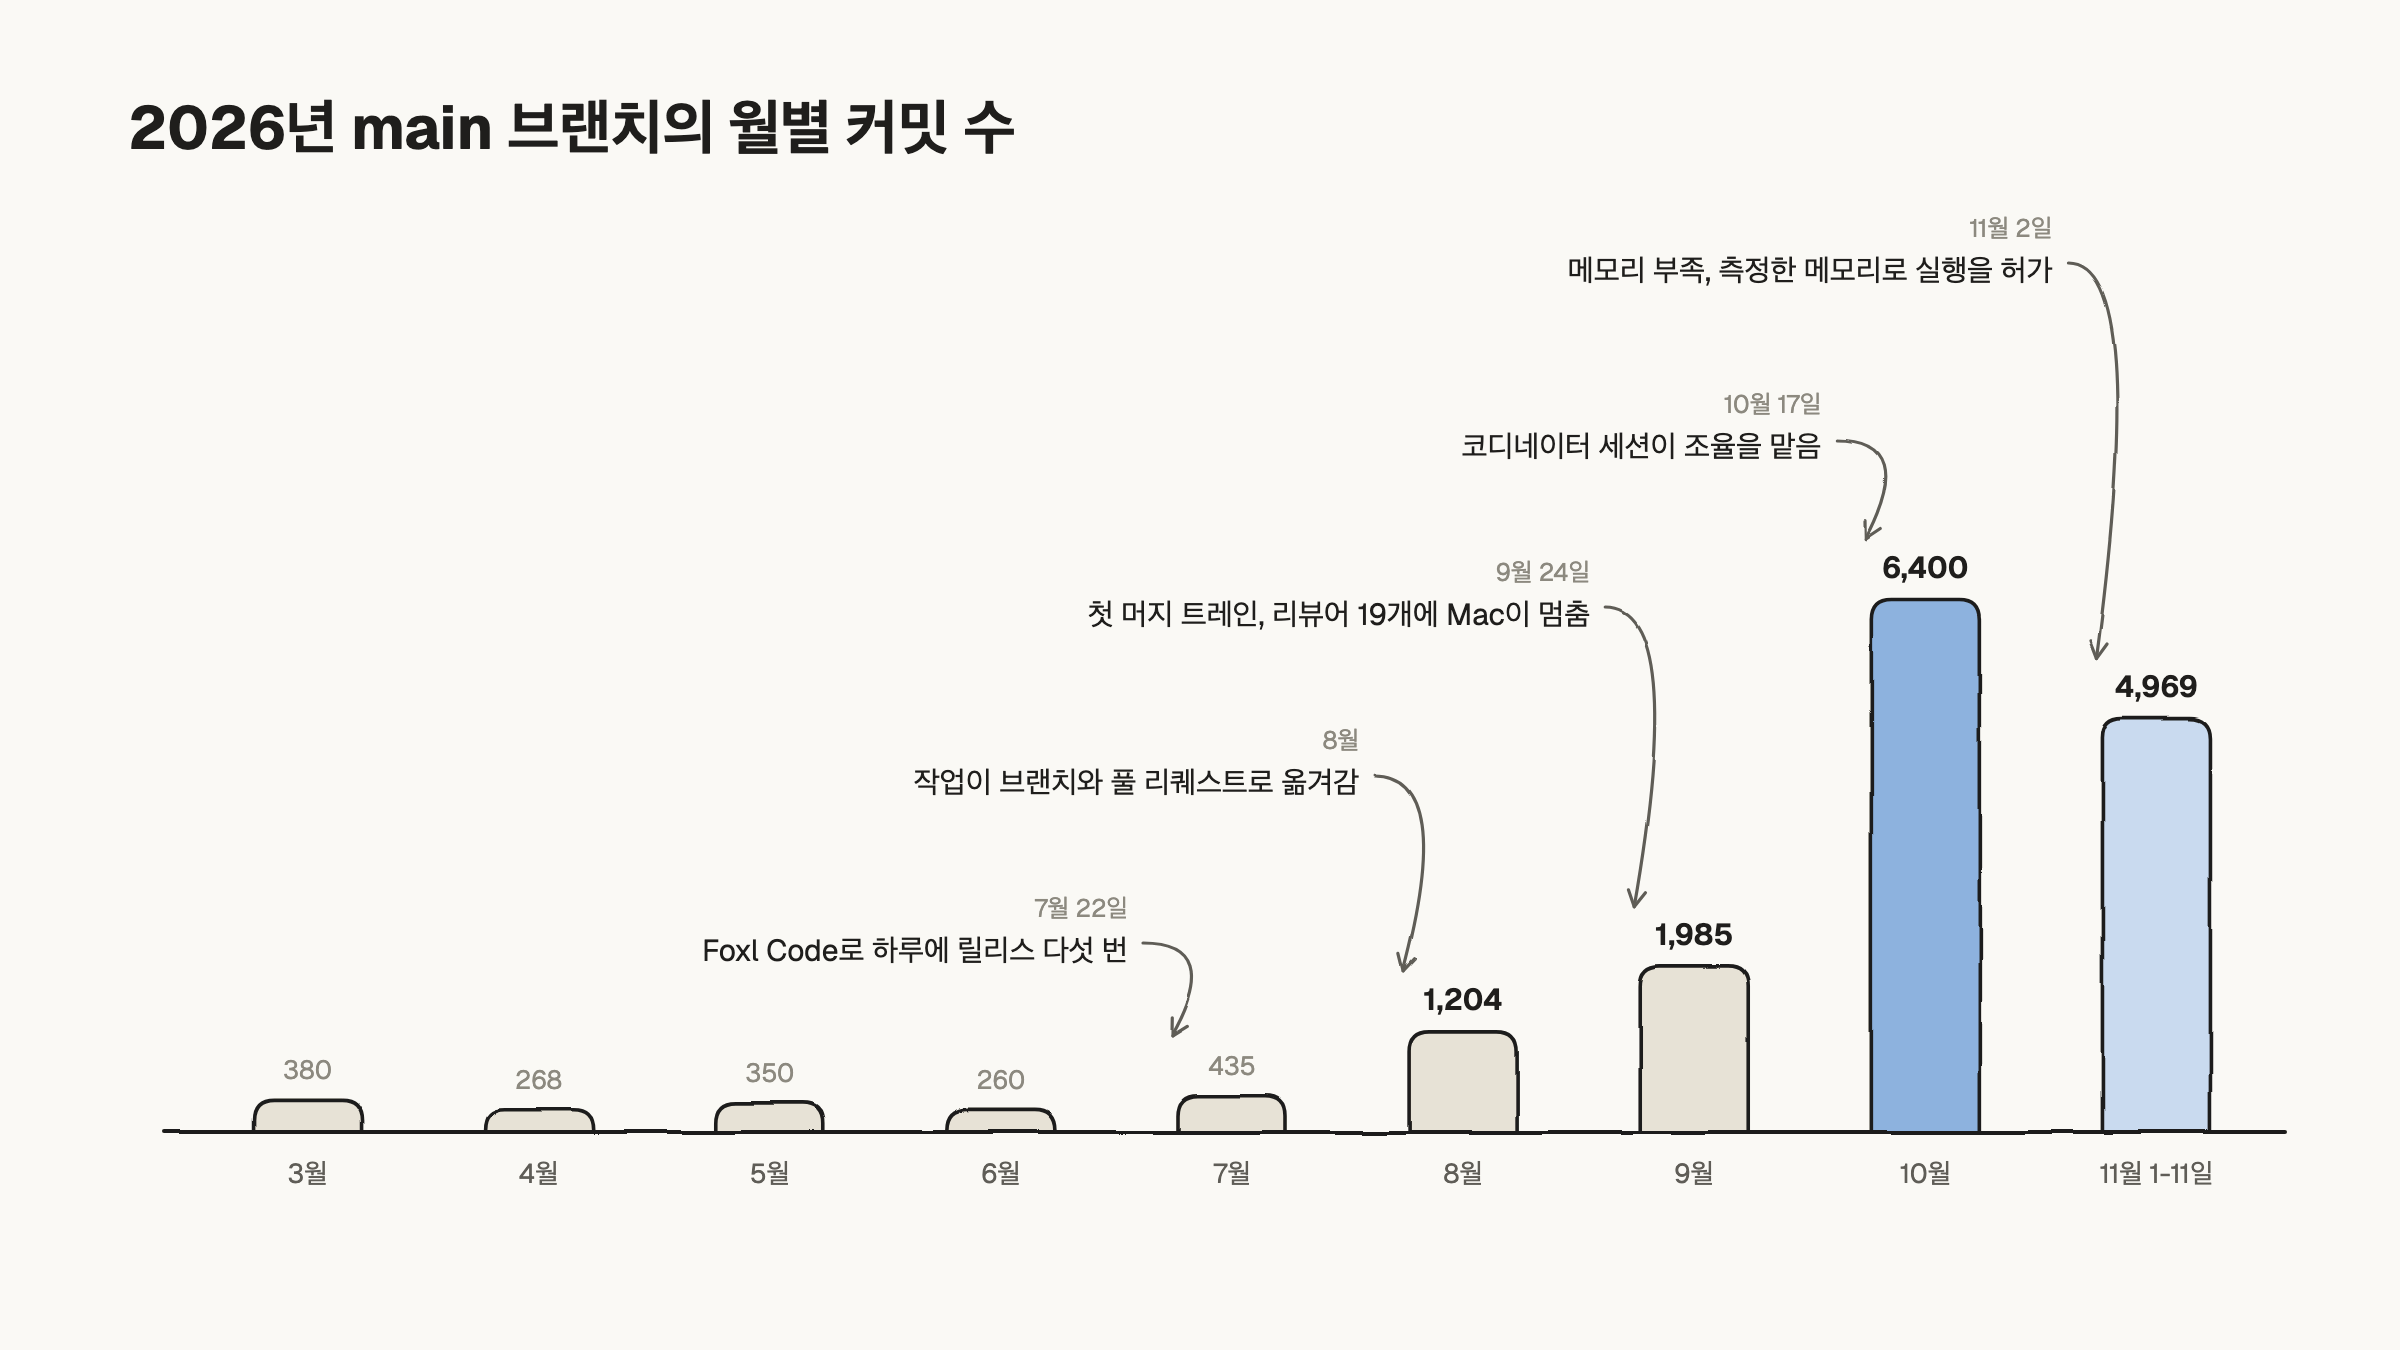
숫자가 늘자 새로운 문제가 보이기 시작했습니다. 세션들이 같은 파일을 동시에 고쳤고, Mac 메모리가 모자랐습니다. 무엇보다 9월 24일 첫 머지 트레인에서, CI가 초록색이라고 해서 풀 리퀘스트가 맞는 건 아니라는 사실이 드러났습니다. 이 이야기는 뒤에서 자세히 하겠습니다.
확인할 수 있는 곳이 일하는 곳을 정했습니다
다섯 플랫폼을 확인하려면 먼저 그걸 확인할 수 있는 기기가 있어야 합니다. 저희가 쓰는 기기는 세 종류이고, 기기마다 할 수 있는 확인이 다릅니다.
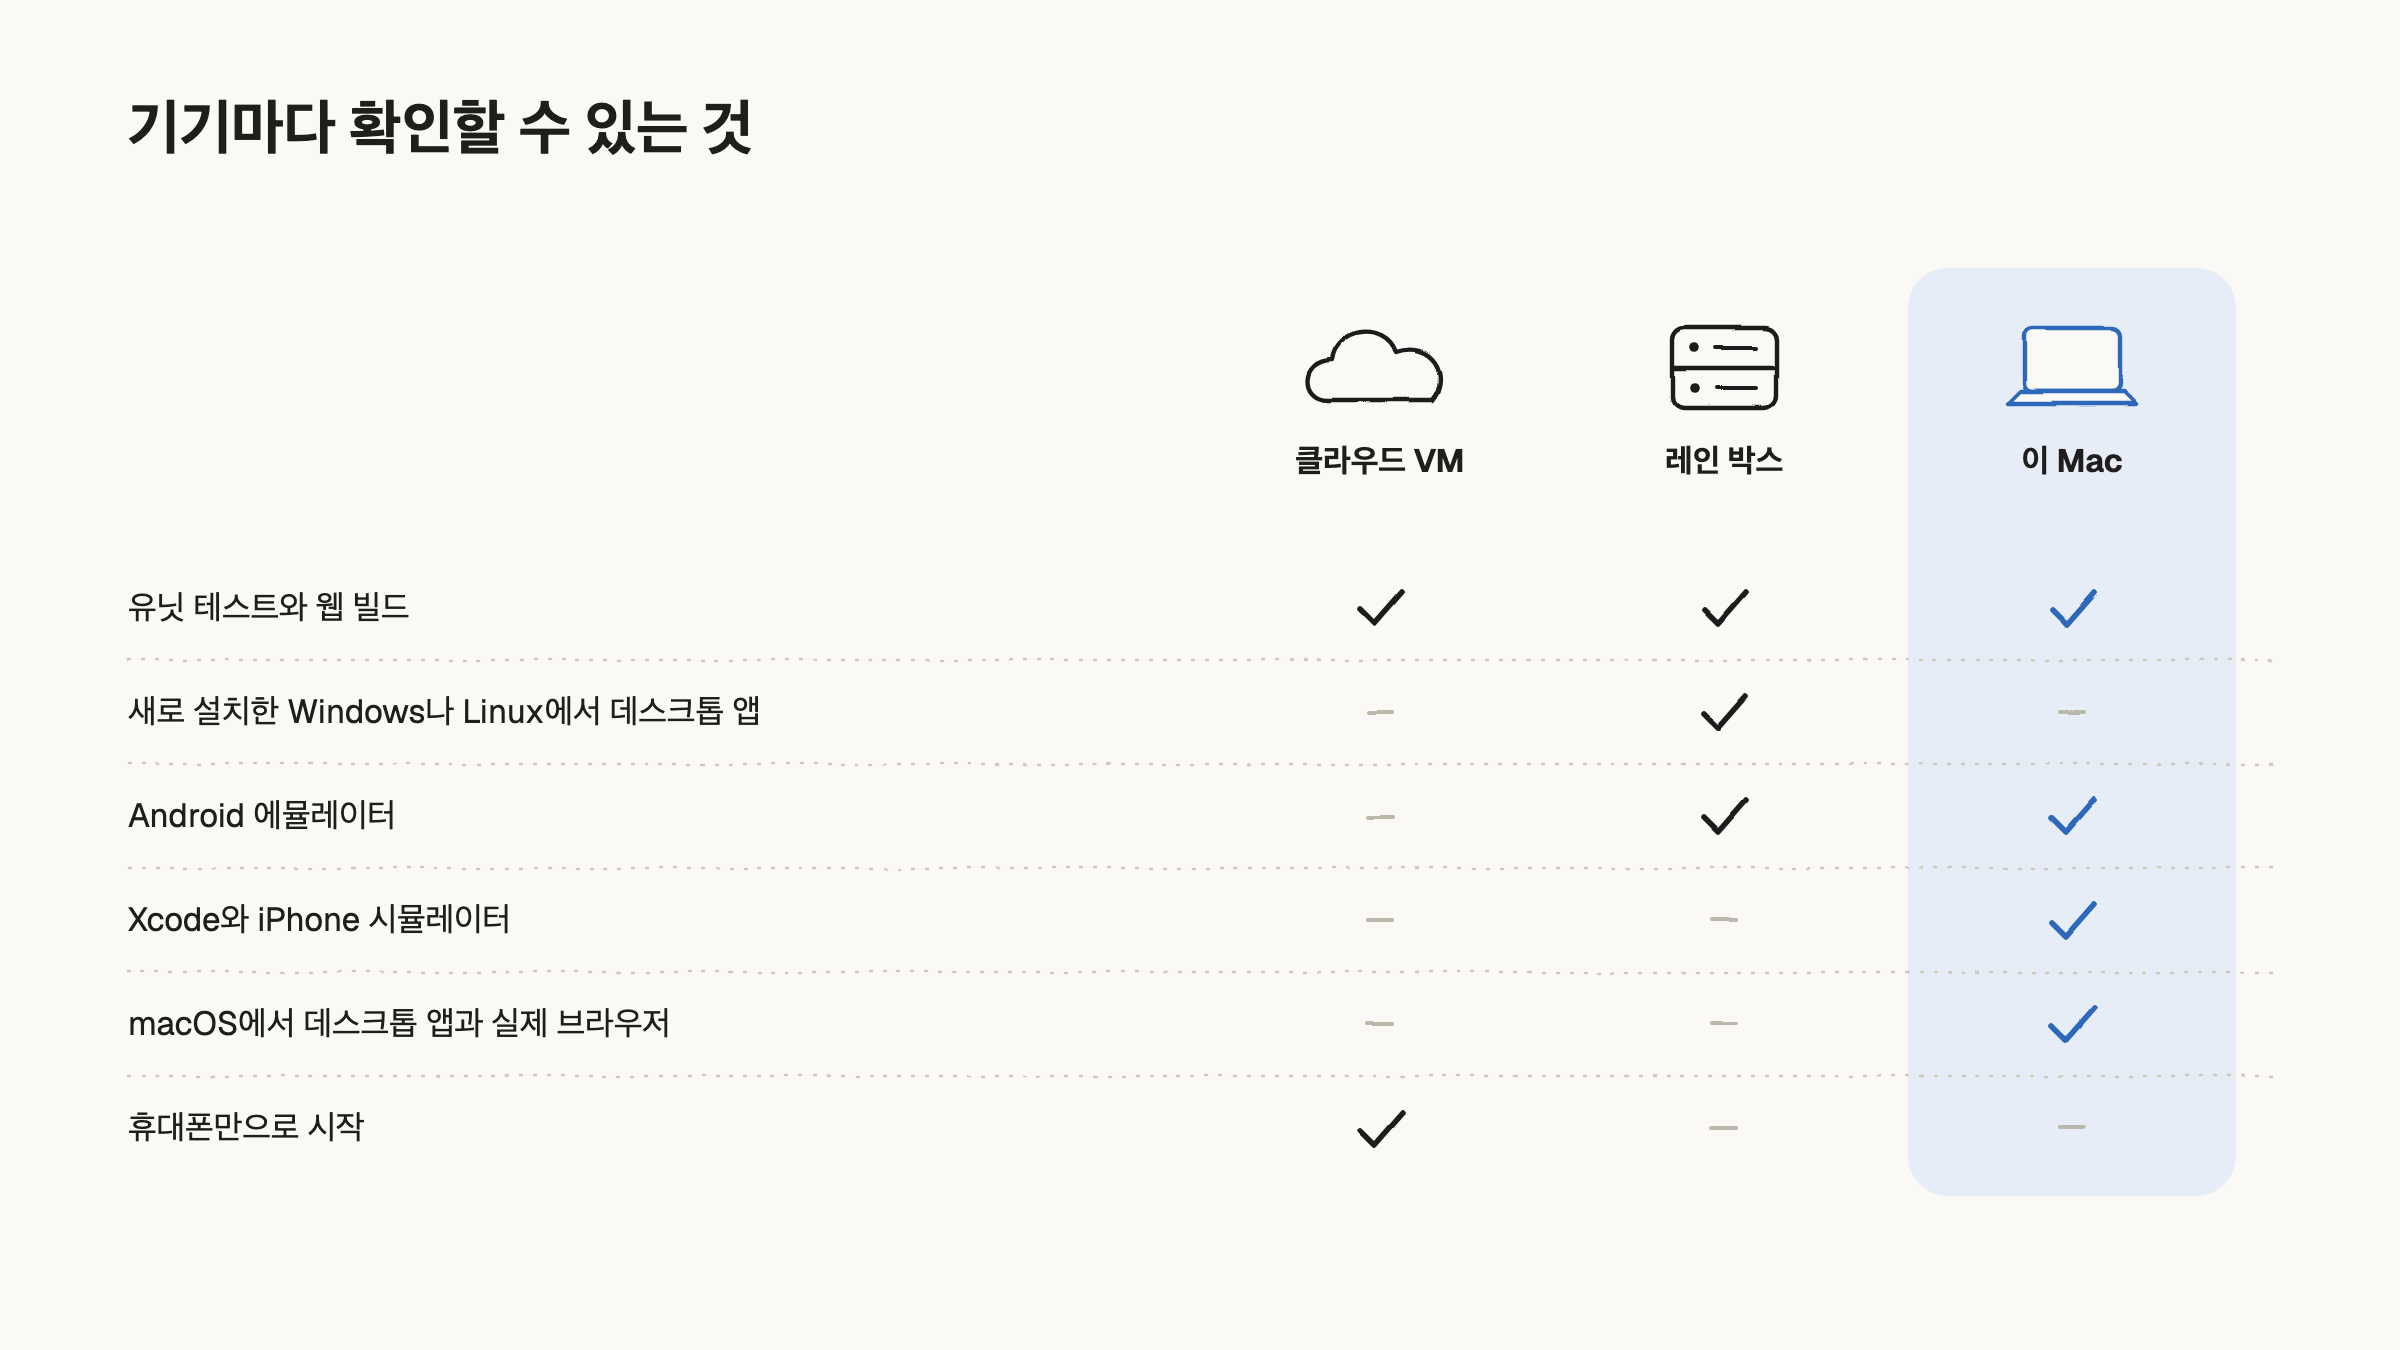
클라우드 VM은 격리된 Linux 작업에 알맞고, 휴대폰에서도 바로 시작할 수 있습니다. 새로 설치한 Windows나 Linux에서 데스크톱 앱을 띄워 보거나 Android 에뮬레이터를 돌려야 하면, 세션은 쓰고 버리는 EC2 인스턴스를 하나 받습니다. 저희는 이걸 레인 박스라고 부릅니다. 그리고 Xcode, iPhone 시뮬레이터, 실제 Chrome, macOS용 데스크톱 앱까지 전부 확인할 수 있는 건 Mac뿐입니다.
그래서 세션 대부분이 Mac 한 대에서 돌게 됐습니다. 이 Mac은 저희가 매일 쓰는 컴퓨터이기도 해서, 모든 세션이 메모리 하나를 나눠 쓰며 실제 데이터 바로 옆에서 일합니다.
에이전트를 띄우는 건 이미 풀린 문제입니다
에이전트 여러 개를 한꺼번에 돌리는 도구는 이미 많습니다. 저희가 살펴본 도구는 모두 병렬 실행을 쉽게 만들어 주고, 몇몇은 에이전트끼리 대화하게도 해 줍니다. 도구마다 다른 건 에이전트가 어디서 도는지, 그리고 그 결과를 얼마나 확인해 주는지입니다.
Claude Code와 Codex
둘은 에이전트 그 자체입니다. Claude Code는 터미널을 닫아도 계속 도는 백그라운드 세션을 저마다의 worktree에서 실행하고(claude --bg --worktree), 세션끼리 메시지를 주고받거나 서브에이전트를 띄울 수 있습니다. 웹이나 휴대폰에서 시작하는 클라우드 세션도 있습니다. Codex는 CLI, 데스크톱 앱, IDE 확장으로 쓸 수 있고, Codex Web은 OpenAI 클라우드의 Linux 컨테이너에서 작업을 돌립니다.
Orca
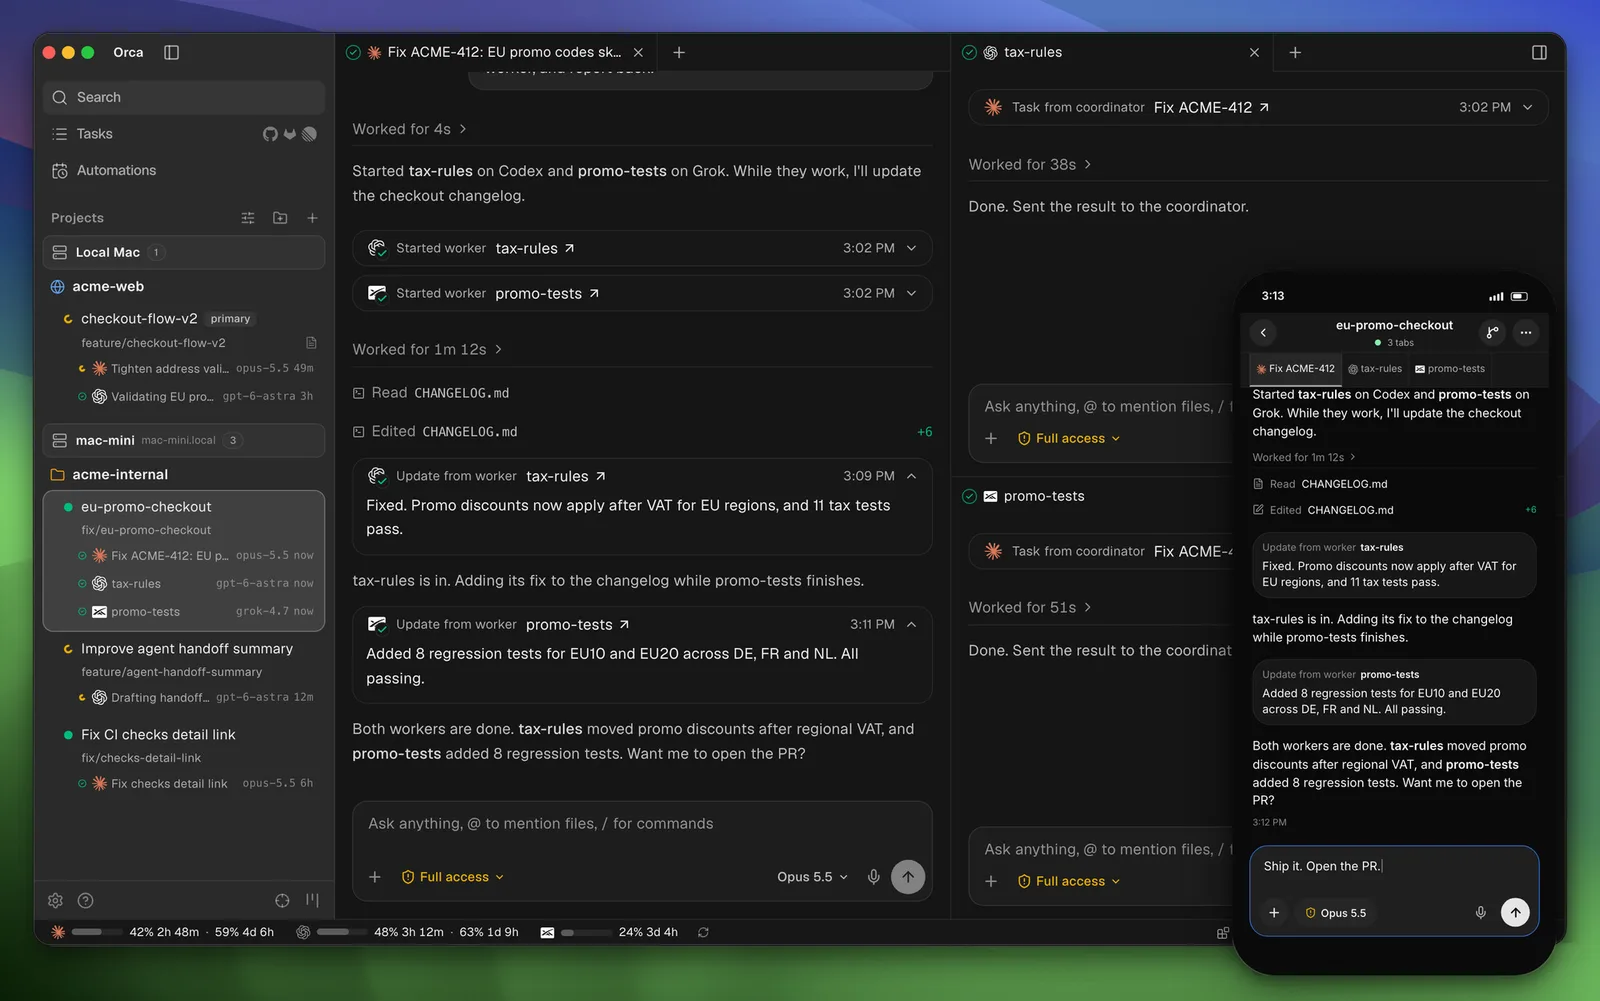
Orca는 macOS, Windows, Linux용 데스크톱 앱입니다. Claude Code나 Codex 같은 CLI 에이전트를 저마다의 worktree에서 병렬로 돌리고, 큰 작업을 맡기면 코디네이터 에이전트가 일을 나눠 워커에게 맡긴 뒤 결과를 모아 옵니다. 위 화면이 바로 그 장면입니다. 에이전트는 SSH 호스트나 worktree마다 붙는 클라우드 VM에서도 돌 수 있고, 실패한 검사와 리뷰 코멘트는 고치라고 에이전트에게 다시 돌려보냅니다.
herdr
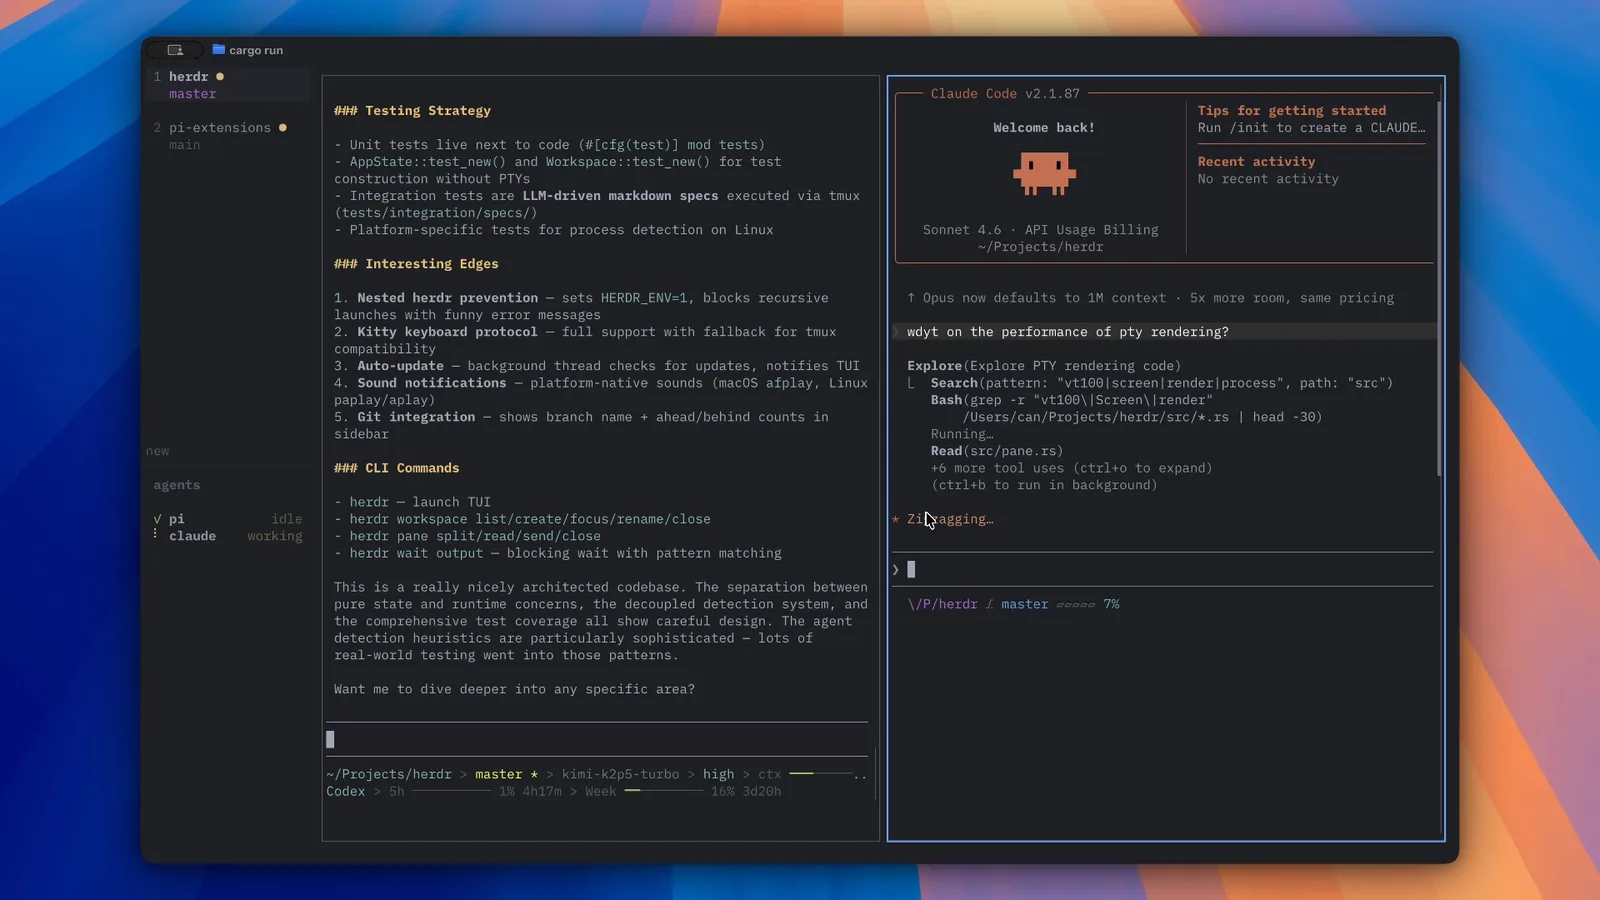
herdr는 Rust 바이너리 하나로 된 터미널 런타임입니다. 에이전트를 감싸지 않고 터미널만 맡기 때문에 Claude Code, Codex, OpenCode 어느 것과도 똑같이 동작합니다. SSH 연결이 끊겨도 터미널은 백그라운드에서 계속 돌고, 창마다 에이전트가 working인지 blocked인지 idle인지 보여 주며, 에이전트끼리 CLI와 소켓 API로 프롬프트를 주고받게 해 줍니다.
Kiro Crew
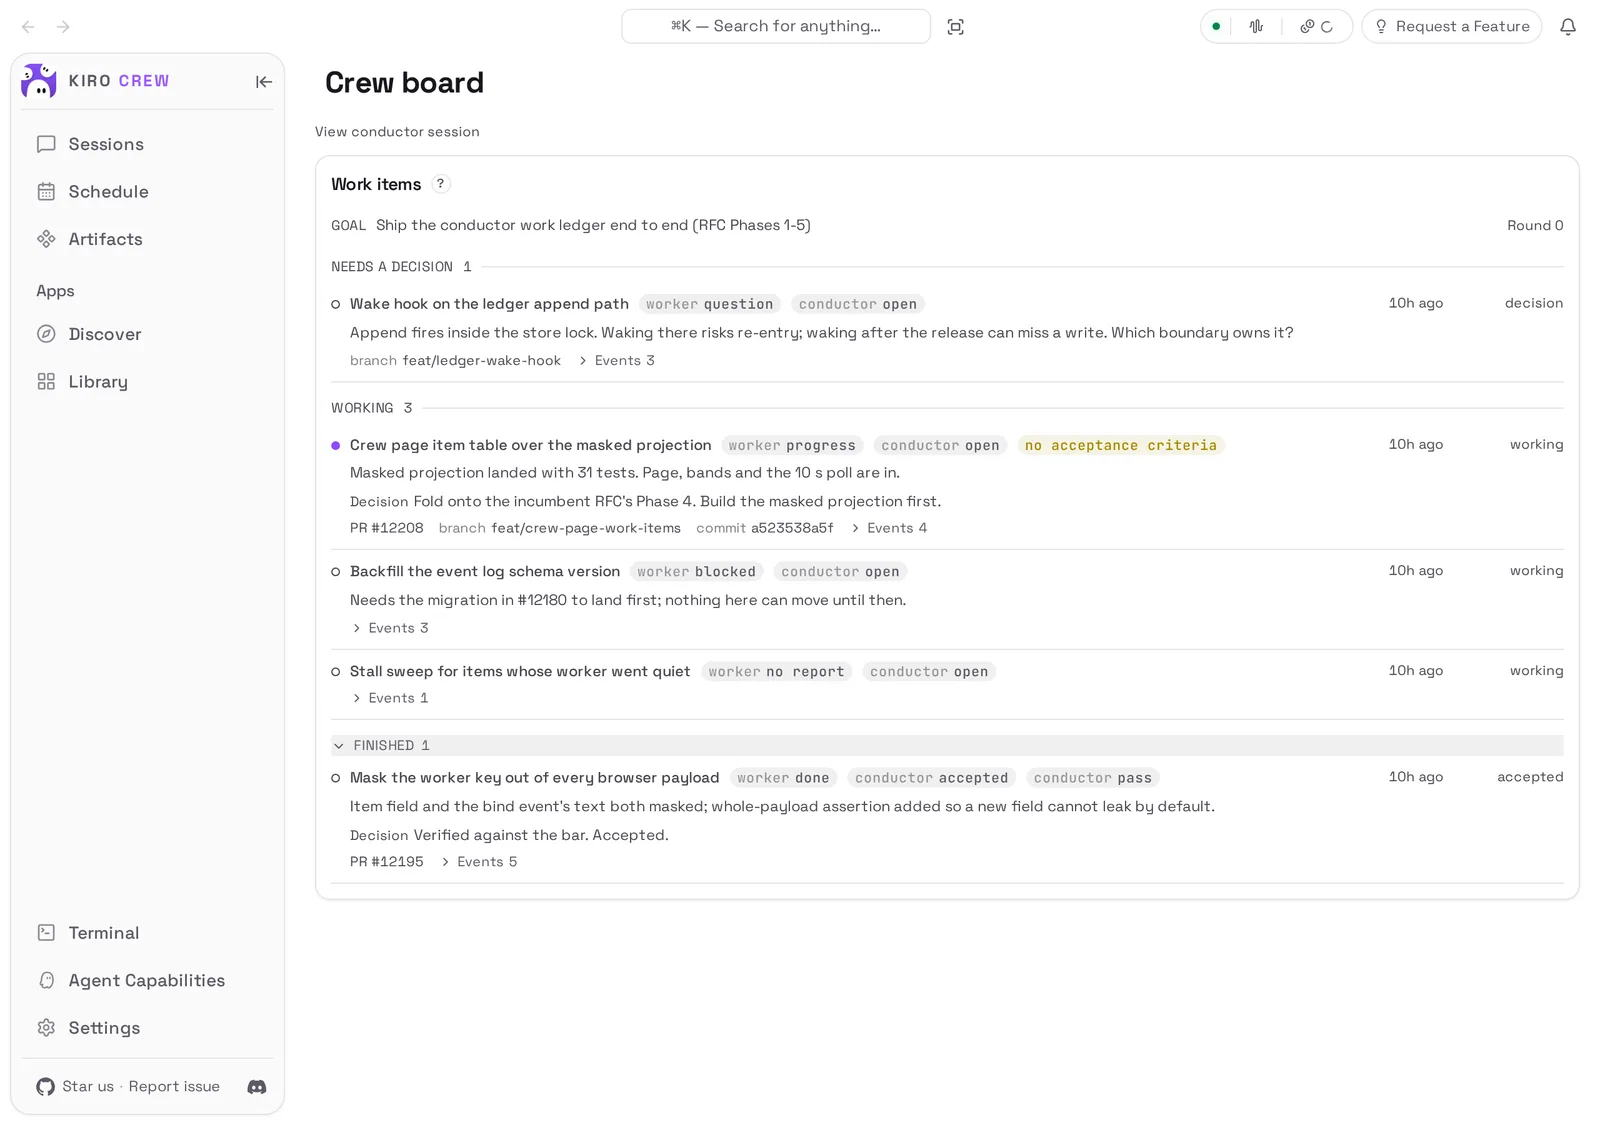
Kiro Crew는 Mac, 컨테이너, 원격 기기 같은 사용자의 하드웨어에서 돌면서 대화와 대화 사이에도 계속 일하는 작업 공간입니다. 세션과 메모리, 작업 체크포인트는 재시작해도 남고, 사람이 고쳐 준 내용은 다음 행동을 바꾸는 교훈으로 쌓입니다. 위의 crew board에는 conductor가 나눠 준 항목마다 워커가 보고한 내용과, conductor가 그 결과를 기준에 맞춰 받아들였는지가 함께 나옵니다.
Foxl Code
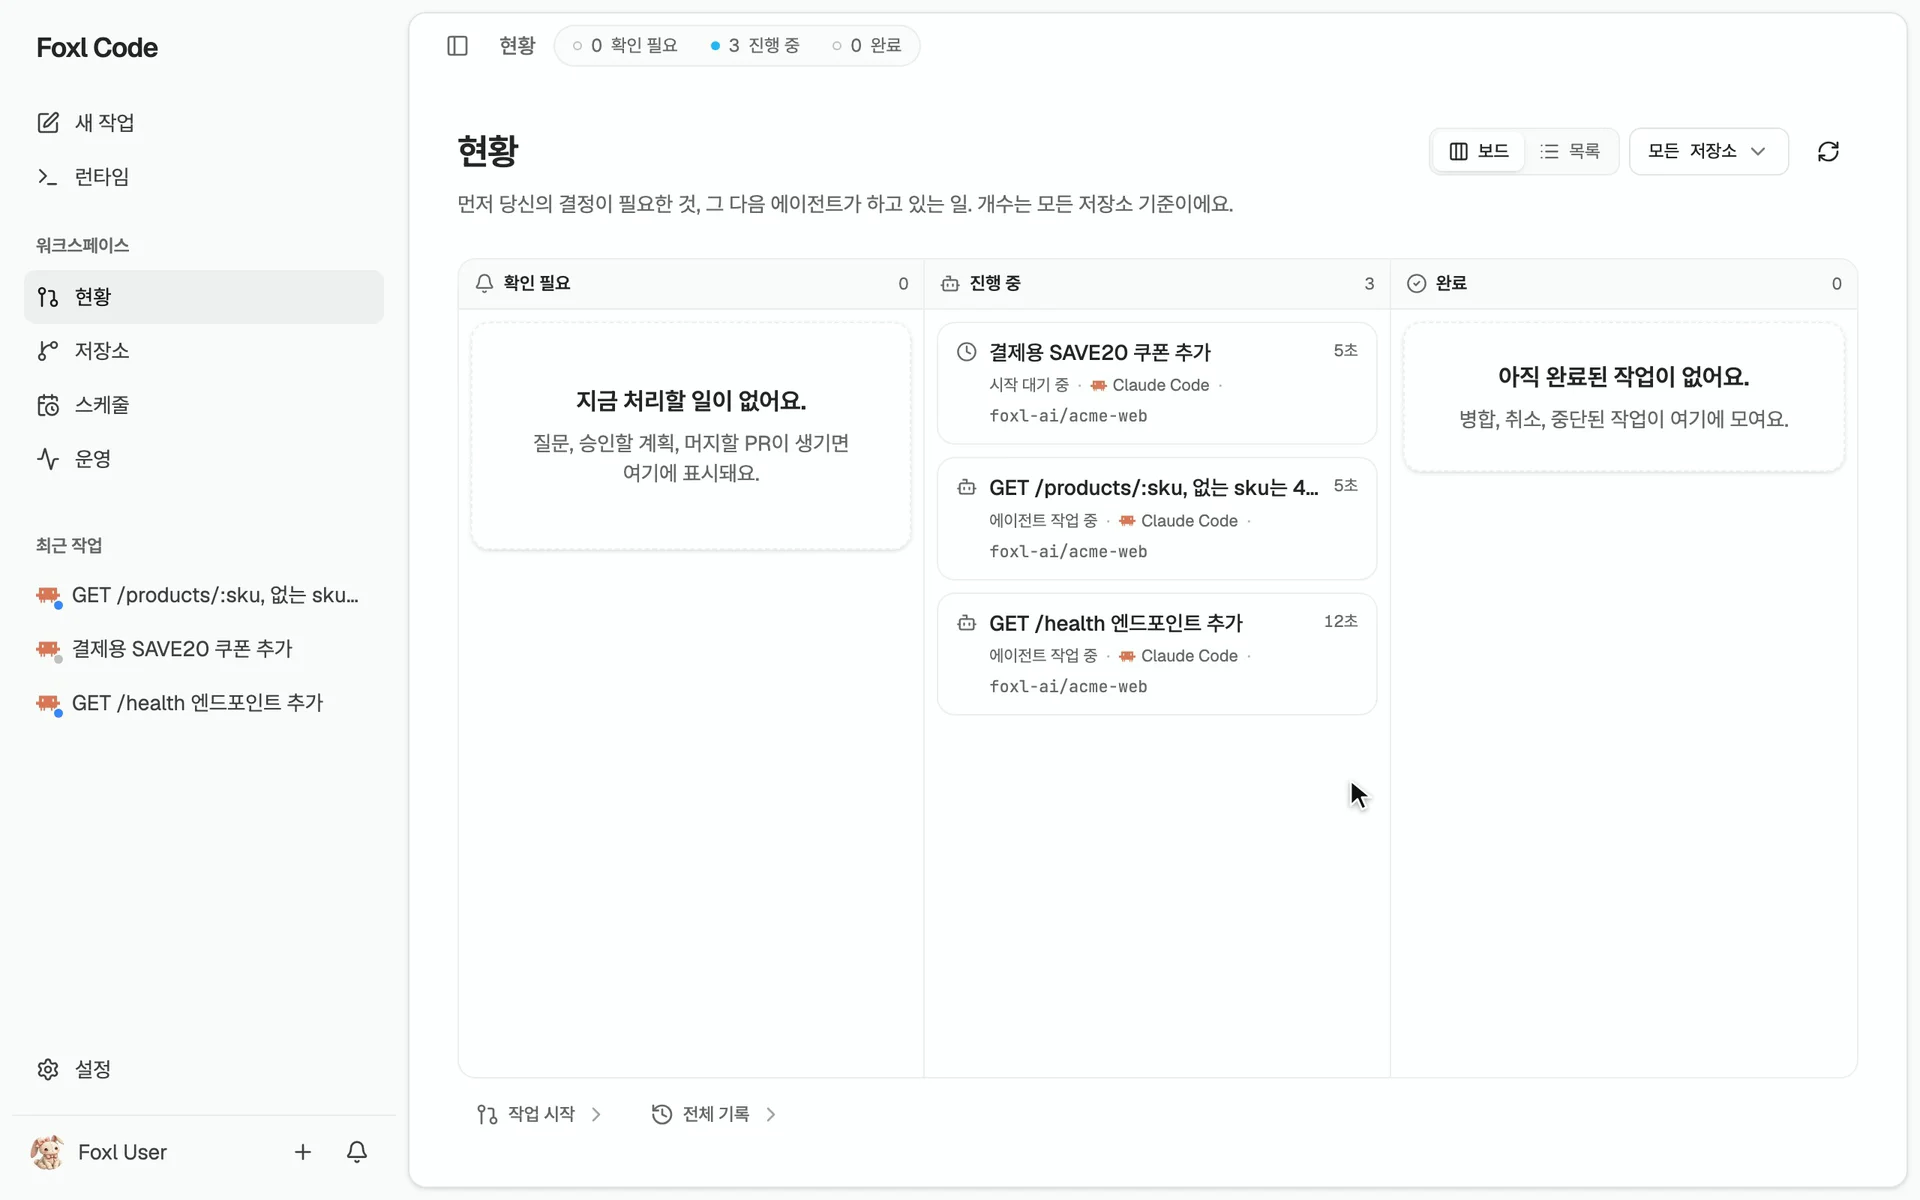
Foxl Code는 앞에서 말씀드린 저희 클라우드 제품이고, 지금은 초대받은 계정만 쓰는 비공개 베타입니다. 브라우저나 휴대폰에서 작업을 설명하면 작업마다 VM 하나에서 Claude Code 같은 에이전트가 일합니다. 큰 요청은 서로 독립된 하위 작업으로 나뉘어 동시에 시작하고, 하위 작업마다 풀 리퀘스트가 하나씩 나옵니다. 위 화면이 요청 하나가 하위 작업 세 개로 나뉜 직후의 현황 보드입니다. 리뷰어는 저장소의 MERGE-REVIEW.md를 풀 리퀘스트가 아니라 기본 브랜치에서 읽습니다. 변경이 자기를 채점하는 기준을 고쳐 쓸 수 없게 하려는 것입니다. 다만 풀 리퀘스트는 하나씩 따로 확인되고, 여러 개를 합친 상태로 시험하려면 채팅에서 머지 트레인을 따로 요청해야 합니다.
한눈에 비교하면 다음과 같습니다.
| 도구 | 에이전트가 도는 곳 | 장점 | 한계 |
|---|---|---|---|
| Claude Code | 사용자 기기, 또는 웹이나 휴대폰에서 시작하는 클라우드 세션 | 저마다의 worktree에서 돌면서 서로를 보고 메시지를 주고받는 백그라운드 세션, 서브에이전트 | 메시지가 Claude Code 세션에만 닿음 |
| Codex | 사용자 기기, 또는 OpenAI 클라우드 | CLI, 데스크톱 앱, IDE, 클라우드에서 같은 에이전트 | 클라우드 작업은 Linux 컨테이너라 Xcode 작업은 로컬에 남음 |
| Orca | 사용자 기기, SSH 호스트, worktree마다 붙는 클라우드 VM | 어떤 CLI 에이전트든, 작업을 워커에게 나누는 코디네이터, 휴대폰 앱, 실패한 검사를 에이전트에게 돌려보냄 | 여러 풀 리퀘스트를 합친 상태로 시험하는 기능은 설명에 없음 |
| herdr | 사용자 기기와 SSH 호스트 | 어떤 에이전트 밑에도 깔림: 끊겨도 도는 터미널, 창마다 working, blocked, idle, 에이전트끼리 프롬프트 | 터미널만 맡고 작업은 맡지 않음: 자체 리뷰나 머지 단계는 없음 |
| Kiro Crew | 사용자의 Mac, 컨테이너, 원격 기기 | 재시작해도 남는 세션, 메모리, 체크포인트, 고쳐 준 내용에서 얻는 교훈, 기준에 맞춰 작업을 받아들이는 conductor | 워커끼리 직접 통하는 채널은 아직 없음 |
| Foxl Code | 작업마다 VM 하나, Foxl 클라우드 | 휴대폰에서 시작, 풀 리퀘스트 하나씩 동시에 도는 하위 작업, 저장소의 머지 기준을 따르는 리뷰어 | 비공개 베타, macOS 없음, 풀 리퀘스트를 합쳐서 시험하는 건 요청한 머지 트레인에서만 |
저희는 Claude Code 자체의 세션 위에 팩토리를 쌓았습니다. 팩토리가 Claude Code 세션 하나에서 자라났고, 이 Mac의 세션들은 Xcode와 시뮬레이터 바로 옆에서 이미 서로를 보고 메시지를 주고받을 수 있었기 때문입니다.
어떤 도구로 에이전트를 돌리든 변하지 않는 것이 두 가지 있습니다. 한 기기에서 도는 에이전트들은 그 기기의 메모리를 나눠 써야 하고, 그들이 한 일이 맞는지는 누군가 판단해야 합니다. 이 글의 나머지는 이 두 가지에 대한 이야기입니다.
메모리 하나를 스무 세션이 나눠 쓰는 법
10월 17일 오후, 세션 19개가 열려 있었습니다. 웹 빌드 한 번이 메모리를 3.5 GB쯤 먹는데, 10분 사이에 네 세션이 그 빌드를 요청했습니다. 두 세션은 TypeScript 검사를 돌렸고, 한 세션은 묻지도 않고 iPhone 시뮬레이터를 띄웠습니다. 같은 CSS 파일에 변경을 열어 둔 세션도 여덟 개나 됐습니다. 그날 오후 저희는 세션들에게 메모리를 덜 쓰고, 차례를 기다리고, 쓰기 전에 먼저 물어보라고 했습니다.
그날 세션 하나가 코디네이터가 됐습니다. 다른 세션은 시작할 때 누가 어떤 파일을 맡았는지 적힌 공유 파일을 읽고, 자기가 할 일과 건드릴 파일을 한 줄로 코디네이터에게 보낸 뒤 범위를 받습니다. 다른 세션이 맡은 파일을 고쳐야 하면 그 세션에게 변경 내용을 보내 대신 반영하게 합니다. 빌드나 테스트, 시뮬레이터처럼 메모리를 많이 쓰는 일을 시작하기 전에는 예상 메모리와 시간을 담아 HEAVY?를 보내고 GO를 기다립니다. 코디네이터는 허가를 내줄 때마다 Mac의 메모리 압력을 읽습니다.
아래는 이 글의 첫 빌드가 기다린 대기열입니다. 모델 벤치마크와 시뮬레이터 실행이 먼저 줄을 서 있었고, 이 글의 빌드는 50분을 기다린 뒤에야 시작했습니다.
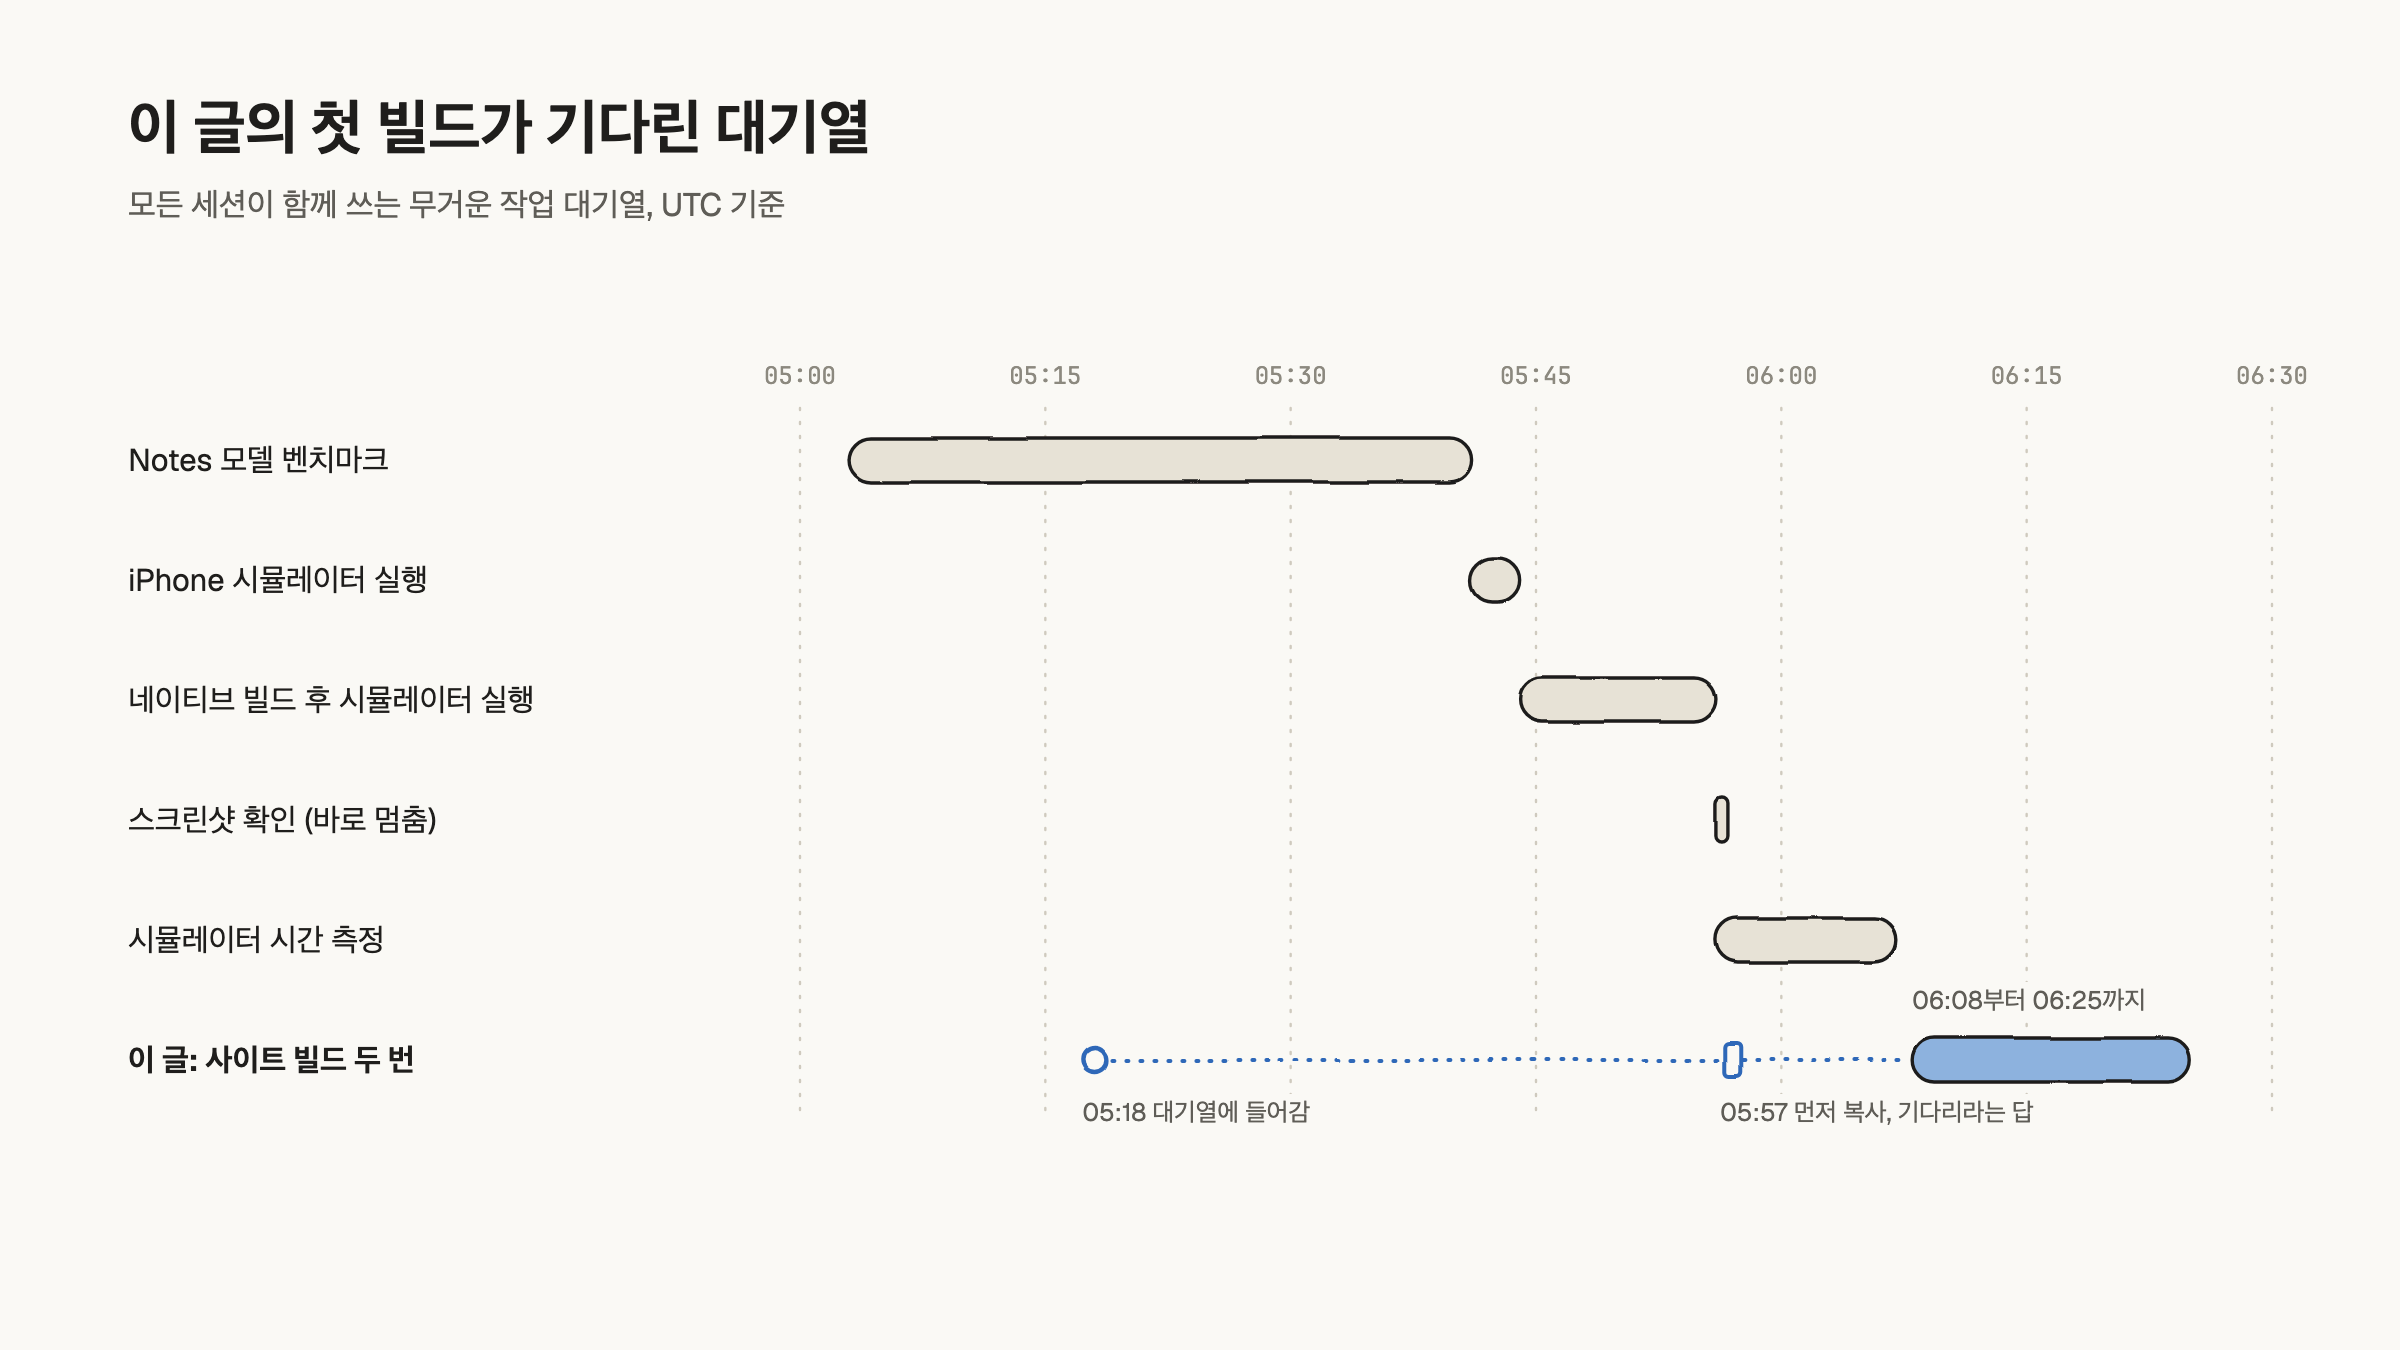
대기열의 규칙은 셸 스크립트 heavy.sh 하나에 들어 있고, 그 규칙은 몇 번이나 바뀌었습니다. 10월 28일에는 너무 빡빡했습니다. Mac 메모리가 43% 남아 있는데도 작업 열 개가 길게는 16분씩 기다렸고, 저희는 대기열을 없앴습니다. 11월 2일에는 반대로 너무 느슨했습니다. 세션 19개쯤이 열려 있었고 그중 여럿이 서브에이전트를 2~5개씩 돌렸는데, 게이트는 서브에이전트도, 6시간째 떠 있던 개발 서버도 세지 않았습니다. 결국 Mac 메모리가 바닥났고, 하네스가 백그라운드 셸들을 정리하면서 코디네이터의 감시 프로세스까지 함께 죽었습니다.
지금의 게이트는 실행할 때마다 Mac의 메모리 상태를 잽니다. 여유가 있으면 바로 실행하고, 없으면 붙잡아 두며, 동시에 도는 무거운 작업은 많아야 네 개입니다. 무거운 일 앞에서 하는 검사는 대략 이렇습니다.
# LOCKS is a directory every session shares; run/<pid> marks a heavy run.
level=$(sysctl -n kern.memorystatus_vm_pressure_level)  # 1 normal, 2 warn, 4 critical
free=$(memory_pressure -Q | awk -F: '/free percentage/ {print int($2)}')
live=0
for f in "$LOCKS"/run/*; do
  [ -e "$f" ] && kill -0 "${f##*/}" 2>/dev/null && live=$((live + 1))
done

hold() {
  [ -e "$LOCKS/STOP" ] || [ "$level" -ge 4 ] ||
  { [ "$level" -ge 2 ] && [ "$live" -ge 2 ]; } ||
  [ "$free" -lt 25 ] || { [ "$free" -lt 30 ] && [ "$live" -ge 1 ]; } ||
  [ "$live" -ge 4 ]
}
# Wait while hold() is true or older tickets fill the free slots (2 at warn, 4 otherwise).
# Then write run/$$, run "$@" as a child, and remove run/$$ when it exits.
기다리는 작업은 먼저 온 순서대로 번호표를 받습니다. 한때 30개쯤이 기다릴 때, 슬롯이 비는 순간 먼저 확인한 쪽이 이기는 바람에 작업 하나가 뒤에 온 것들에 밀려 35분을 기다린 적이 있습니다. 기기 전체에서 서브에이전트는 여섯 개까지, 시뮬레이터는 한 대까지라는 한도도 있습니다. 다만 이 두 한도는 아직 게이트가 강제하지 않는, 글로만 된 규칙입니다.
글로만 써 둔 규칙은 깨집니다
이 글에 나오는 사고는 모두 규칙을 하나씩 남겼고, 그 규칙은 날짜와 함께 글로 남았습니다. 그중 세 가지를 보면 글로만 쓴 규칙이 어떤 길을 걷는지 알 수 있습니다.
첫 번째는 실제 데이터입니다. 저희가 실제로 쓰는 Foxl 데스크톱 앱에서 띄운 에이전트 세션은 앱의 환경 변수를 물려받는데, 그중에는 앱 데이터베이스 위치를 가리키는 변수도 있습니다. 10월 19일, 그런 셸에서 돌린 테스트가 실제 Foxl 데이터베이스에 가짜 대화 305개를 써 넣었습니다. 그 변수를 지우라는 규칙이 그날 들어갔고, heavy.sh는 10월 24일부터 그 변수를 스스로 지웠습니다. 그래도 실수는 반복됐습니다. npm으로 직접 돌린 검사, 일회성 스크립트, 데스크톱 서버를 통째로 번들하는 테스트까지, 매번 래퍼가 덮지 않는 길로 들어왔습니다. 지금은 데스크톱 서버가 테스트 러너 아래에서 돌 때 실제 데이터 열기를 아예 거부합니다(foxl/server/paths.ts). 일회성 스크립트만은 아직 글로 쓴 규칙에 기대고 있습니다.
두 번째는 진짜 요금이 나가는 스크립트입니다. check-remote-input.mjs는 저장소를 읽고 문제가 있으면 실패하는 check- 스크립트 수십 개 사이에 섞여 있지만, 실제로는 프로덕션 Foxl Code에서 진짜 작업을 시작합니다. 9월 23일, 모든 check- 스크립트를 한꺼번에 돌리다가 작업 하나가 시작됐습니다. 그때 정한 규칙은 검사를 이름으로 하나씩 돌리라는 것이었습니다. 10월 18일에는 grep으로 골라낸 검사 목록에 또 섞여 들어갔고, 그 작업 세 개의 요금 때문에 테스트용 계정 잔액이 마이너스가 됐습니다. 지금 이 스크립트는 --live 플래그 없이는 아무것도 하지 않고, pr-validate의 테스트가 그걸 지킵니다.
세 번째는 push 잠금입니다. push는 디렉터리를 만들어서 얻는 잠금을 거쳤습니다. 11월 2일, 한 세션이 병렬 도구 호출 묶음 안에서 손으로 잠금을 잡으려 했습니다. 다른 세션이 잠금을 쥐고 있어서 디렉터리를 만드는 단계는 실패했는데, 나머지 단계는 그대로 실행됐습니다. 그 세션은 push를 했고, 다른 세션의 잠금까지 지웠습니다. 그날 아침 잠금을 잡고 자기 것만 푸는 스크립트를 넣었지만, 자기 worktree 안에 갇힌 세션은 그 스크립트를 쓸 수 없어서 계속 손으로 한 단계씩 잠금을 잡았습니다. 같은 실수는 11월 4일에 또 일어났습니다.
세 검사 중 어느 것도 그 종류의 실수를 끝내지는 못했습니다. 각각은 지난 실수가 들어온 길을 막았을 뿐이고, 지금까지는 다음 실수가 매번 다른 길을 찾아냈습니다.
초록색 체크가 증명하는 것
저희 CI는 모두 자체 러너에서 돌고, 모든 풀 리퀘스트는 pr-validate라는 관문을 통과해야 합니다. 문제는 그 초록색 체크가 무엇을 증명하느냐입니다. 초록색은 그 풀 리퀘스트가 혼자서 테스트를 통과했다는 뜻일 뿐입니다.
9월 24일, v0.7.27의 첫 머지 트레인에서 이 차이가 드러났습니다. 풀 리퀘스트 54개가 저마다의 CI에서 모두 초록색이었는데, 막아야 할 결함이 네 개나 있었습니다. 하나는 입력기로 친 마지막 글자를 잃어버렸고, 다른 하나는 iPhone 잠금 화면에서 답장하기를 망가뜨렸습니다. 그날은 리뷰어 에이전트 19개를 한꺼번에 돌리다가 Mac이 아예 멈춰 버리기도 했습니다. 그 뒤로 리뷰어는 한 번에 일곱 개까지만 돌리기로 정했지만, 이것도 글로만 정한 규칙입니다.
그래서 지금은 준비된 풀 리퀘스트를 모두 합친 트리로 트레인을 만들고, 그 트리 위에서 머지 여부를 판단합니다. 리뷰어 에이전트는 서로 관련된 풀 리퀘스트를 한 묶음씩 맡는데, 리뷰어가 받는 지시문에는 이런 문장이 있습니다.
Your job is to REFUTE each PR in your group, not to confirm it. Assume every PR body overclaims until you have reproduced its claim. A green pr-validate on the PR proves little: it ran without the other PRs, and it cannot see UX or cost.
각 풀 리퀘스트를 확인하지 말고 반박하라는 지시입니다. 주장을 직접 재현하기 전까지는 모든 PR 본문이 과장한다고 가정하라는 것, 그리고 PR에서 통과한 pr-validate는 다른 PR 없이 돈 결과이고 UX나 비용은 보지 못하니 증명하는 게 거의 없다는 내용입니다. 리뷰어는 MERGE, 패치를 함께 적어 내는 MERGE_WITH_FIXES, HOLD, CLOSE 가운데 하나로 답합니다. 수정은 풀 리퀘스트 위에 별도 커밋으로 올리고, 고칠 수 없는 풀 리퀘스트는 빼고 트레인을 다시 만듭니다.
Cognition의 글 “Don’t Build Multi-Agents”는 서로의 작업을 볼 수 없는 에이전트들에게 작업 하나를 쪼개 맡기지 말고, 전체 맥락을 가진 에이전트 하나에게 맡기라고 말합니다. 저희도 세션마다 작업 하나를 통째로 맡깁니다. 그래도 남는 문제가 있습니다. 에이전트는 자기 작업을 과신합니다. 리뷰어에게 반박하라고 하는 이유가 여기에 있습니다.
특히 에이전트가 기능과 함께 쓴 테스트는 약한 증거입니다. 테스트와 코드가 문제에 대한 같은 이해에서 나오기 때문에, 에이전트가 벤더 API나 요청의 의도를 잘못 읽었다면 둘 다 같은 실수를 담습니다. 확인 방법마다 볼 수 있는 실패를 정리하면 이렇습니다.
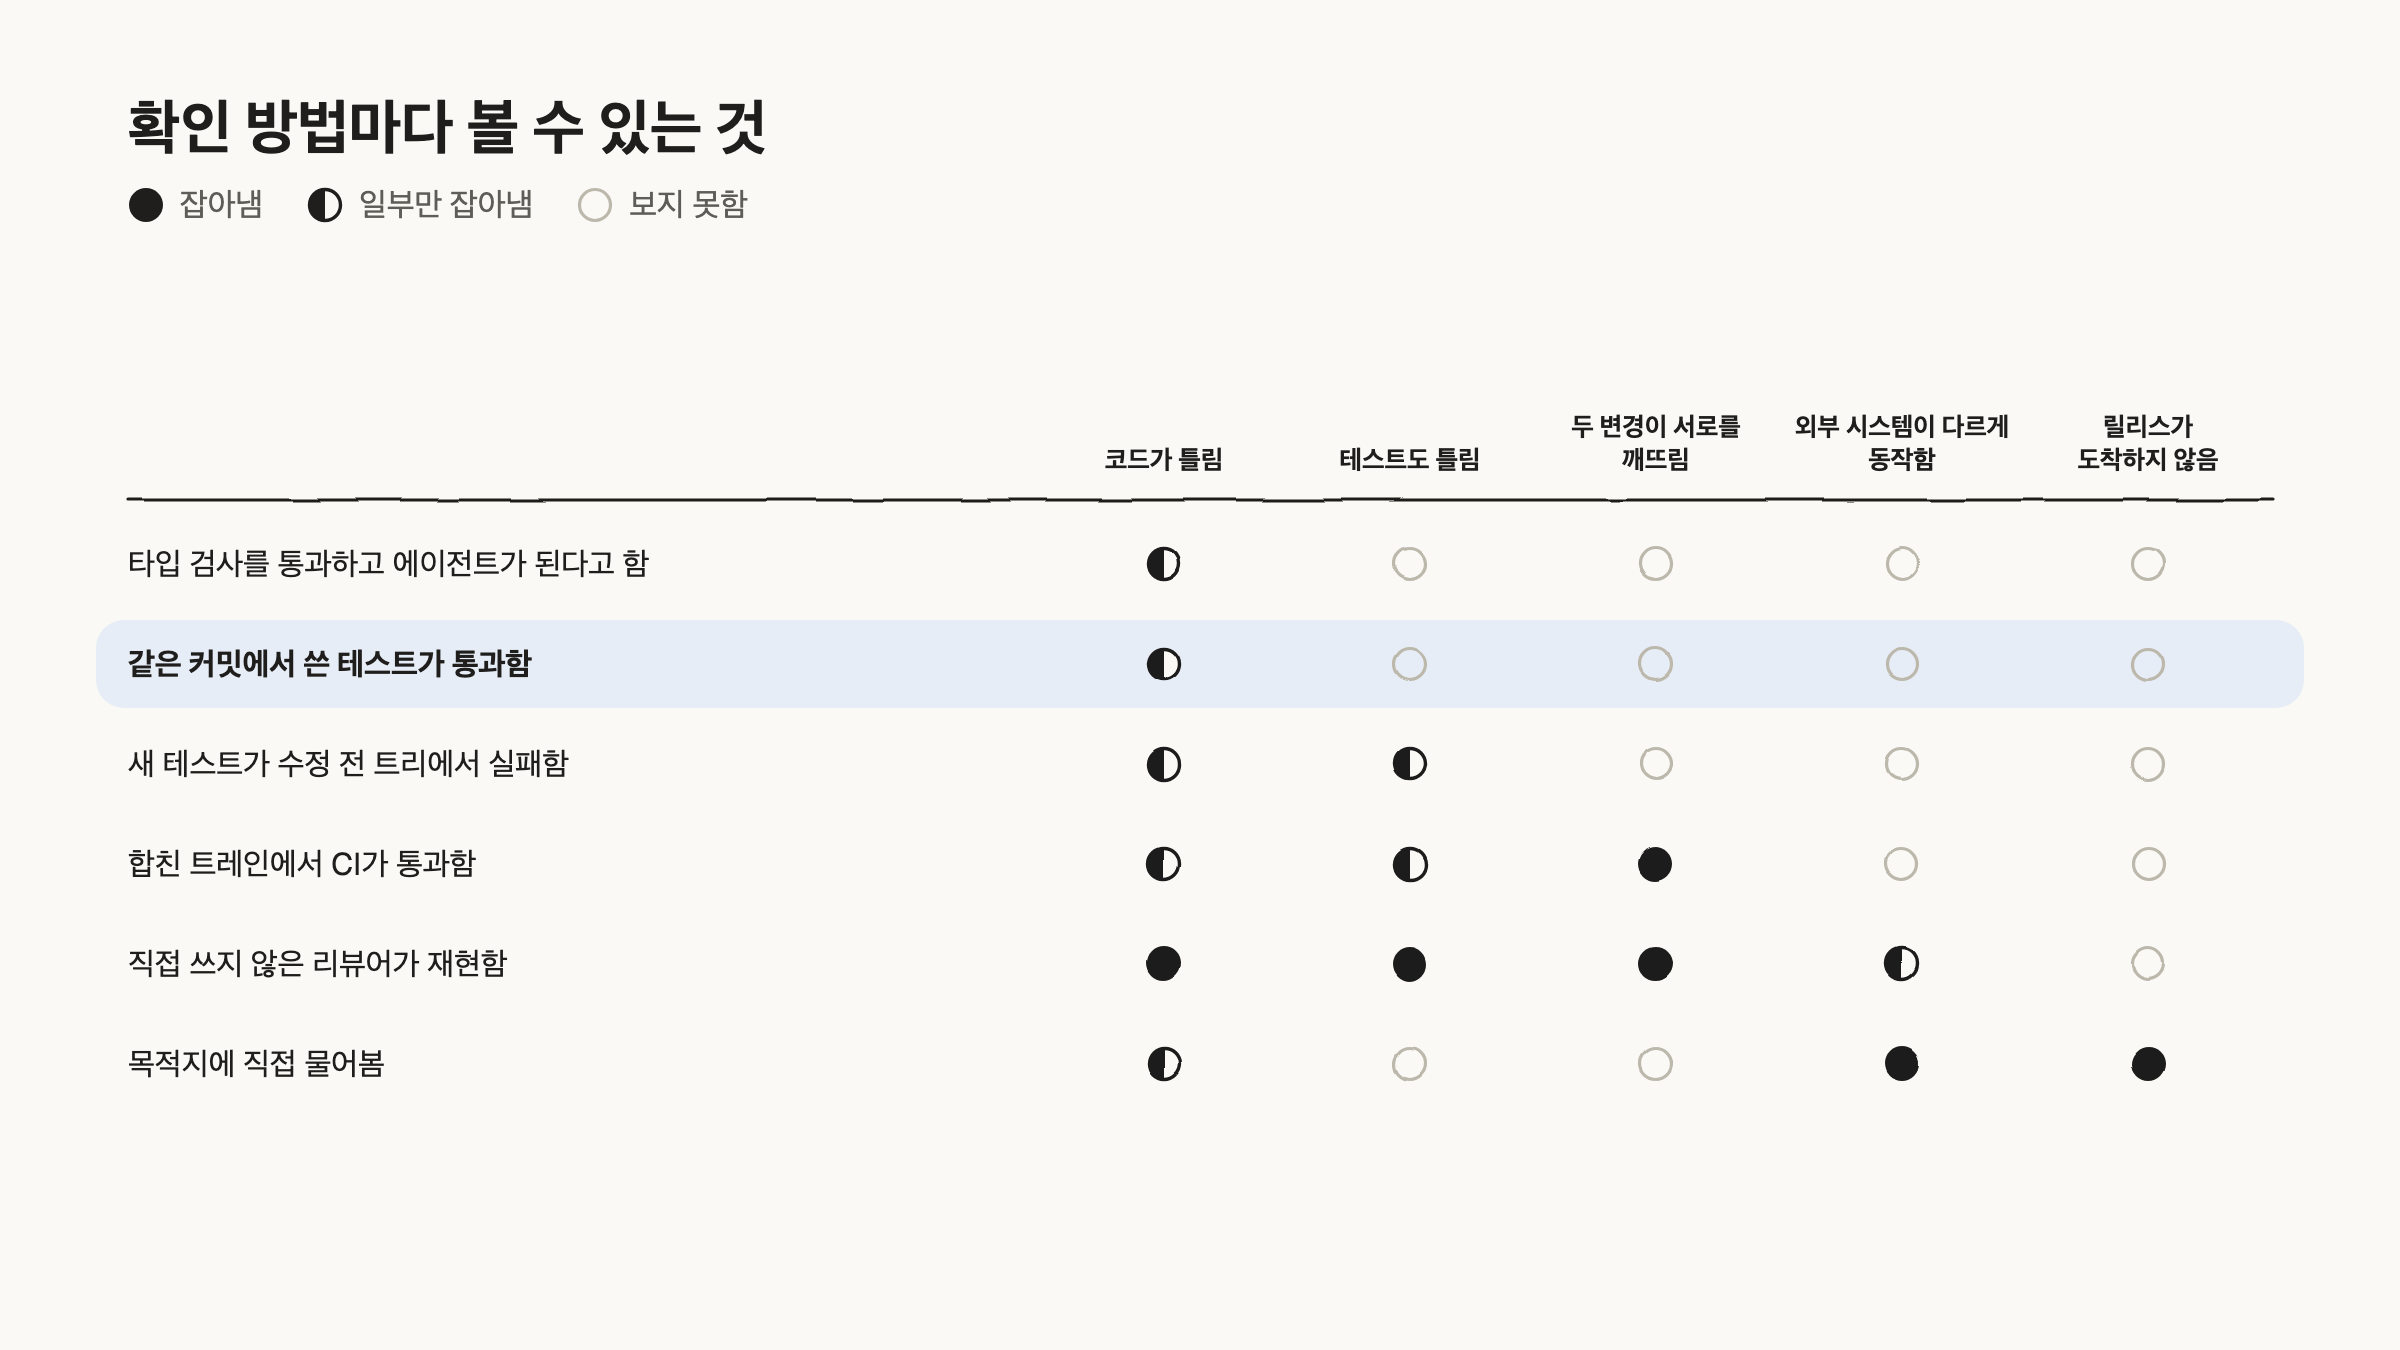
그래서 새 테스트는 수정 전 트리에서 실패할 때만 인정하고, 최종 관문은 합친 트레인의 CI입니다. 저장소 밖에서 일어나는 일이라면 증거는 그 바깥 시스템에 있습니다. CLI 버전을 올린 뒤 열흘 동안 Foxl Code의 원격 Codex와 OpenCode 터미널이 입력을 하나도 받지 못했는데, 그동안 모든 관문은 초록색이었습니다. 릴리스 워크플로가 성공했다고 보고했는데 TestFlight에는 빌드가 없던 적도 있습니다. 11월 3일에는 스크린샷 하네스 43개 중 34개가 실제 폰트 없이 페이지를 띄우고 있었다는 것도 알게 됐습니다. 리뷰어들은 출시된 앱이 그리지도 않는 글자 모양을 보고 판단하고 있었던 셈입니다.
목적지에 직접 물어봅니다
정식 릴리스는 워크플로 실행 한 번입니다. 이 한 번으로 Windows, Linux, macOS, iOS, Android 앱과 웹 앱, 릴레이 서버까지 빌드해서 내보냅니다. 그리고 워크플로가 성공했다는 말만으로는 아무것도 믿지 않습니다. 릴리스 뒤의 검사는 목적지마다 직접 물어봅니다.
스크립트 하나는 다섯 플랫폼 모두에 파일이 올라올 때까지 기다렸다가 릴리스를 공개합니다. Homebrew cask는 공개된 릴리스와 대조합니다. cask를 갱신하는 워크플로는 멀쩡해 보이는데 cask가 릴리스 네 번 내내 일주일 묵은 빌드를 내준 적이 있기 때문입니다. 배포된 웹 앱은 릴리스 버전과 직접 비교합니다. Worker는 낡은 번들로도 200을 응답하기 때문입니다. TestFlight는 Apple API에 직접 물어봅니다.
비슷한 구성을 만들어 보신다면
저희가 효과를 본 방법을 정리하면 이렇습니다.
- 에이전트마다 git worktree를 따로 둡니다. APFS에서는
cp -Rc로node_modules를 copy-on-write 복제하면 디스크를 거의 쓰지 않습니다. 다만node_modules하나를 여러 worktree에 심볼릭 링크로 거는 건 피해야 합니다. - 에이전트 하나를 코디네이터로 정하고, 공유 상태는 모든 에이전트가 읽을 수 있는 평범한 파일에 둡니다. 누가 어떤 파일을 맡았는지, 누가 무엇을 돌리는지, 무엇이 동결됐는지 같은 것들입니다.
- 메모리를 많이 쓰는 일은 실제로 잰 메모리로 관문을 두고, 빌드뿐 아니라 서브에이전트와 개발 서버도 함께 셉니다.
- ref는 이름이 아니라 SHA로 읽습니다. 다른 세션이
origin/*를 수시로 움직이기 때문입니다.
머지 트레인을 만들기 전에는 풀 리퀘스트를 하나씩 차례로 main에 접어 넣어 보면, 체크아웃 없이도 충돌 지도를 그릴 수 있습니다. bash로는 이렇습니다.
# Each head as a local ref first: git fetch origin '+refs/pull/*/head:refs/pr/*'
prs=(101 102 103)
acc=$(git rev-parse origin/main)
for pr in "${prs[@]}"; do
  out=$(git merge-tree --write-tree --name-only "$acc" "refs/pr/$pr"); code=$?
  if [ "$code" -eq 0 ]; then
    acc=$(git commit-tree "${out%%$'\n'*}" -p "$acc" -p "refs/pr/$pr" -m "train: #$pr")
  elif [ "$code" -eq 1 ]; then
    echo "#$pr conflicts in:"; echo "$out" | sed -n '2,/^$/p'
  else
    echo "#$pr: merge-tree failed ($code)"; exit "$code"
  fi
done
변경 기록처럼 모든 풀 리퀘스트가 끝에 한 줄씩 덧붙이는 파일은 거의 모든 충돌에 끼어듭니다. 이 명령에서만 union 머지를 쓰게 하면 피할 수 있습니다. git -c core.attributesFile=<file>로 지정한 파일에 CHANGELOG.md merge=union 한 줄을 적으면 됩니다.
사람이 하는 일
이 구성에서 저희는 코드를 쓰지 않고, diff도 거의 읽지 않습니다. 요청은 대개 한 문장과 스크린샷 한 장입니다. 대신 돌아오는 것들을 읽습니다. 풀 리퀘스트마다 붙은 스크린샷, 트레인마다 나온 리뷰어의 판정, 그리고 릴리스가 끝날 때마다 나오는 보고서입니다. 보고서에는 무엇이 나갔는지, 각 검사가 무엇이라고 답했는지, 그 릴리스에 든 모든 풀 리퀘스트의 스크린샷이 들어갑니다.
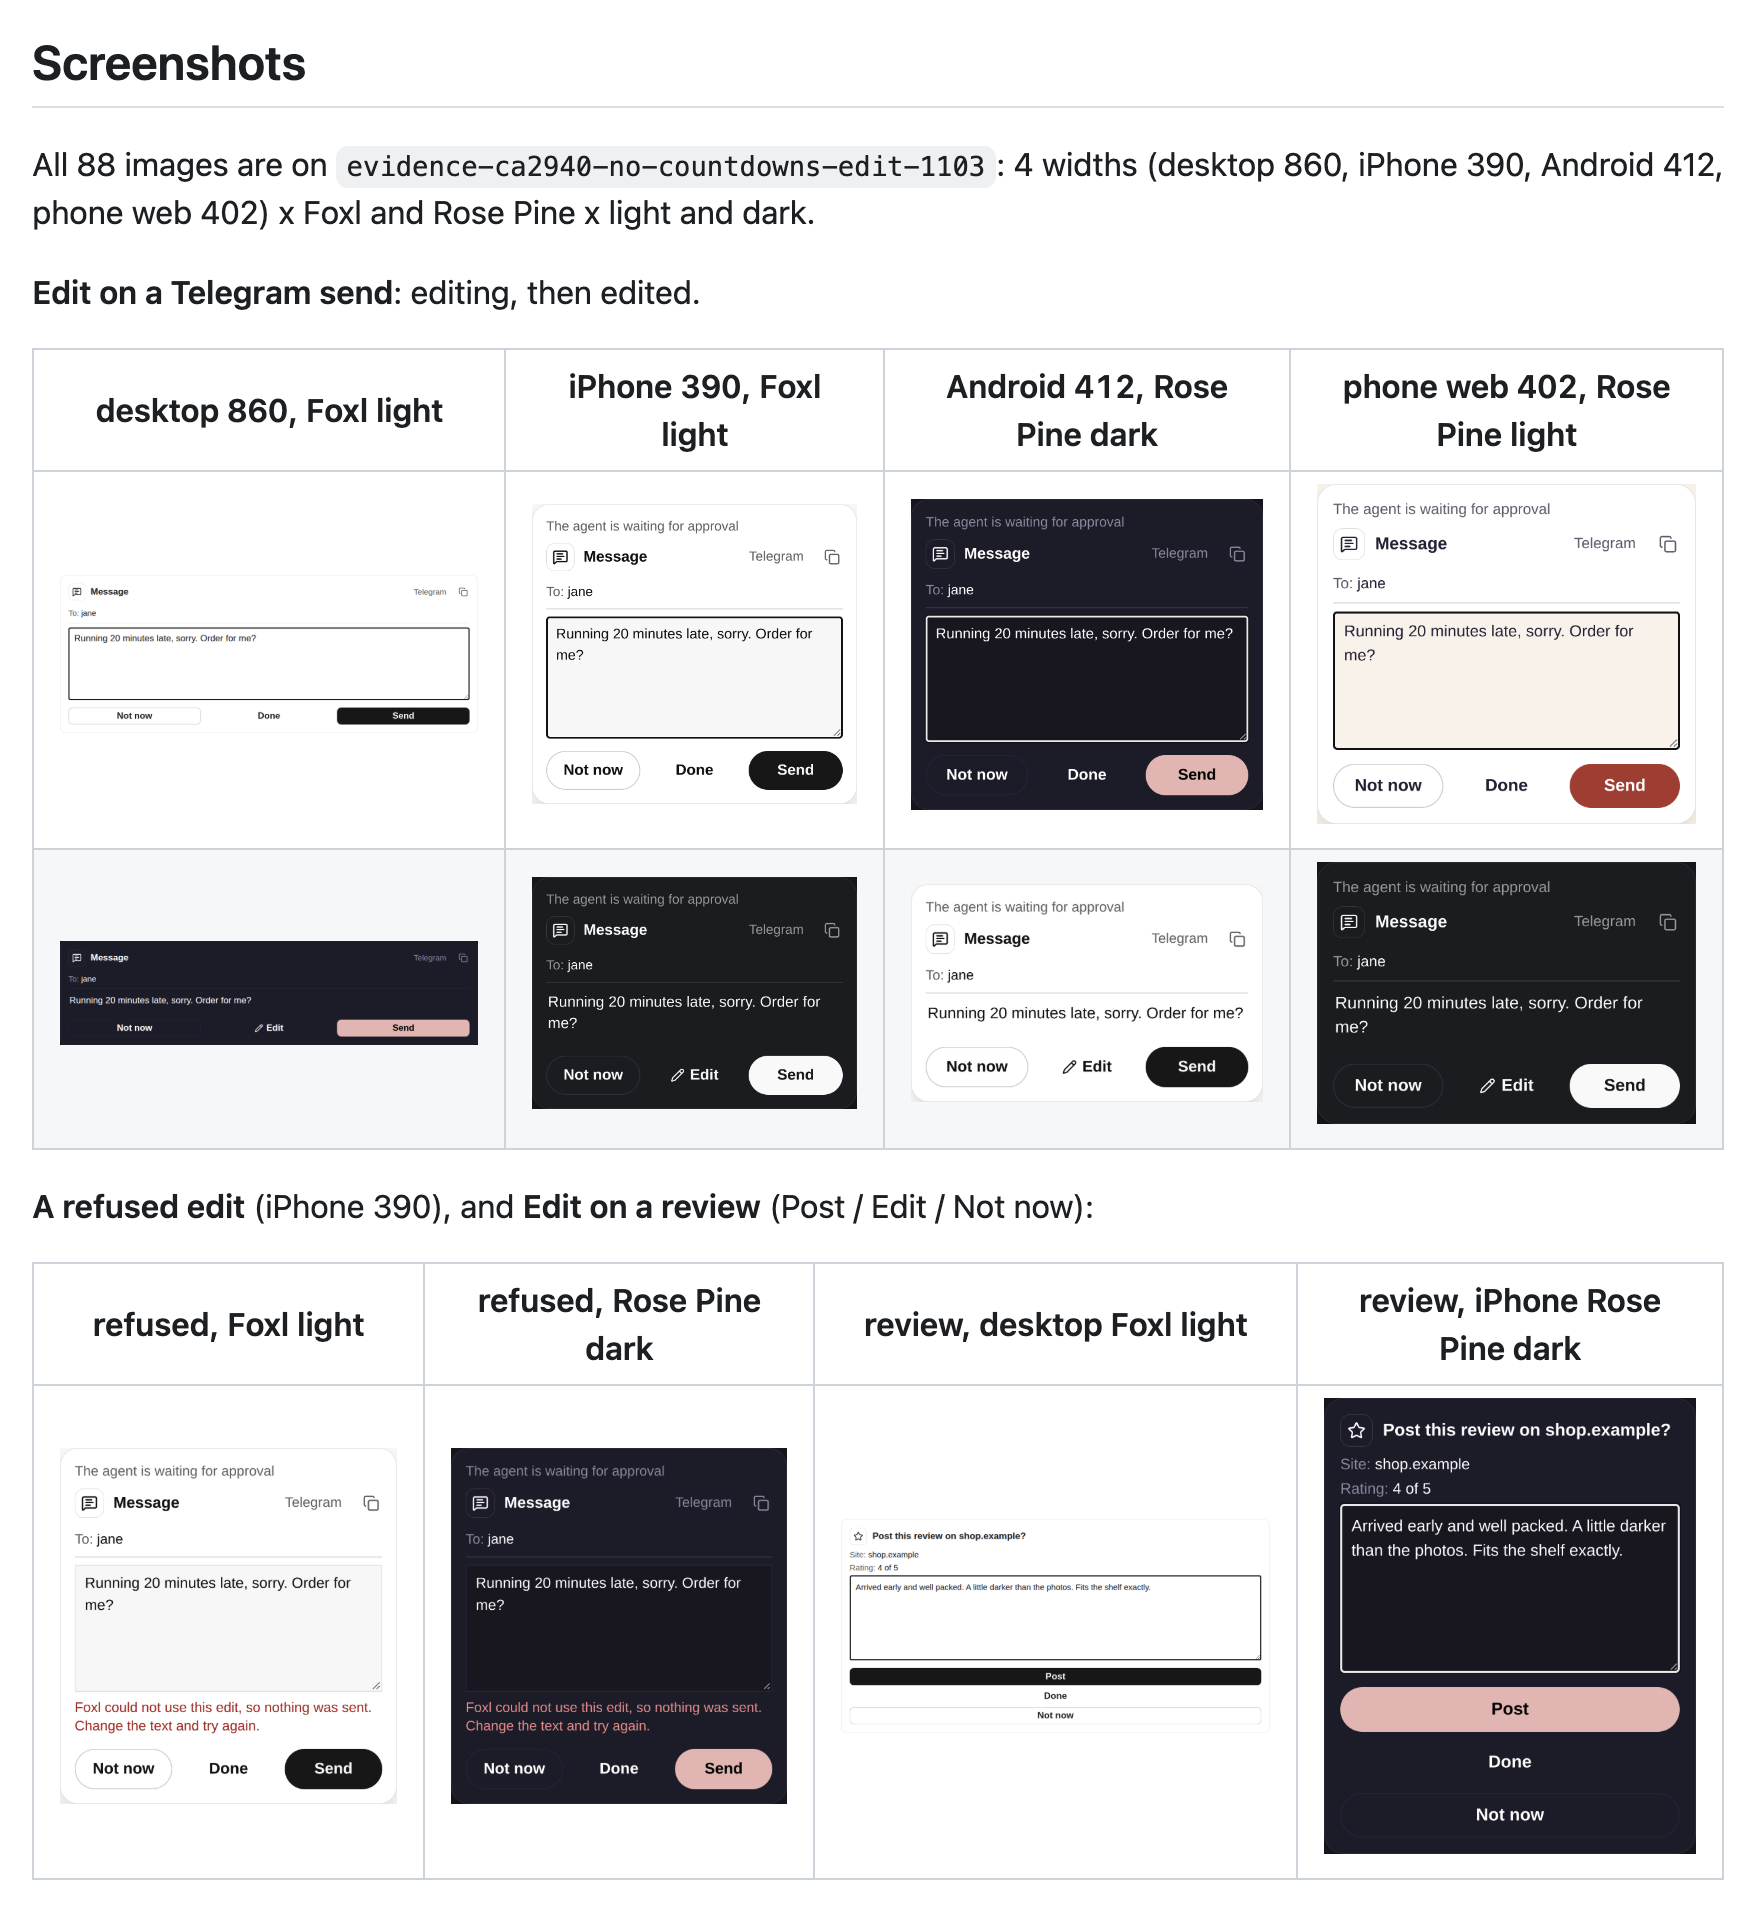
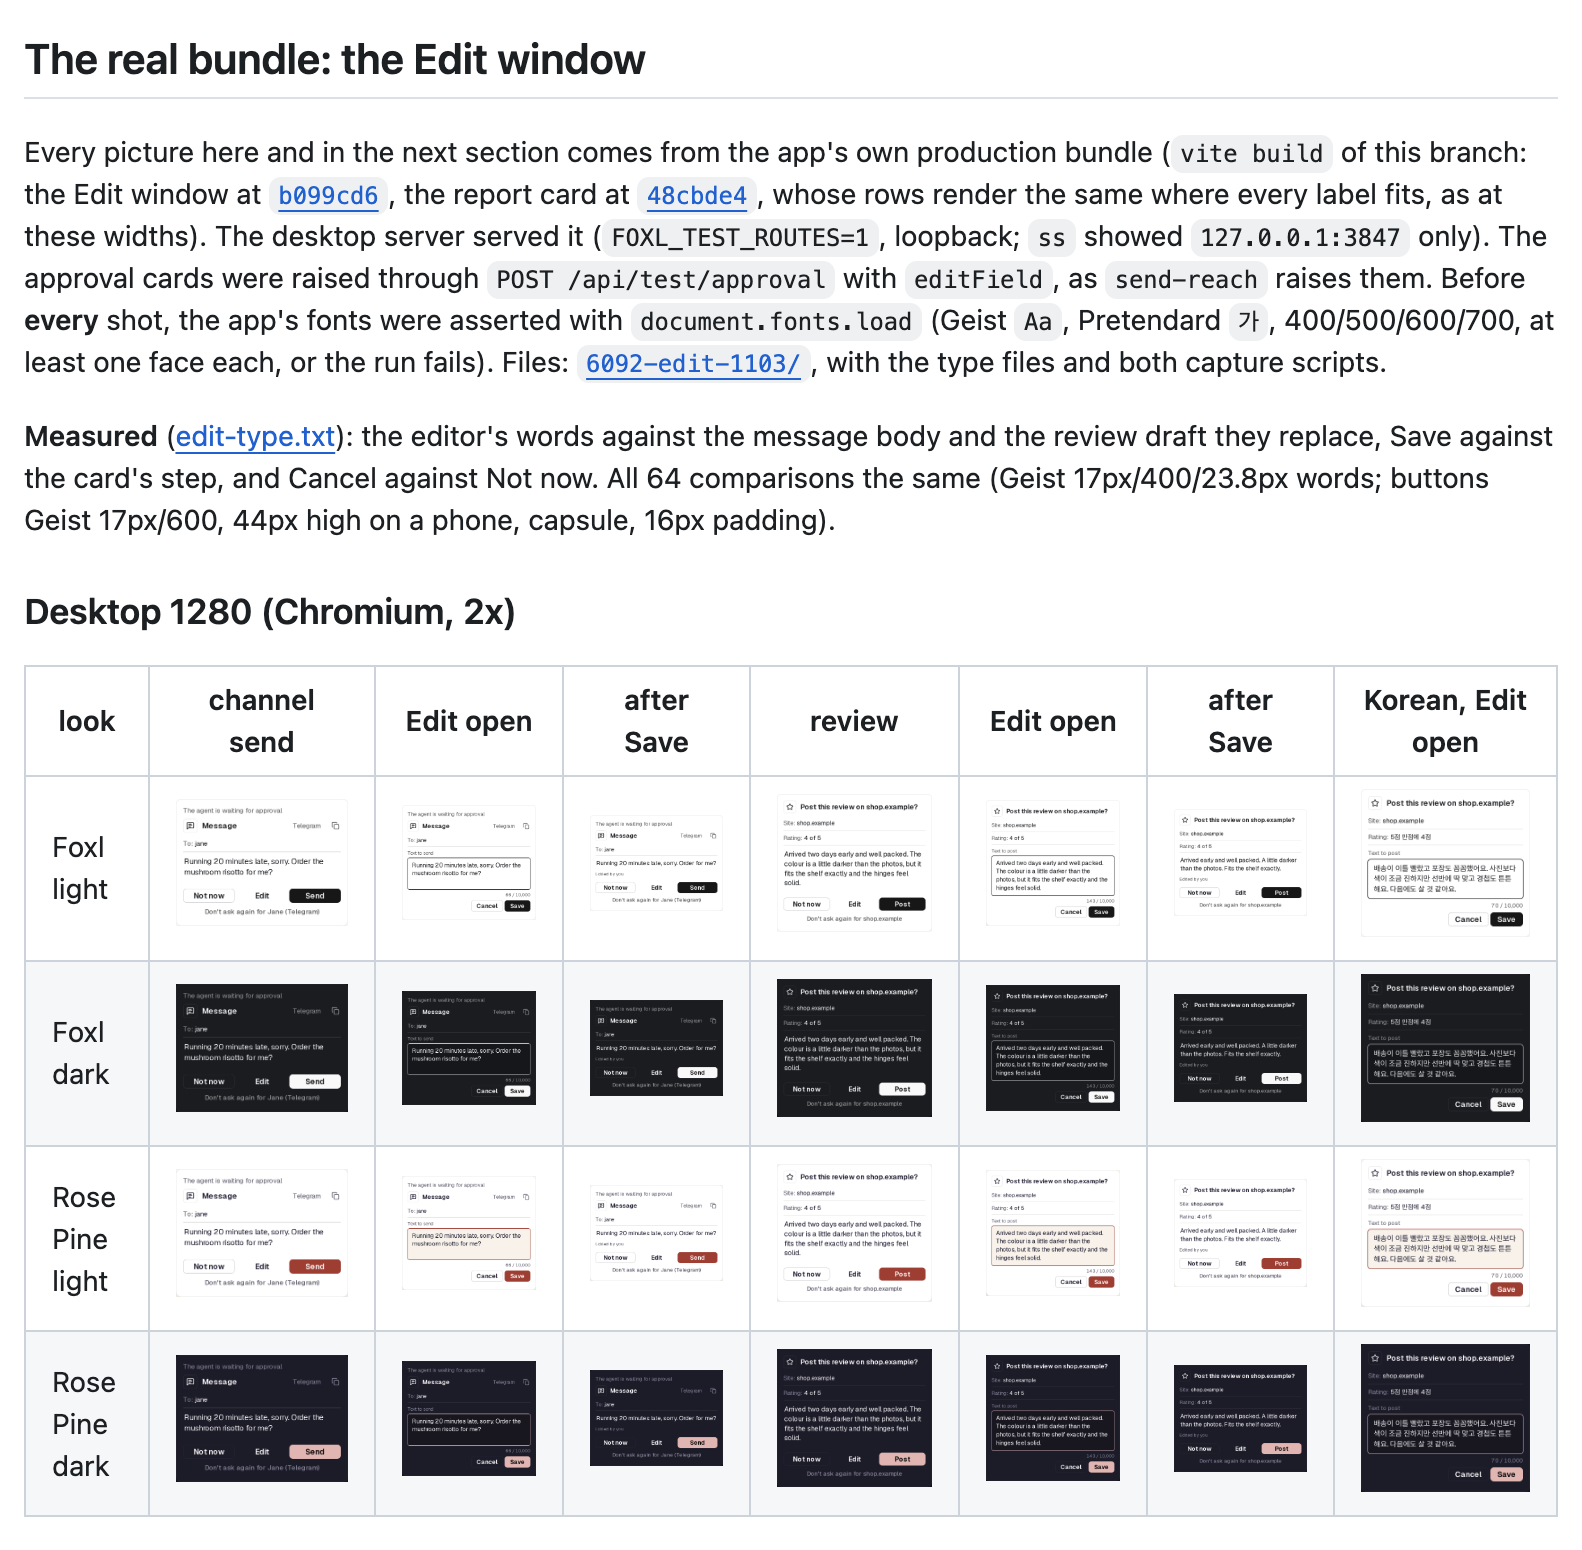
11월 3일 아침이 그 한 예입니다. UTC 04:59에 리뷰를 올리는 카드의 새 편집 창을 담은 스크린샷 20장과 함께 풀 리퀘스트가 올라왔습니다. 글자는 다른 폰트로 그려져 있었고, 입력란은 브라우저 기본 상자였으며, 버튼 세 개가 카드를 따라 아래로 쌓여 있었습니다. 05:04에 저희는 코디네이터에게 두 줄을 보냈습니다. 작성자에게 디자인 시스템에 맞춰 창을 다시 디자인하게 하고, 풀 리퀘스트를 draft로 돌렸다가 다시 올리라는 내용이었습니다. 12초 뒤 draft가 됐습니다. 09:30에는 앱의 초안 편집기 위에서 다시 올라왔고, 스크린샷 296장은 모두 앱 폰트가 로드된 뒤에 찍혔습니다. 11:50에 머지됐습니다. 다른 폰트는 풀 리퀘스트 탓이 아니었습니다. 스크린샷 하네스가 앱의 폰트를 내주지 않았고, 그날 그 이유를 확인하다가 앞에서 말한 하네스 34개를 찾았습니다.
무언가 잘못되면 그걸 잡았을 규칙을 날짜, 사고와 함께 해당 영역의 CLAUDE.md에 적고, 이어서 스크립트가 그 규칙을 강제할 수 있는 길목을 찾습니다. 되돌릴 수 있는 결정은 에이전트가 코드를 보고 내리고, 무엇을 결정했는지 기록으로 남깁니다. 되돌릴 수 없는 일과 돈이 걸린 일은 모두 사람을 기다립니다. 사람들이 Foxl과 비교하는 제품보다 Foxl을 불편하게 만드는 풀 리퀘스트는, 코드가 맞더라도 보류합니다.
아직 풀지 못한 문제
리뷰어는 에이전트지만 리뷰어가 적용하는 기준은 사람이 만든 것이고, 그 판정도 아직은 사람이 읽습니다. 지금은 이 읽는 단계가 풀 리퀘스트와 릴리스 사이에서 가장 느립니다. 그래서 사람 없이도 다른 에이전트가 확인할 수 있도록, 주장의 종류마다 기준을 쓰고 있습니다. 로직 수정이라면 수정 전에 실패하고 합친 트레인에서 통과하는 테스트, 벤더 API라면 실제 서비스에서 뜬 캡처, 사람이 보는 화면이라면 실제 폰트로 실제 빌드에서 찍은 스크린샷, 비용이라면 실제로 센 요청 수, 릴리스라면 목적지마다 물어본 답입니다. 되돌릴 수 없는 일과 돈이 걸린 일은 앞으로도 사람의 몫입니다.
그 기준이 언제 충분해지는지는 아직 모릅니다. 계획은 테스트를 평가하듯 리뷰어를 평가하는 것입니다. 리뷰어마다 CI가 놓친 결함을 몇 개 찾았는지, 사람이 그 판정을 몇 번 뒤집었는지를 셉니다. 어떤 종류의 주장에서 사람이 더는 리뷰어를 뒤집지 않게 되면, 그 기준에는 이제 사람이 필요 없다는 뜻일 겁니다. 아직은 두 숫자 모두 없습니다.