Was wir beim Bau einer KI-Softwarefabrik gelernt haben
Das Foxl-Team bringt jeden Monat Dutzende Releases aus einer KI-Softwarefabrik heraus, in der 15 bis 20 Coding-Agenten gleichzeitig arbeiten. Den Code zu schreiben war der leichte Teil; zu wissen, ob er stimmt, war viel schwerer. Das haben wir beim Bau der Prüfungen gelernt.
Auf dieser Seite
Das Foxl-Team bringt jeden Monat Dutzende Releases heraus. Im Oktober waren es 66, davon 22 stabile und 44 Betas. Jedes Release enthält die Desktop-App für Windows, macOS und Linux, und jedes stabile Release enthält dazu die Apps für iOS und Android und die Web-App. Jedes Mal muss geprüft werden, dass all das funktioniert.
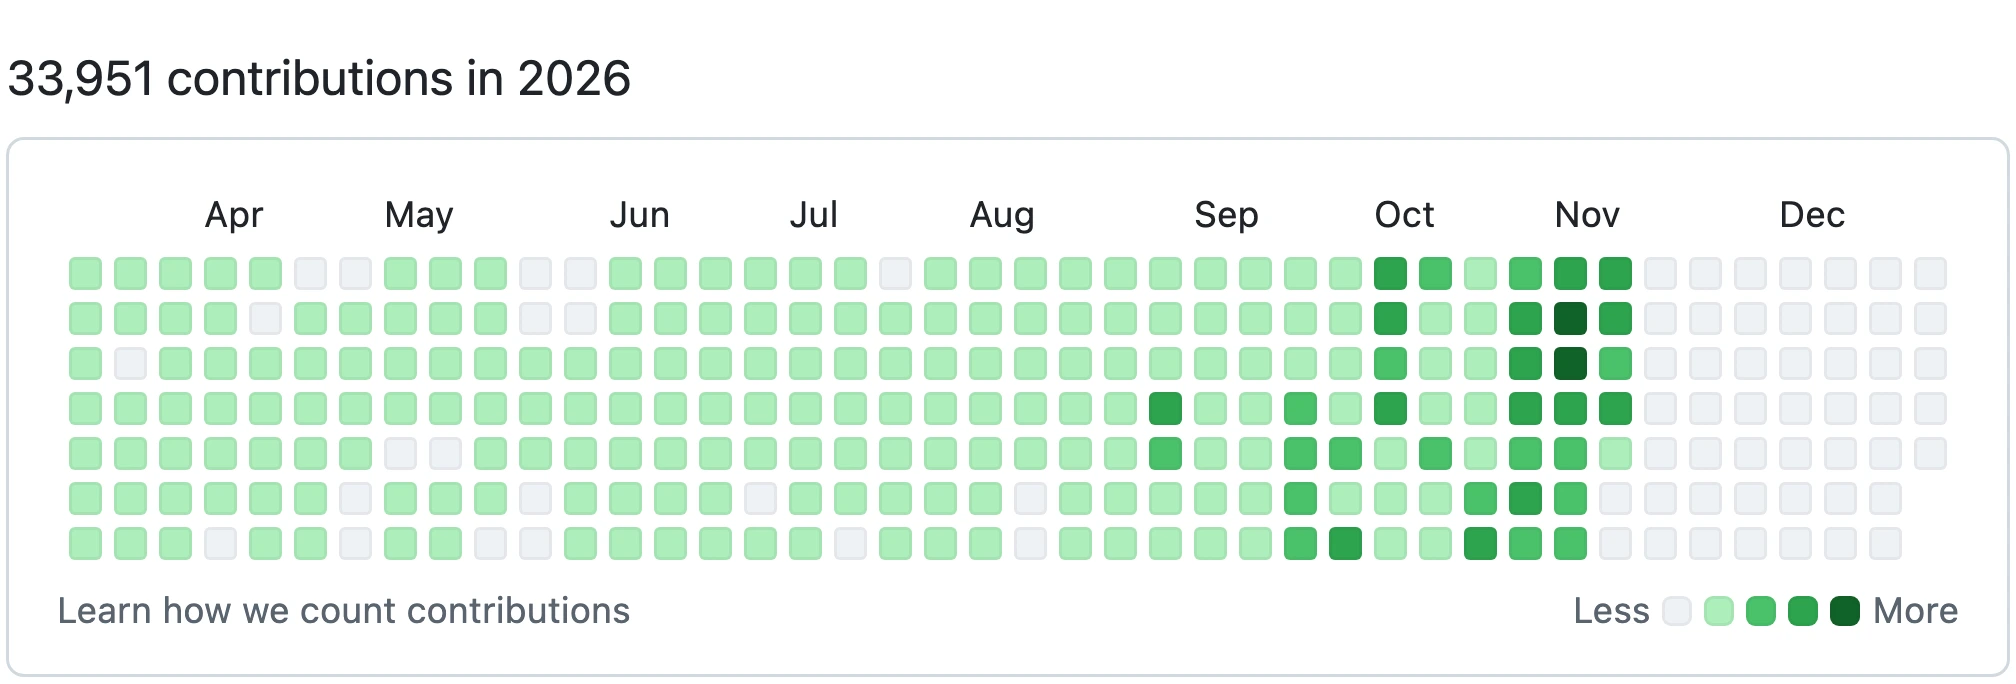
Im selben Monat wurden in unserem Repository 2.140 Pull Requests geöffnet und 2.040 gemergt, also knapp 70 neue am Tag. Den größten Teil dieses Codes haben Coding-Agenten geschrieben, nicht Menschen: 15 bis 20 Claude-Code-Sessions, die gleichzeitig auf einem Mac laufen, jede auf ihrem eigenen Branch. Der Beitragsgraph des GitHub-Kontos, unter dem diese Sessions committen, zeigt die Veränderung auf einen Blick. In den beiden Jahren davor zählte er jeweils ein paar Hundert Beiträge. In diesem Jahr liegt er über 30.000.
Eine Entwicklung, bei der Agenten die Arbeit planen, den Code schreiben, ihn testen und reviewen, nennt man inzwischen eine KI-Softwarefabrik. Menschen entscheiden, was gebaut wird, und haben das letzte Wort darüber, was ausgeliefert wird. Unsere läuft genau so. Aber als wir im März den Code an Agenten übergaben, zeigte sich, dass das Schwierige nicht das Schreiben war. Schwierig war zu wissen, ob der Code, den die Agenten geschrieben hatten, wirklich stimmte und ob er auf allen fünf Plattformen hielt.
Dieser Beitrag beschreibt, was wir beim Bau der Prüfungen dafür gelernt haben. Die Kurzfassung: Jede Regel, die wir für die Agenten nur aufgeschrieben hatten, wurde gebrochen. Die meisten hielten ein paar Tage. Was gehalten hat, waren Prüfungen genau auf dem Weg, auf dem ein Fehler hereingekommen war, und der nächste Fehler kam fast immer über einen Weg, auf dem noch keine Prüfung stand.
Von einer Session zu zwanzig
In den ersten vier Monaten hatten wir den ganzen Tag eine Session offen, und ein Mensch las jeden Diff, sobald er kam. Fast alles ging direkt auf main; aus dem ganzen Juni hat das Repository genau einen Pull Request. Die Grenze war menschliche Aufmerksamkeit. Mehr als eine Session konnte man kaum richtig verfolgen.
Im Juli richteten wir Foxl Code, unseren Coding-Agenten in der Cloud, auf Foxls eigenes Repository. Jede Aufgabe bekam eine eigene Cloud-VM, und am 22. Juli brachte dieses Setup fünf Produktions-Releases an einem Tag heraus. Diese VMs haben allerdings kein macOS, sodass alles, was Xcode oder den iPhone-Simulator brauchte, weiterhin auf den Mac zurück musste.
Im August änderten wir die Arbeitsweise: ein git worktree für jede Session und ein Pull Request für jede Änderung. Die Sessions überschrieben sich nicht mehr gegenseitig ihre Arbeit, also konnten mehrere gleichzeitig laufen, und die Zahl der Pull Requests stieg von 598 im August auf 946 im September und 2.140 im Oktober.
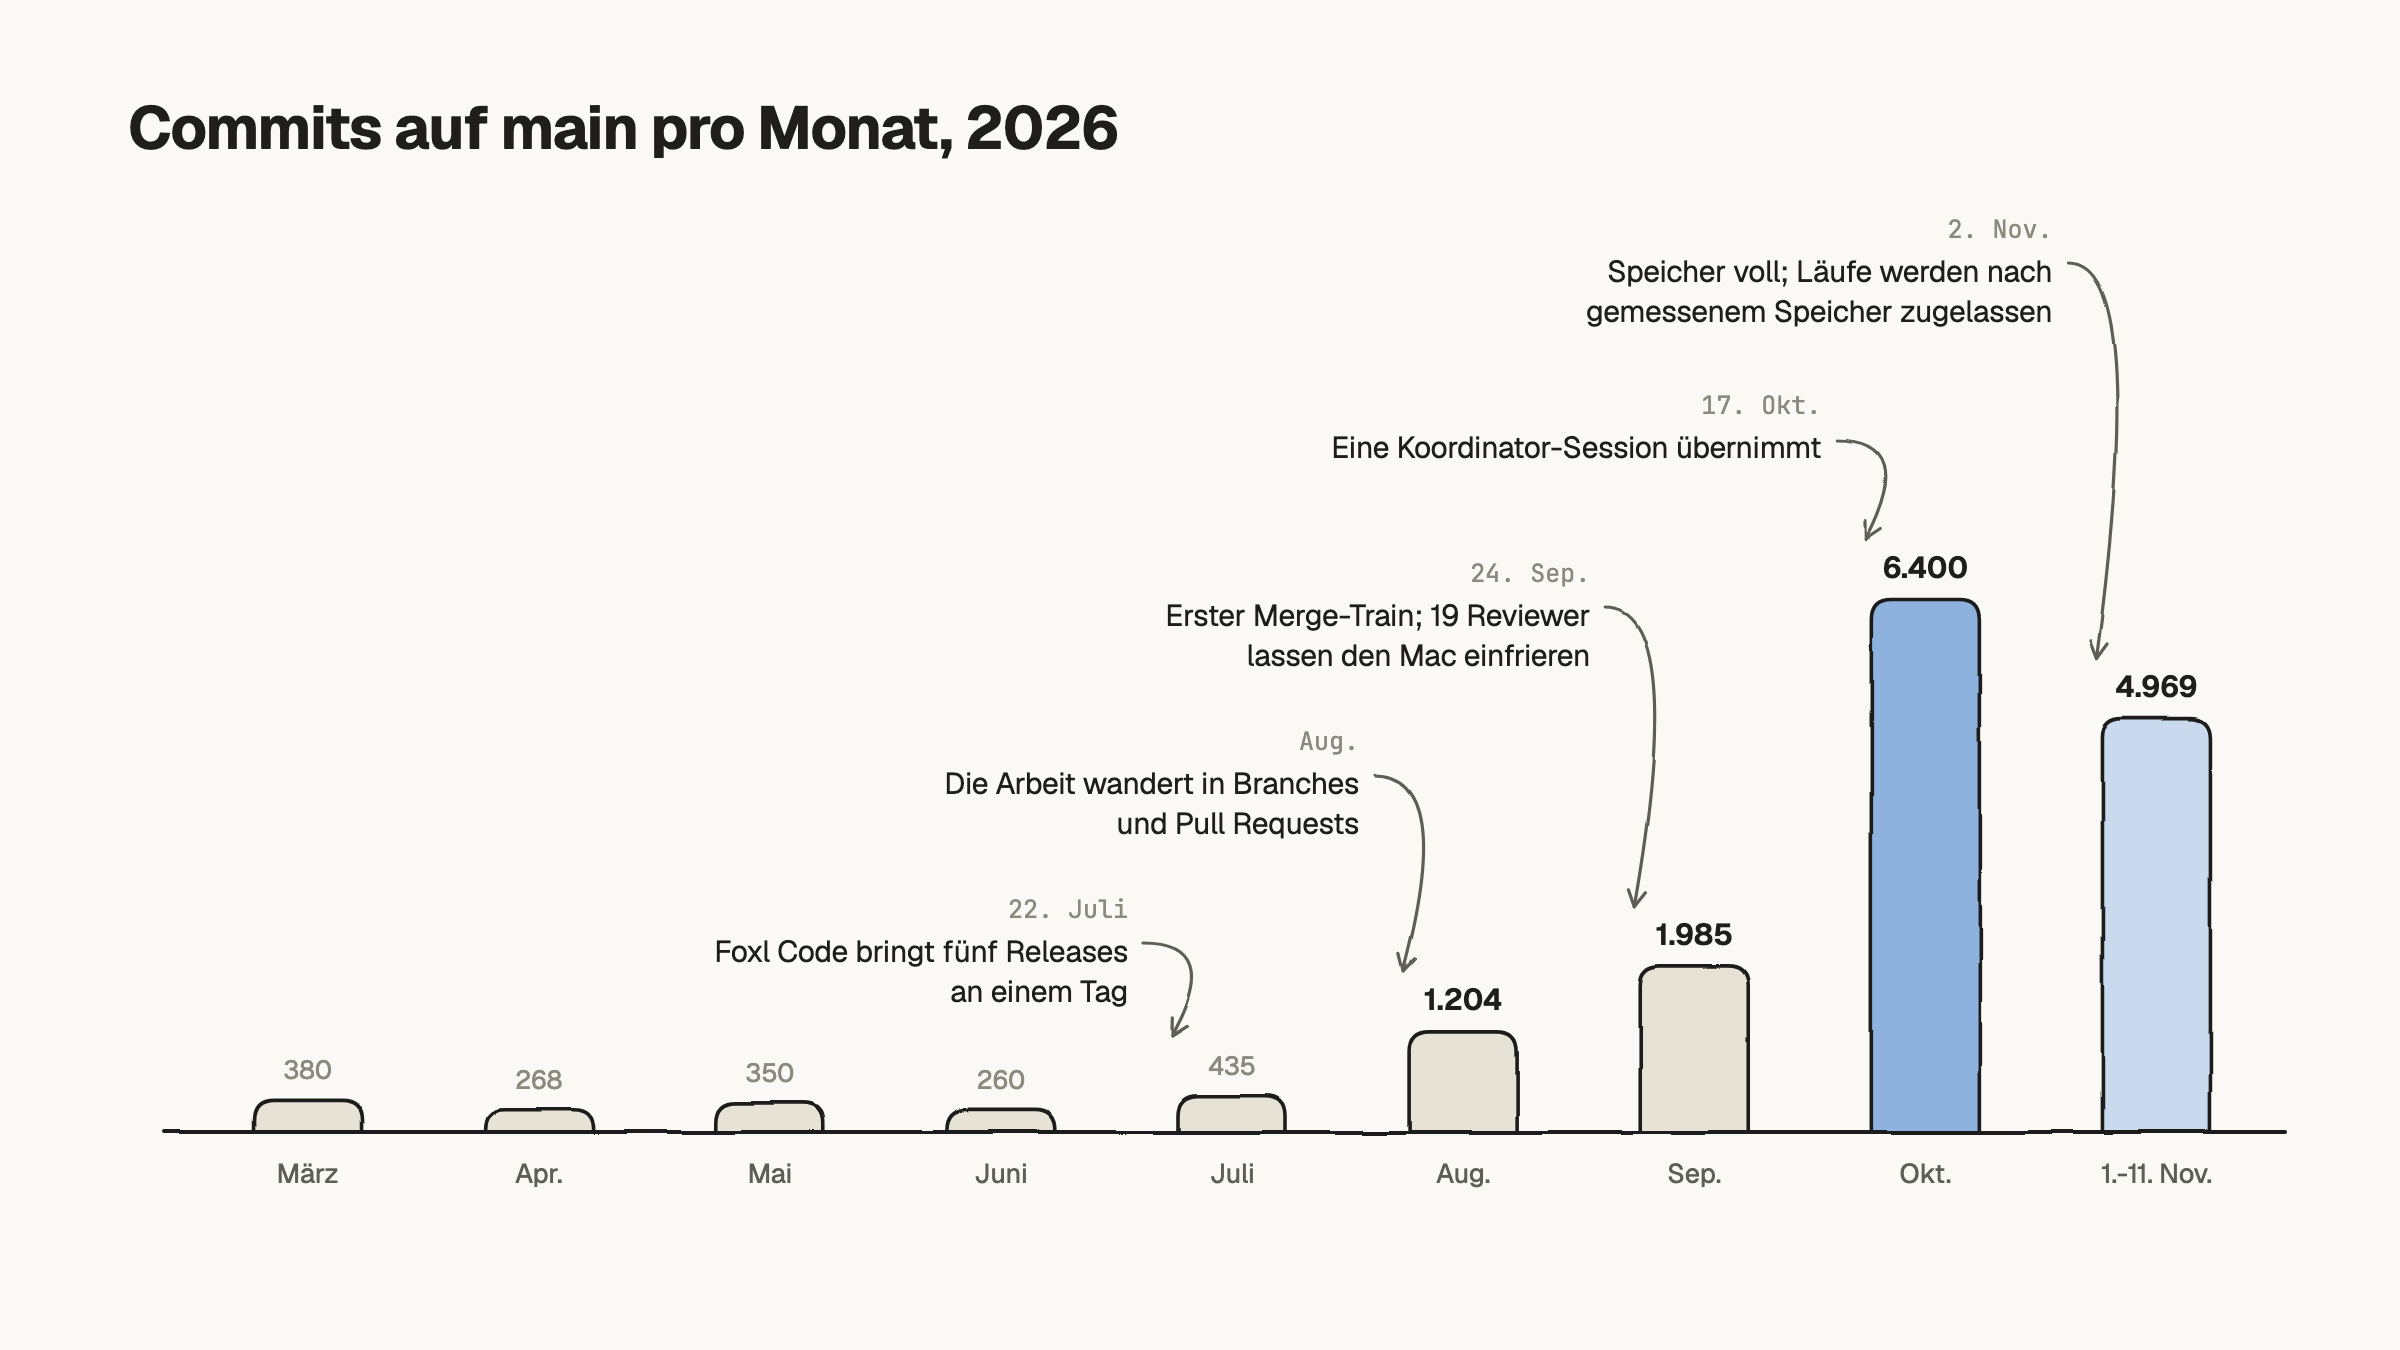
Mit den Zahlen kamen neue Probleme. Sessions bearbeiteten gleichzeitig dieselben Dateien, und dem Mac ging der Speicher aus. Vor allem zeigte der erste Merge-Train am 24. September, dass ein grüner CI-Lauf nicht heißt, dass ein Pull Request stimmt. Mehr dazu weiter unten.
Wo wir prüfen können, entscheidet, wo wir arbeiten
Fünf Plattformen zu prüfen, setzt Maschinen voraus, die sie ausführen können. Wir nutzen drei Arten, und jede kann anderes prüfen.
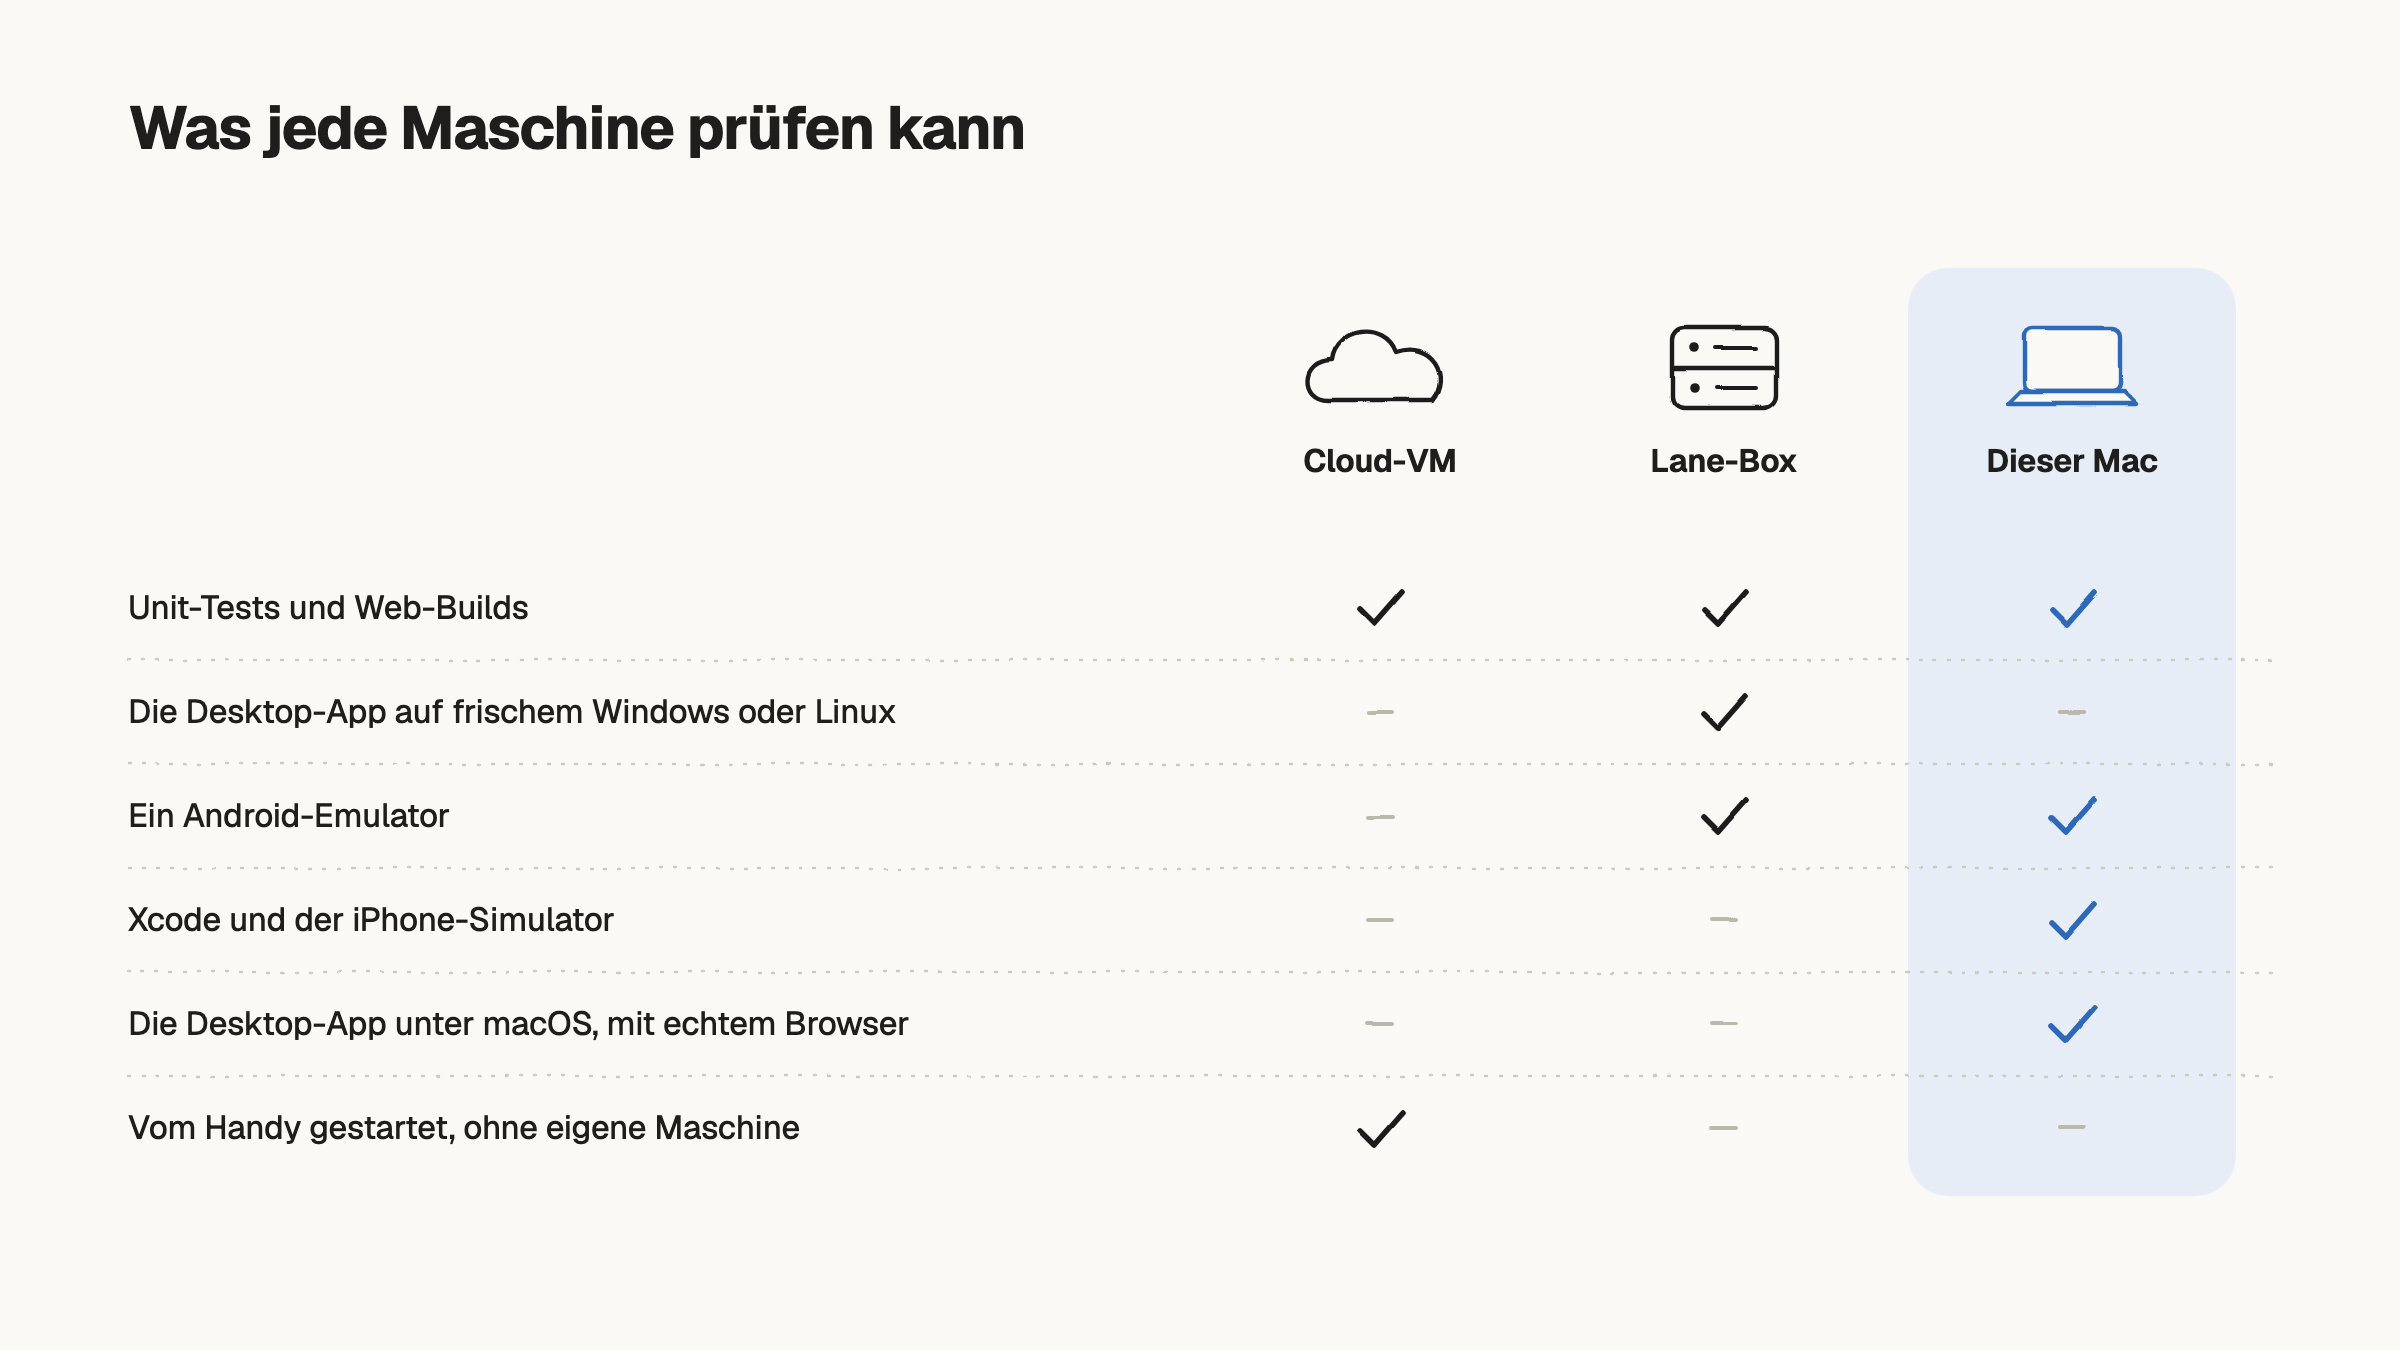
Cloud-VMs eignen sich für isolierte Linux-Arbeit und lassen sich direkt vom Handy aus starten. Braucht eine Session die Desktop-App auf einem frisch installierten Windows oder Linux oder einen Android-Emulator, bekommt sie eine EC2-Wegwerfinstanz, die wir Lane-Box nennen. Und alles Übrige kann nur der Mac prüfen: Xcode, den iPhone-Simulator, ein echtes Chrome und die Desktop-App unter macOS.
So landeten die meisten Sessions auf einem einzigen Mac. Er ist zugleich ein Computer, den wir jeden Tag benutzen: Alle Sessions teilen sich den Speicher einer Maschine und arbeiten direkt neben echten Daten.
Agenten zu starten ist der gelöste Teil
Werkzeuge, um viele Agenten gleichzeitig laufen zu lassen, gibt es reichlich. Jedes, das wir uns angesehen haben, macht parallele Läufe leicht, und manche lassen die Agenten miteinander reden. Sie unterscheiden sich darin, wo die Agenten laufen und wie viel vom Prüfen ihrer Ergebnisse sie übernehmen.
Claude Code und Codex
Diese beiden sind die Agenten selbst. Claude Code führt Hintergrund-Sessions aus, die weiterlaufen, wenn das Terminal geschlossen wird, jede in ihrem eigenen Worktree (claude --bg --worktree), und Sessions können einander Nachrichten schicken oder Subagenten starten. Es gibt auch Cloud-Sessions, die im Web oder auf dem Handy gestartet werden. Codex gibt es als CLI, als Desktop-App und als IDE-Erweiterungen, und Codex Web führt Aufgaben in Linux-Containern in OpenAIs Cloud aus.
Orca
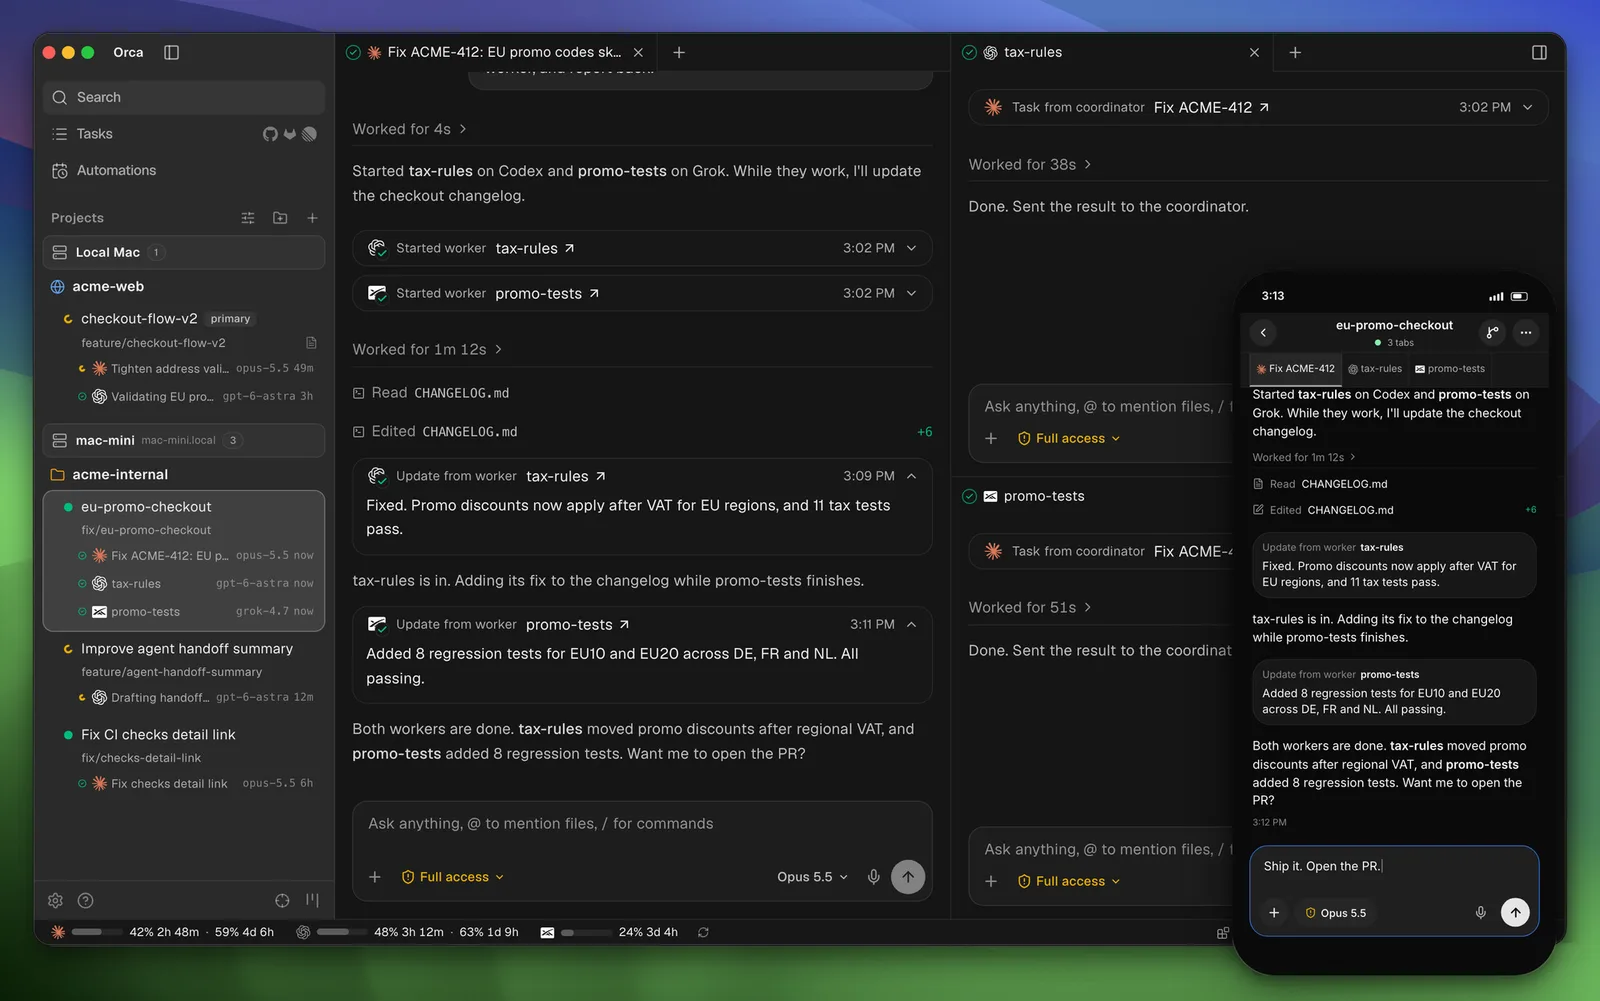
Orca ist eine Desktop-App für macOS, Windows und Linux. Sie führt CLI-Agenten wie Claude Code oder Codex parallel aus, jeden in seinem eigenen Worktree, und wenn du ihr eine große Aufgabe gibst, teilt ein Koordinator-Agent die Arbeit auf Worker auf und bringt ihre Ergebnisse zurück, genau die Szene im Screenshot oben. Agenten können auch auf einem SSH-Host oder auf einer Cloud-VM pro Worktree laufen, und fehlgeschlagene Checks und Review-Kommentare gehen zum Beheben an den Agenten zurück.
herdr
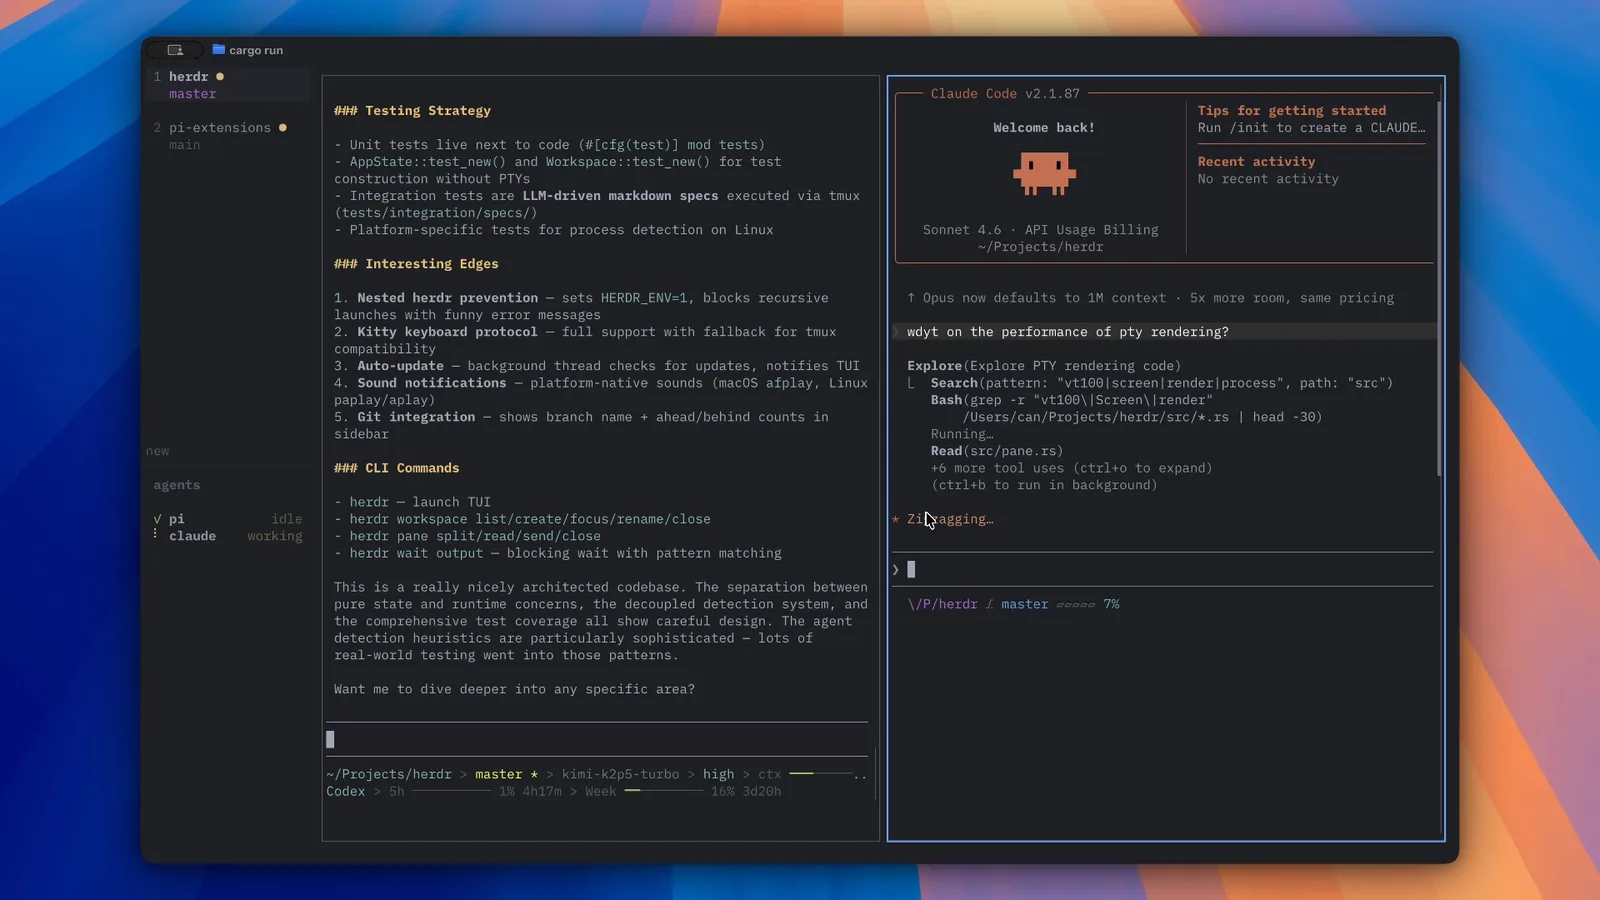
herdr ist eine Terminal-Runtime in einem einzelnen Rust-Binary. Es übernimmt die Terminals, statt die Agenten zu kapseln, und funktioniert deshalb mit Claude Code, Codex oder OpenCode gleich. Die Terminals laufen im Hintergrund weiter, wenn eine SSH-Verbindung abbricht, jedes Pane zeigt, ob sein Agent working, blocked oder idle ist, und Agenten können einander über seine CLI und seine Socket-API Prompts schicken.
Kiro Crew
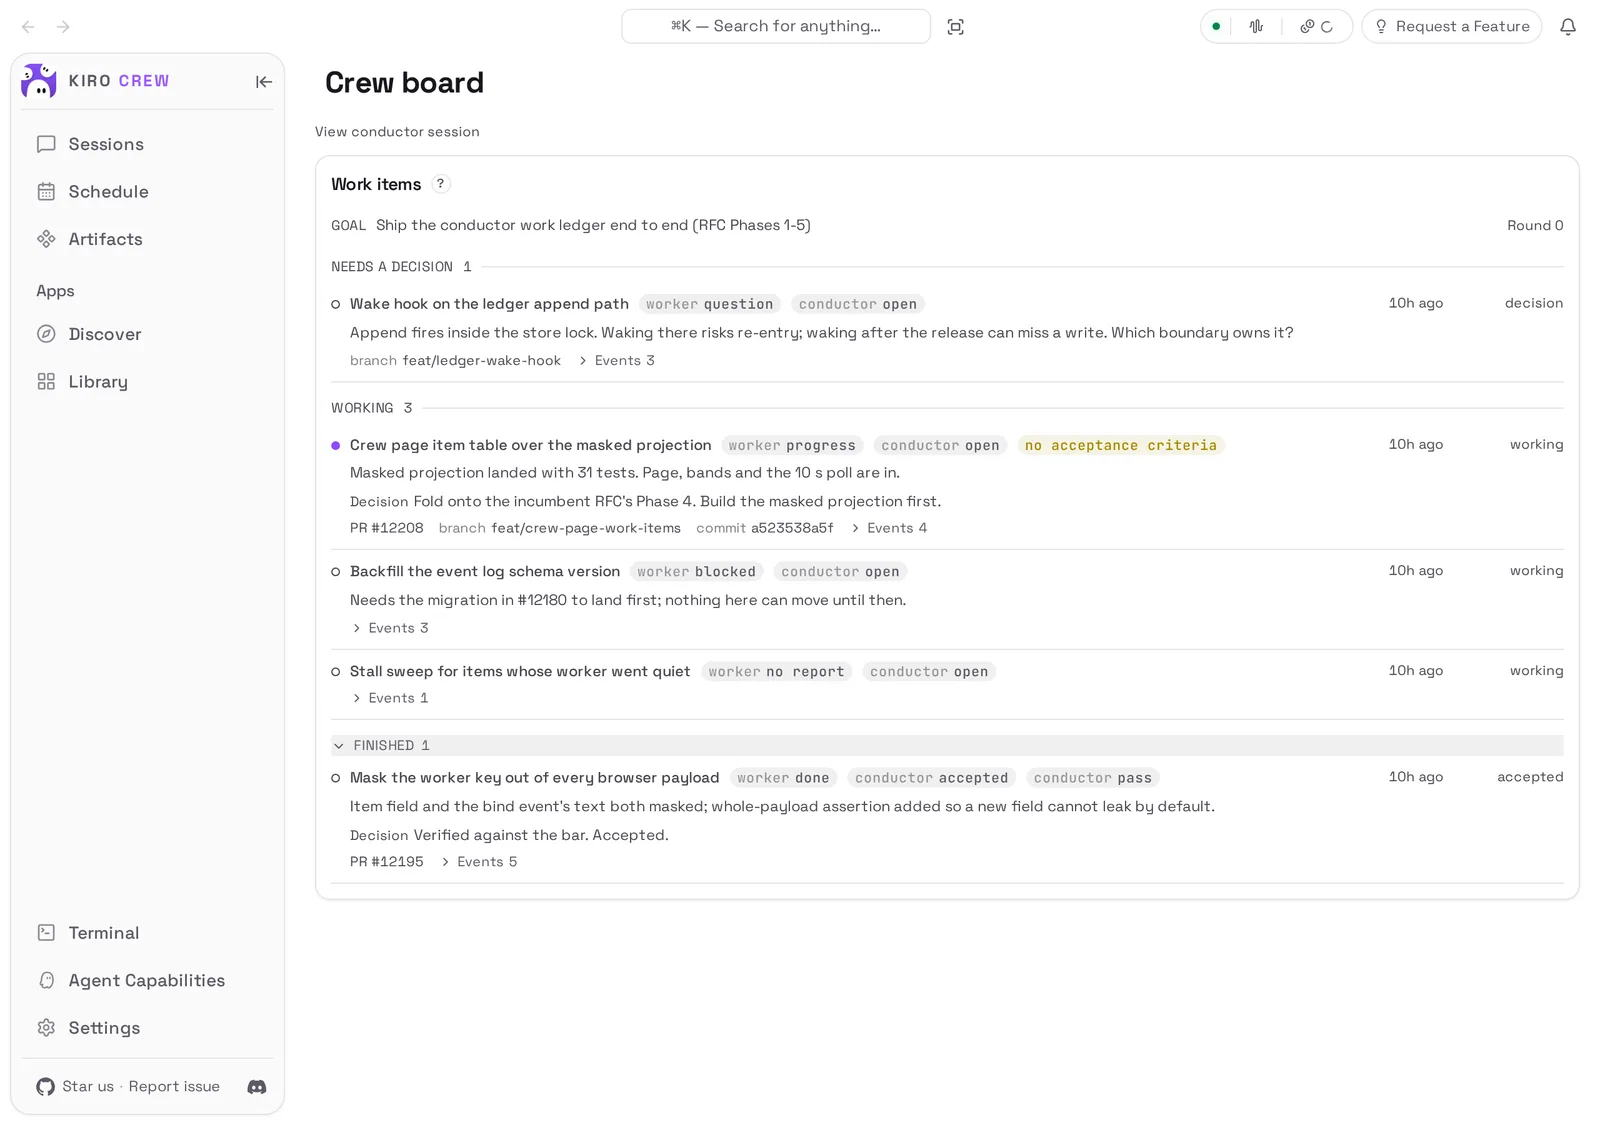
Kiro Crew ist ein Arbeitsbereich, der auf deiner eigenen Hardware läuft, einem Mac, einem Container oder einer entfernten Maschine, und zwischen Gesprächen weiterarbeitet. Sessions, Gedächtnis und Checkpoints von Aufgaben überstehen Neustarts, und Korrekturen sammeln sich zu Lektionen, die ändern, was es als Nächstes tut. Sein Crew Board, oben zu sehen, zeigt jedes Paket, das der Conductor verteilt hat, neben dem Bericht des Workers und ob der Conductor das Ergebnis gemessen an der Latte angenommen hat.
Foxl Code
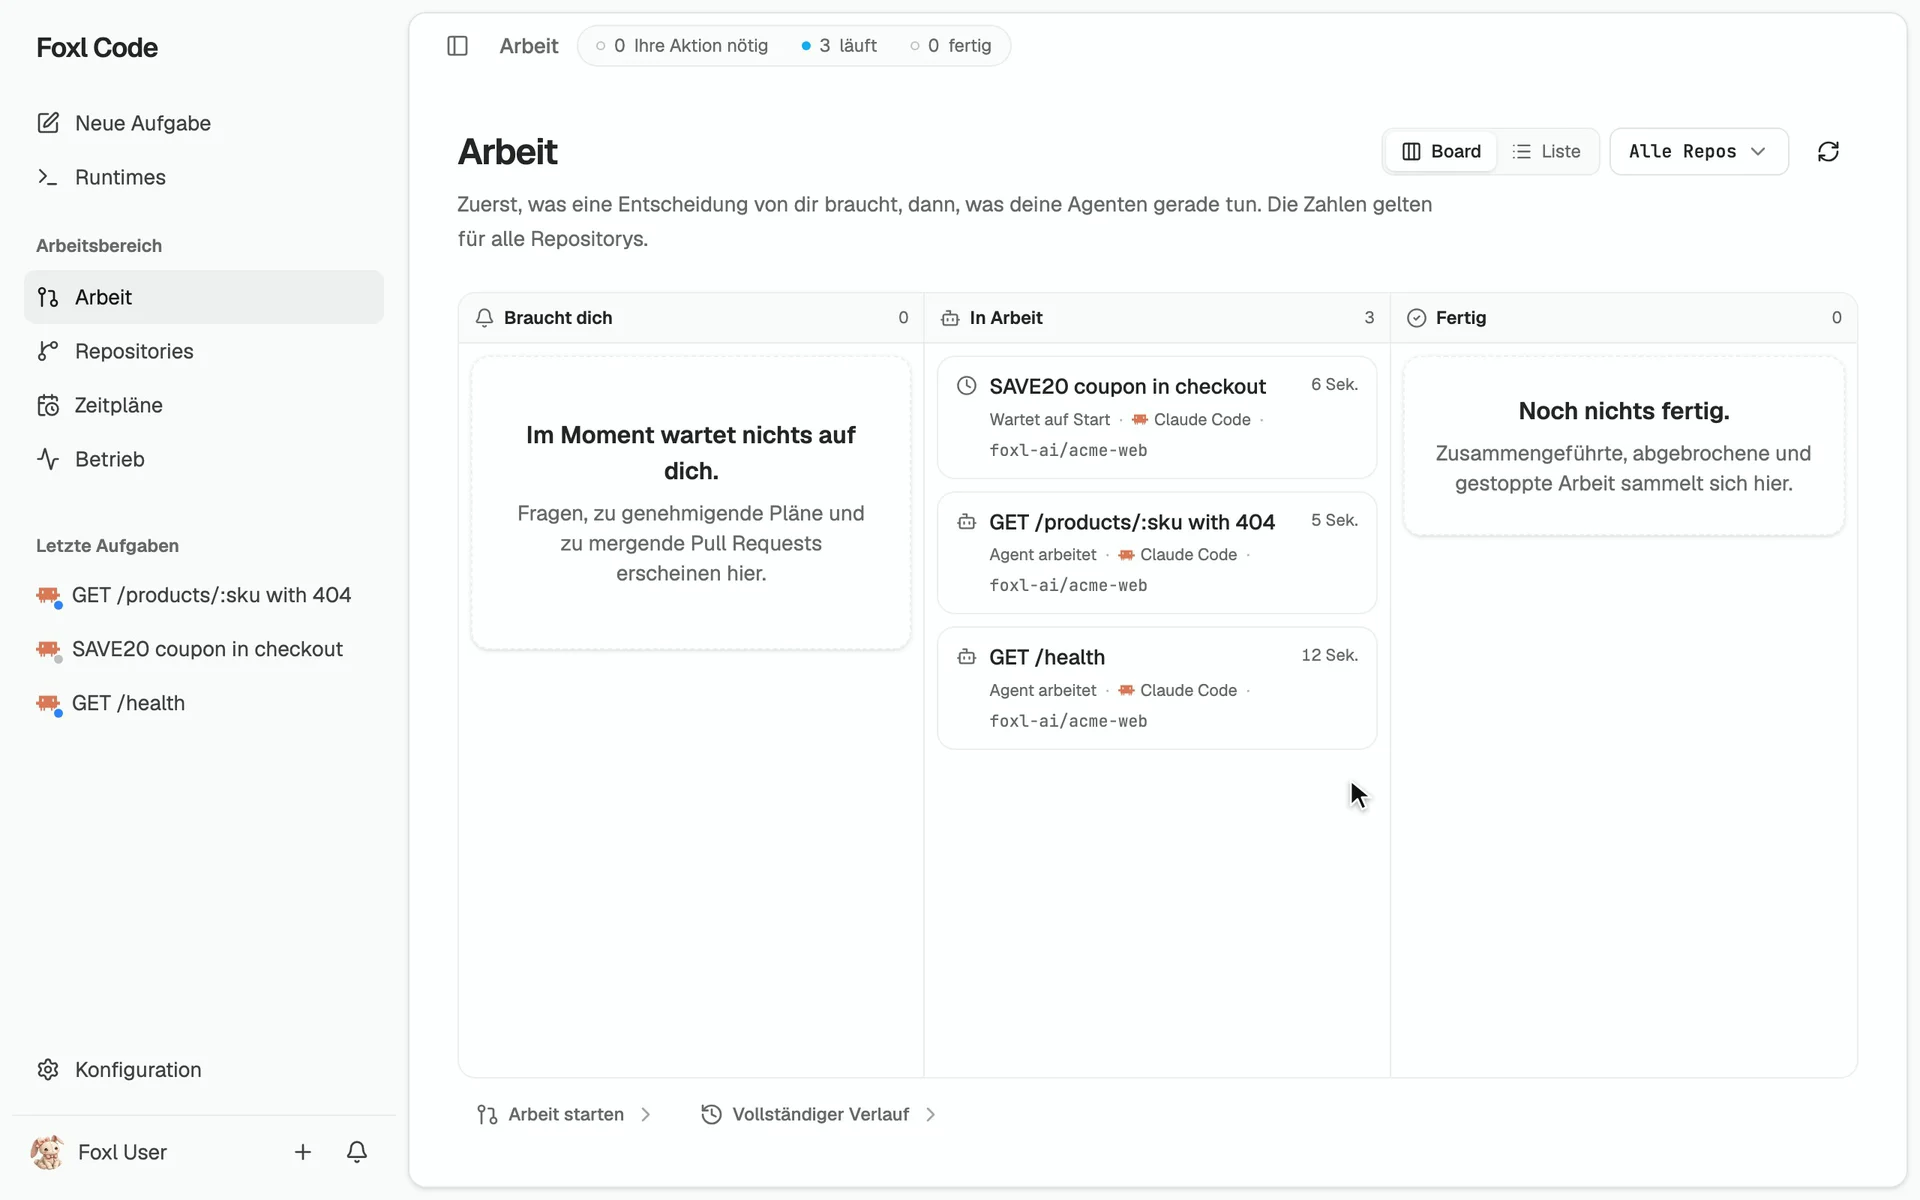
Foxl Code ist das Cloud-Produkt, das wir weiter oben erwähnt haben, als private Beta für eingeladene Konten. Du beschreibst eine Aufgabe im Browser oder auf dem Handy, und ein Agent wie Claude Code arbeitet in einer eigenen VM daran. Eine größere Anfrage wird in unabhängige Teilaufgaben aufgeteilt, die gleichzeitig starten, je ein Pull Request; das Board oben zeigt eine Anfrage wenige Sekunden, nachdem sie sich in drei aufgeteilt hat. Der Reviewer liest die MERGE-REVIEW.md des Repositorys vom Default-Branch, nie aus dem Pull Request, sodass eine Änderung die Latte, an der sie gemessen wird, nicht umschreiben kann. Jeder Pull Request wird trotzdem für sich geprüft: Um mehrere zusammengeführt zu testen, bittet man im Chat um einen Merge-Train.
Nebeneinander:
| Werkzeug | Wo die Agenten laufen | Stärken | Grenzen |
|---|---|---|---|
| Claude Code | Deine Maschine oder eine Cloud-Session, gestartet im Web oder auf dem Handy | Hintergrund-Sessions in eigenen Worktrees, die einander auflisten und anschreiben; Subagenten | Seine Nachrichten erreichen nur Claude-Code-Sessions |
| Codex | Deine Maschine oder OpenAIs Cloud | Ein Agent in CLI, Desktop-App, IDEs und Cloud | Cloud-Aufgaben laufen in einem Linux-Container, Xcode-Arbeit bleibt also lokal |
| Orca | Deine Maschine, ein SSH-Host oder eine Cloud-VM pro Worktree | Jeder CLI-Agent; ein Koordinator, der eine Aufgabe auf Worker verteilt; eine Handy-App; fehlgeschlagene Checks gehen an den Agenten zurück | Nichts in seiner Beschreibung testet mehrere zusammengeführte Pull Requests |
| herdr | Deine Maschine und SSH-Hosts | Liegt unter jedem Agenten: Terminals, die das Trennen überstehen, working, blocked oder idle pro Pane, Agenten, die einander Prompts schicken | Übernimmt die Terminals, nicht die Arbeit: bringt keinen eigenen Review- oder Merge-Schritt mit |
| Kiro Crew | Dein Mac, ein Container oder eine entfernte Maschine | Sessions, Gedächtnis und Checkpoints, die Neustarts überstehen; Lektionen aus Korrekturen; ein Conductor, der Arbeit gemessen an einer Latte annimmt | Noch keine Kanäle zwischen Workern |
| Foxl Code | Eine VM pro Aufgabe, in Foxls Cloud | Start vom Handy; parallele Teilaufgaben, je ein Pull Request; ein Reviewer, der an die Merge-Latte des Repositorys gebunden ist | Private Beta; kein macOS; Pull Requests werden nur in einem angeforderten Merge-Train zusammen getestet |
Wir haben unsere Fabrik auf den eigenen Sessions von Claude Code aufgebaut. Sie ist aus einer einzigen Claude-Code-Session gewachsen, und die Sessions auf diesem Mac konnten einander schon auflisten und anschreiben, direkt neben Xcode und den Simulatoren.
Zwei Dinge bleiben gleich, egal welches Werkzeug die Agenten ausführt. Agenten auf einer Maschine müssen sich deren Speicher teilen, und jemand muss entscheiden, ob stimmt, was sie getan haben. Um diese beiden Dinge geht es im Rest dieses Beitrags.
Zwanzig Sessions, der Speicher eines Macs
Am Nachmittag des 17. Oktober waren neunzehn Sessions offen. Ein Web-Build braucht etwa 3,5 GB Speicher, und innerhalb von zehn Minuten verlangten vier Sessions einen. Zwei führten TypeScript-Prüfungen aus, und eine startete ungefragt einen iPhone-Simulator. Acht Sessions hatten offene Änderungen in derselben CSS-Datei. An diesem Nachmittag sagten wir den Sessions, sie sollten weniger Speicher verbrauchen, warten, bis sie dran sind, und fragen, bevor sie ihn nutzen.
Am selben Tag wurde eine Session zum Koordinator. Jede andere Session liest beim Start eine gemeinsame Datei, in der steht, wer welche Dateien besitzt, schickt dem Koordinator eine Zeile mit ihrer Aufgabe und den Dateien, die sie anfassen will, und bekommt einen Bereich zurück. Braucht eine Session eine Datei, die einer anderen gehört, schickt sie dieser Session die Änderung zum Einspielen. Vor allem, was viel Speicher braucht, etwa einem Build, einer Testsuite oder einem Simulator, schickt sie HEAVY? mit ihrer Schätzung von Speicher und Minuten und wartet auf GO. Der Koordinator liest vor jeder Freigabe den Speicherdruck des Macs.
Unten ist die Warteschlange, in der der erste Build dieses Beitrags wartete. Ein Modell-Benchmark und Simulatorläufe standen schon an, und der Build startete erst nach 50 Minuten Wartezeit.
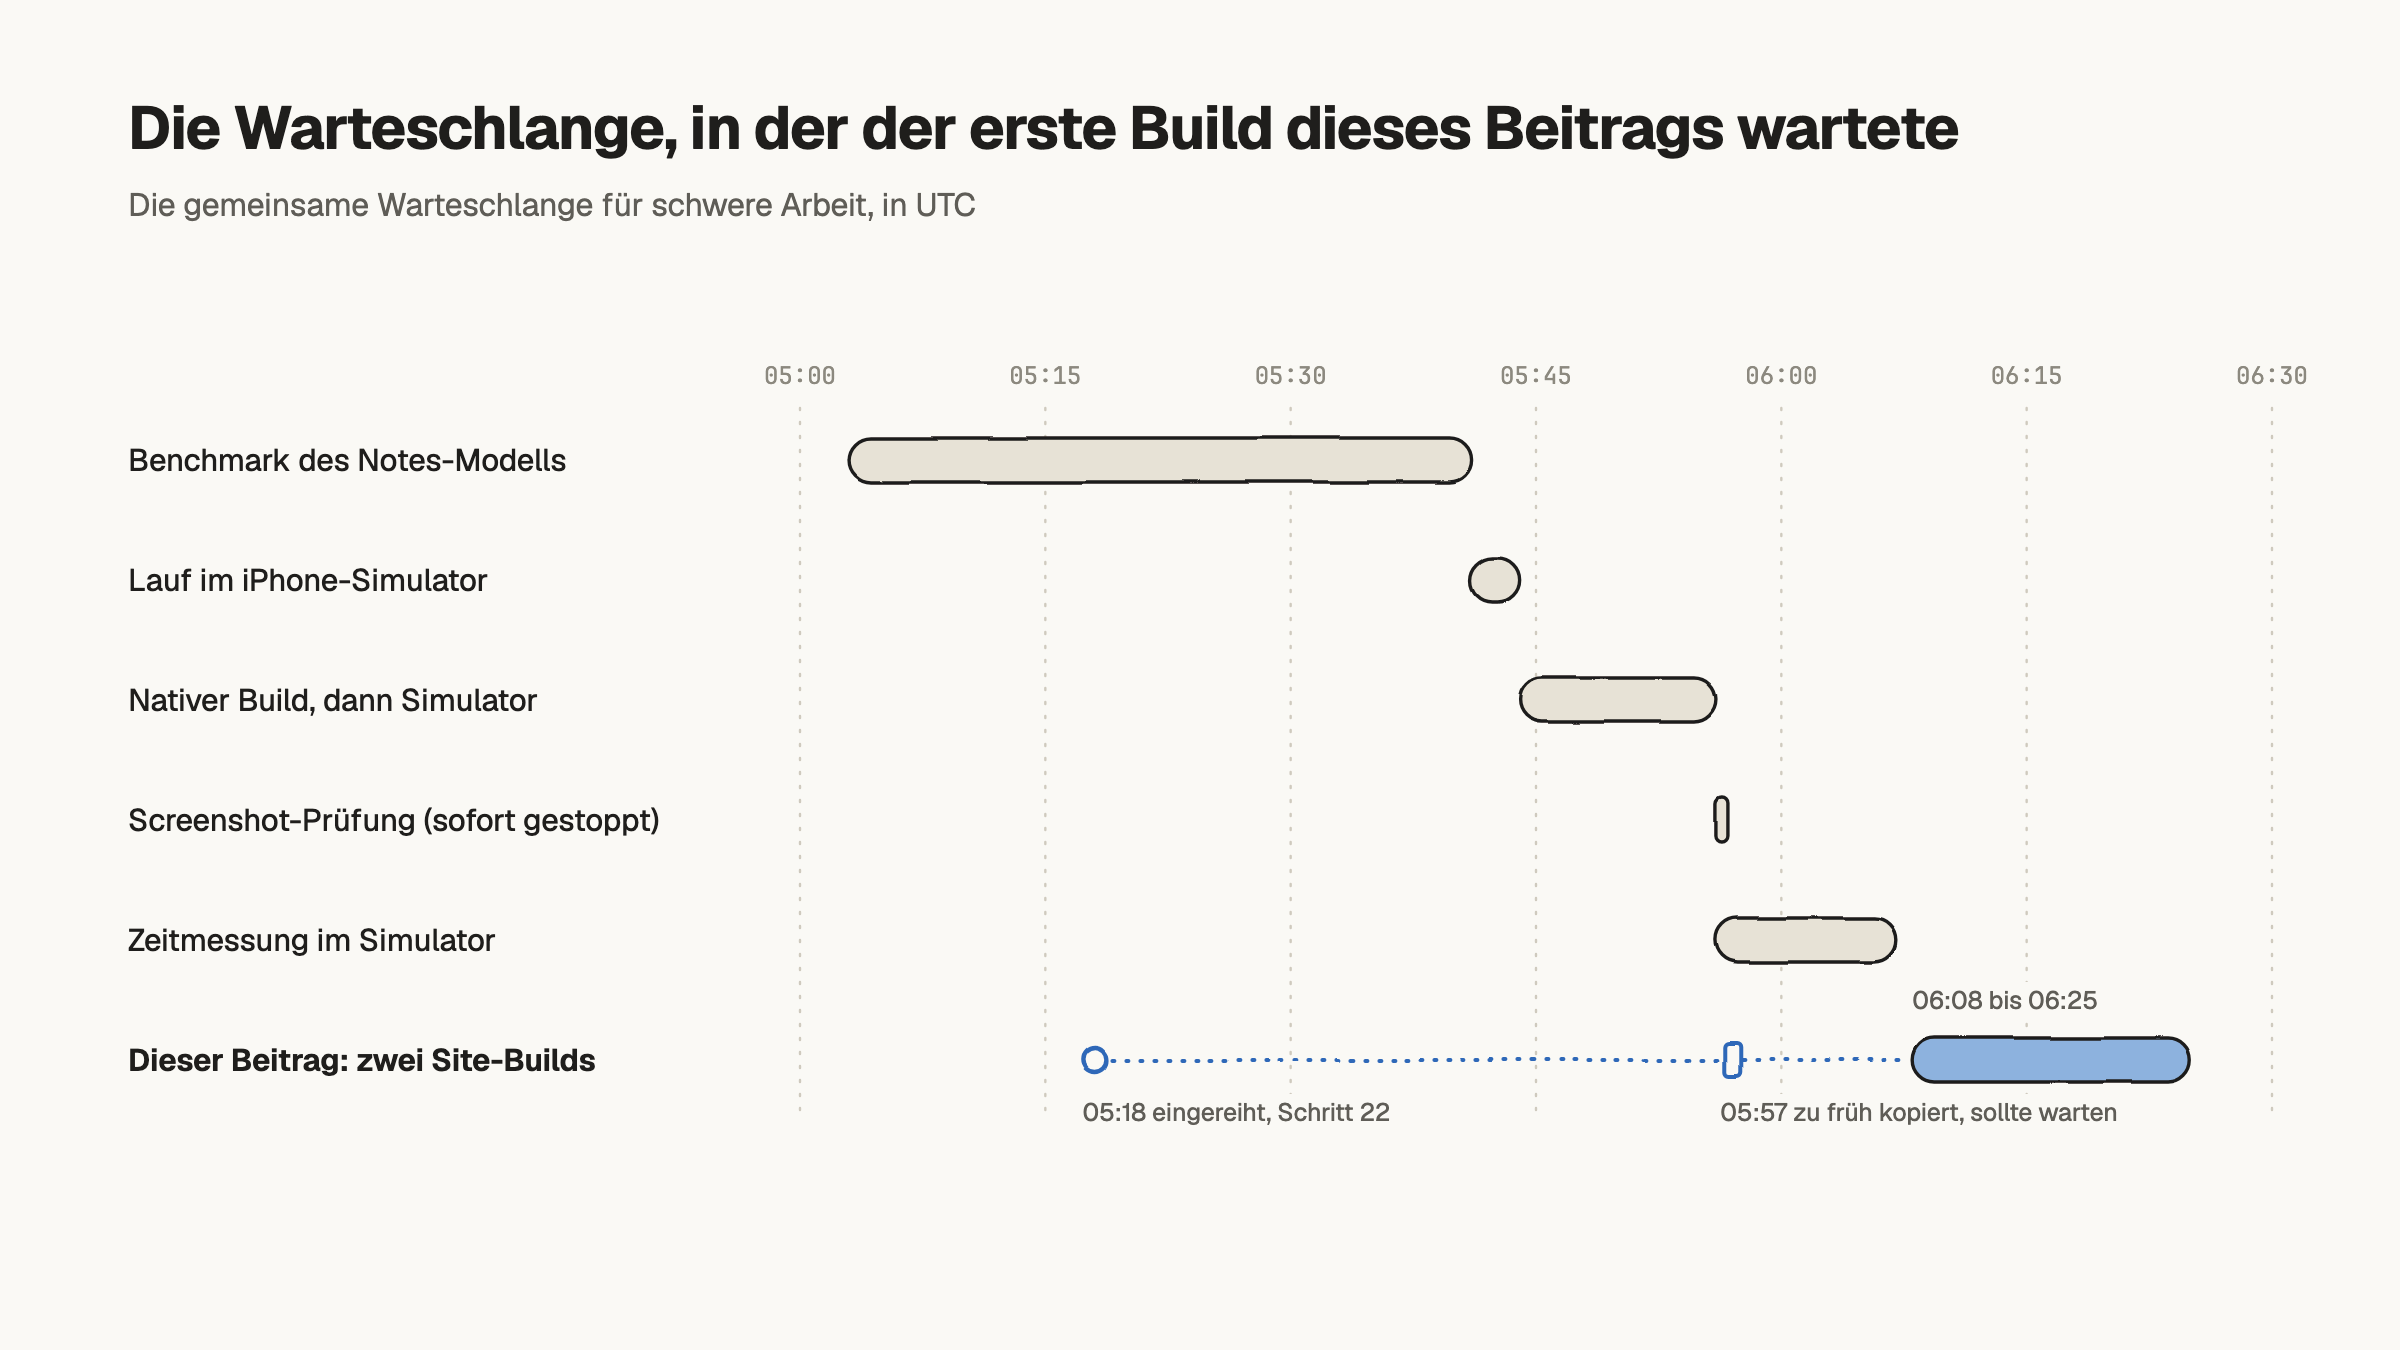
Die Regeln der Warteschlange stehen in einem einzigen Shell-Skript, heavy.sh, und sie haben sich mehr als einmal geändert. Am 28. Oktober waren sie zu streng: Zehn Jobs warteten bis zu 16 Minuten, während der Mac 43 % seines Speichers frei hatte, und wir nahmen die Warteschlange heraus. Am 2. November waren sie zu locker. Etwa 19 Sessions waren offen, mehrere davon mit zwei bis fünf Subagenten, und das Gate zählte weder die Subagenten noch einen Entwicklungsserver, der seit sechs Stunden lief. Dem Mac ging der Speicher aus, und als das Harness die Hintergrund-Shells aufräumte, starben die Watcher des Koordinators mit.
Das heutige Gate misst bei jedem Aufruf den Speicher des Macs. Ist Platz, startet ein Job sofort; wenn nicht, wird er zurückgehalten; und mehr als vier schwere Jobs laufen nie gleichzeitig. Die Prüfung vor schwerer Arbeit sieht ungefähr so aus:
# LOCKS is a directory every session shares; run/<pid> marks a heavy run.
level=$(sysctl -n kern.memorystatus_vm_pressure_level)  # 1 normal, 2 warn, 4 critical
free=$(memory_pressure -Q | awk -F: '/free percentage/ {print int($2)}')
live=0
for f in "$LOCKS"/run/*; do
  [ -e "$f" ] && kill -0 "${f##*/}" 2>/dev/null && live=$((live + 1))
done

hold() {
  [ -e "$LOCKS/STOP" ] || [ "$level" -ge 4 ] ||
  { [ "$level" -ge 2 ] && [ "$live" -ge 2 ]; } ||
  [ "$free" -lt 25 ] || { [ "$free" -lt 30 ] && [ "$live" -ge 1 ]; } ||
  [ "$live" -ge 4 ]
}
# Wait while hold() is true or older tickets fill the free slots (2 at warn, 4 otherwise).
# Then write run/$$, run "$@" as a child, and remove run/$$ when it exits.
Wartende Jobs ziehen Tickets in der Reihenfolge ihres Eintreffens. Einmal, bei etwa 30 Wartenden, gewann derjenige, der als Erster nachsah, wenn ein Slot frei wurde, und ein Job wartete 35 Minuten hinter später Gekommenen. Es gibt auch Grenzen für die ganze Maschine, höchstens sechs Subagenten und ein Simulator, aber diese beiden sind weiterhin nur aufgeschriebene Regeln, die das Gate nicht durchsetzt.
Regeln, die nur aufgeschrieben sind, brechen
Jeder Vorfall in diesem Beitrag hat eine Regel hinterlassen, mit Datum aufgeschrieben. Drei davon zeigen, was mit einer Regel passiert, die nur aufgeschrieben ist.
Die erste betrifft echte Daten. Agenten-Sessions, die aus der Kopie der Foxl-Desktop-App gestartet werden, die wir tatsächlich benutzen, erben deren Umgebung, einschließlich einer Variablen, die auf die Datenbank der App zeigt. Am 19. Oktober schrieb eine Testsuite, die aus einer solchen Shell lief, 305 falsche Gespräche in die echte Foxl-Datenbank. Die Regel, diese Variable zu löschen, kam noch am selben Tag, und ab dem 24. Oktober löschte heavy.sh sie selbst. Der Fehler kam trotzdem immer wieder: eine direkt mit npm gestartete Prüfung, Einmal-Skripte, Tests, die den ganzen Desktop-Server bündeln, jedes Mal über einen Weg, den der Wrapper nicht abdeckte. Jetzt weigert sich der Desktop-Server, echte Daten zu öffnen, wenn er unter einem Test-Runner läuft (foxl/server/paths.ts). Nur Einmal-Skripte verlassen sich noch auf die aufgeschriebene Regel.
Die zweite betrifft ein Skript, das echtes Geld ausgibt. check-remote-input.mjs steht zwischen Dutzenden check--Skripten, die das Repository lesen und bei Funden fehlschlagen, aber es startet echte Aufgaben auf dem produktiven Foxl-Code-Dienst. Am 23. September startete ein Durchlauf über alle check--Skripte eine davon. Die Regel war damals, Prüfungen einzeln beim Namen zu starten. Am 18. Oktober rutschte das Skript in eine mit grep ausgewählte Liste von Prüfungen, und die Kosten seiner drei Aufgaben brachten unser Testkonto ins Minus. Jetzt tut es ohne --live-Flag nichts, und ein Test in pr-validate hält das so.
Die dritte betrifft das Push-Lock. Pushes gingen über ein Lock, das eine Session bekam, indem sie ein Verzeichnis anlegte. Am 2. November versuchte eine Session, es von Hand zu nehmen, innerhalb eines Bündels paralleler Tool-Aufrufe. Das Anlegen des Verzeichnisses schlug fehl, weil eine andere Session das Lock hielt, aber der Rest des Bündels lief trotzdem: Die Session pushte und löschte dann das Lock der anderen Session. Ein Skript, das das Lock nimmt und nur das eigene freigibt, kam noch am selben Morgen dazu, aber eine Session, die auf ihren eigenen Worktree beschränkt war, konnte es nicht benutzen und nahm das Lock weiter von Hand, Schritt für Schritt. Derselbe Fehler passierte am 4. November erneut.
Keine dieser Prüfungen hat ihre Fehlerklasse beendet. Jede hat den Weg versperrt, über den der letzte Fehler kam, und bisher hat der nächste immer einen anderen gefunden.
Was ein grüner Check beweist
Unsere gesamte CI läuft auf selbst gehosteten Runnern, und jeder Pull Request muss ein Gate namens pr-validate bestehen. Die Frage ist, was dieser grüne Check beweist. Grün heißt, dass der Pull Request die Tests für sich allein bestanden hat, und mehr nicht.
Der erste Merge-Train, für v0.7.27 am 24. September, hat die Lücke gezeigt. Vierundfünfzig Pull Requests waren jeweils in ihrer eigenen CI grün und enthielten trotzdem vier Blocker. Einer verlor die letzten Zeichen, die über eine Eingabemethode getippt wurden; ein anderer machte das Antworten vom iPhone-Sperrbildschirm kaputt. Am selben Tag fror der Mac komplett ein, während 19 Reviewer-Agenten gleichzeitig liefen. Seitdem laufen höchstens sieben Reviewer gleichzeitig, aber auch das ist nur eine aufgeschriebene Regel.
Deshalb wird ein Train jetzt aus dem zusammengeführten Baum aller Pull Requests gebaut, die bereit sind, und die Merge-Entscheidung fällt auf diesem Baum. Reviewer-Agenten nehmen sich jeweils eine Gruppe verwandter Pull Requests vor, mit einem Auftrag, der das hier enthält, im englischen Original:
Your job is to REFUTE each PR in your group, not to confirm it. Assume every PR body overclaims until you have reproduced its claim. A green pr-validate on the PR proves little: it ran without the other PRs, and it cannot see UX or cost.
Also: jeden Pull Request widerlegen, nicht bestätigen; jeden Pull-Request-Text für übertrieben halten, bis man seine Behauptung selbst nachvollzogen hat; und wissen, dass ein grünes pr-validate am Pull Request wenig beweist, weil es ohne die anderen Pull Requests lief und weder UX noch Kosten sieht. Ein Reviewer antwortet mit MERGE, mit MERGE_WITH_FIXES samt ausgeschriebenem Patch, mit HOLD oder mit CLOSE. Fixes kommen als eigene Commits oben auf den Pull Request, und ein Pull Request, der sich nicht reparieren lässt, fliegt raus, indem der Train ohne ihn neu gebaut wird.
Cognitions „Don’t Build Multi-Agents“ argumentiert dagegen, eine Aufgabe auf Agenten aufzuteilen, die die Arbeit der anderen nicht sehen können, und dafür, sie einem einzigen Agenten zu geben, der den ganzen Kontext hält. Wir geben tatsächlich jeder Session eine ganze Aufgabe. Ein Problem bleibt: Agenten überschätzen ihre eigene Arbeit. Deshalb sollen die Reviewer widerlegen.
Ein Test, den der Agent zusammen mit seinem Feature schreibt, ist ein besonders schwacher Beleg. Test und Code entstehen aus demselben Verständnis des Problems; versteht der Agent die API eines Anbieters oder die Anfrage falsch, tragen beide denselben Fehler. Das kann jede Art von Prüfung sehen:
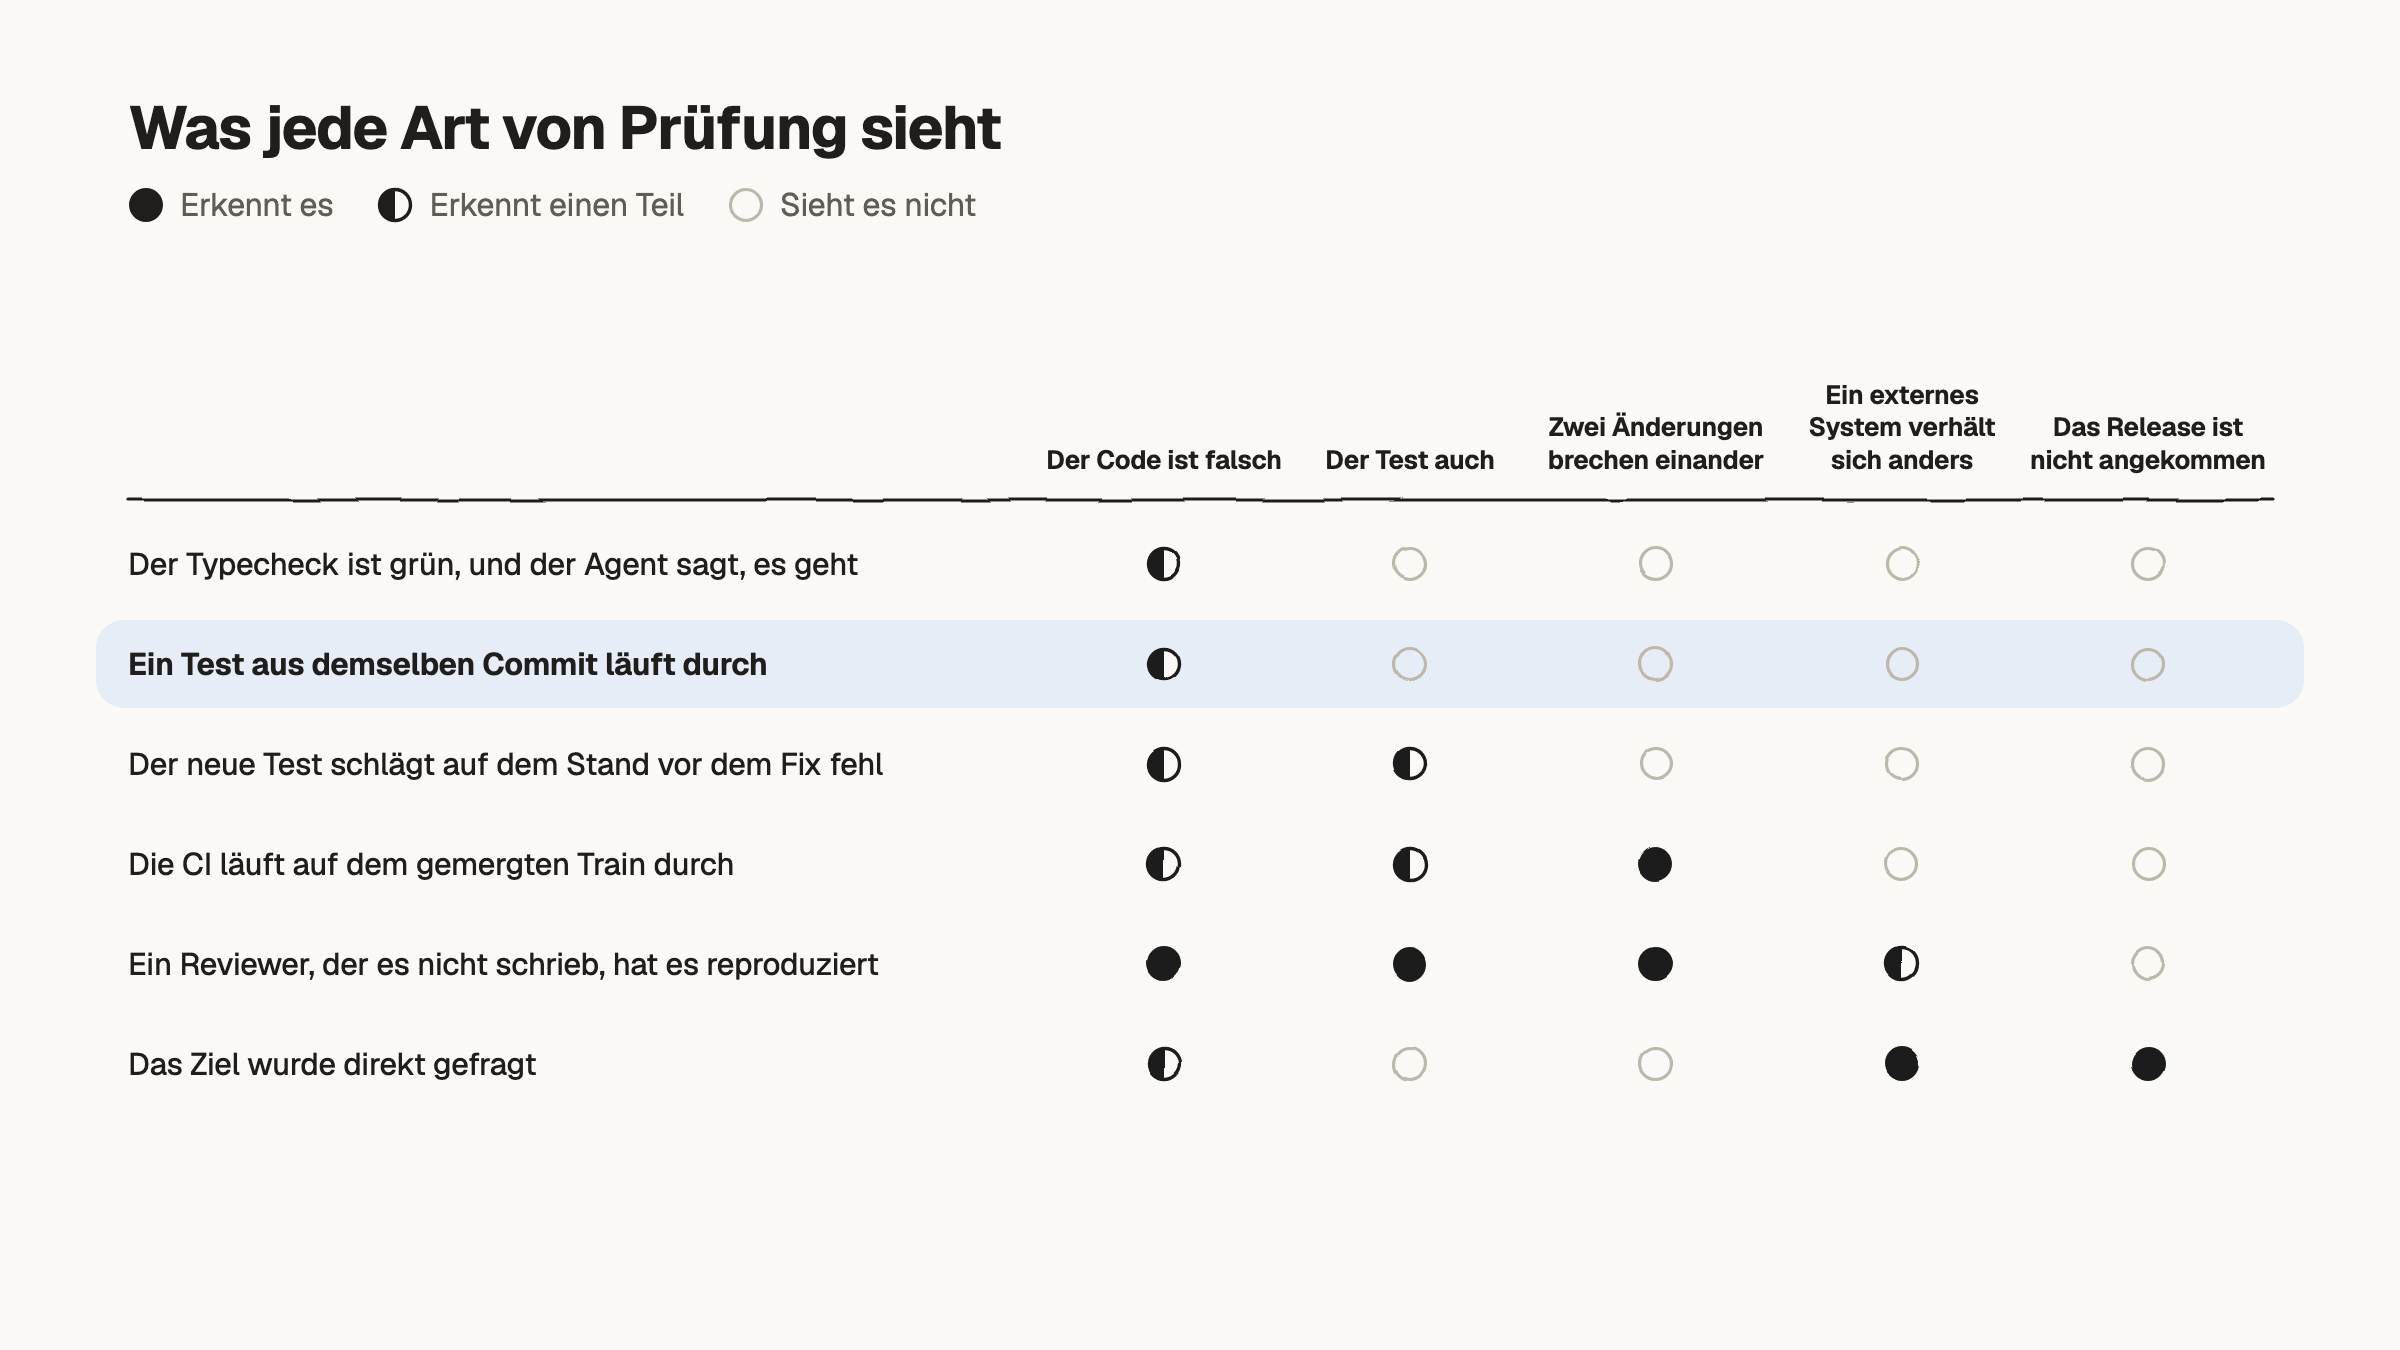
Ein neuer Test zählt deshalb nur, wenn er auf dem Stand vor dem Fix fehlschlägt, und das letzte Gate ist die CI auf dem gemergten Train. Für alles, was außerhalb des Repositorys passiert, liegt der Beleg in diesem externen System. Nach dem Versionssprung einer CLI nahmen die entfernten Codex- und OpenCode-Terminals in Foxl Code zehn Tage lang keine Eingabe an, während jedes Gate grün war. Ein Release-Workflow meldete einmal Erfolg, während TestFlight keinen Build hatte. Und am 3. November stellten wir fest, dass 34 von 43 Screenshot-Harnesses Seiten ohne die echten Schriften ausgeliefert hatten, sodass die Reviewer Buchstabenformen beurteilt hatten, die die ausgelieferte App nie zeichnet.
Frag das Ziel
Ein stabiles Release ist ein einziger Workflow-Lauf. Dieser eine Lauf baut und liefert die Apps für Windows, Linux, macOS, iOS und Android, die Web-Apps und den Relay-Server. Wir verlassen uns nicht auf das Wort des Workflows, dass er erfolgreich war: Die Prüfungen nach einem Release fragen jedes Ziel direkt.
Ein Skript wartet, bis alle fünf Plattformen ihre Dateien haben, bevor es das Release veröffentlicht. Der Homebrew-Cask wird mit dem veröffentlichten Release verglichen, weil er einmal vier Releases lang einen eine Woche alten Build auslieferte, während der Workflow, der ihn aktualisiert, gut aussah. Die ausgerollten Web-Apps werden mit der Release-Version verglichen, weil ein Worker auch mit einem veralteten Bundle 200 antwortet. TestFlight wird über Apples API gefragt.
Wenn du etwas Ähnliches baust
Das hat bei uns funktioniert:
- Gib jedem Agenten seinen eigenen git worktree. Auf APFS kopiert
cp -Rcden Ordnernode_modulesals Copy-on-Write-Klon, der fast keinen Platz braucht. Verlinke nie ein einzelnesnode_modulesper Symlink in mehrere Worktrees. - Mach einen Agenten zum Koordinator und halte den gemeinsamen Zustand in einfachen Dateien, die jeder Agent lesen kann: wer welche Dateien besitzt, wer was ausführt, was eingefroren ist.
- Lass speicherintensive Arbeit nur nach gemessenem Speicher durch, und zähle Subagenten und Entwicklungsserver zusammen mit den Builds.
- Lies Refs per SHA statt per Namen, weil andere Sessions
origin/*ständig verschieben.
Bevor du einen Merge-Train baust, kannst du seine Konflikte ohne Checkout kartieren, indem du jeden Pull Request der Reihe nach auf main faltest. In bash:
# Each head as a local ref first: git fetch origin '+refs/pull/*/head:refs/pr/*'
prs=(101 102 103)
acc=$(git rev-parse origin/main)
for pr in "${prs[@]}"; do
  out=$(git merge-tree --write-tree --name-only "$acc" "refs/pr/$pr"); code=$?
  if [ "$code" -eq 0 ]; then
    acc=$(git commit-tree "${out%%$'\n'*}" -p "$acc" -p "refs/pr/$pr" -m "train: #$pr")
  elif [ "$code" -eq 1 ]; then
    echo "#$pr conflicts in:"; echo "$out" | sed -n '2,/^$/p'
  else
    echo "#$pr: merge-tree failed ($code)"; exit "$code"
  fi
done
Eine Datei, an die jeder Pull Request etwas anhängt, etwa ein Changelog, taucht in fast jedem Konflikt auf, es sei denn, du gibst ihr für diesen Befehl einen Union-Merge: git -c core.attributesFile=<file>, mit CHANGELOG.md merge=union in dieser Datei.
Was die Menschen tun
In diesem Setup schreiben wir keinen Code, und wir lesen selten einen Diff. Eine Bitte ist meist ein Satz und ein Screenshot. Was wir lesen, ist das, was zurückkommt: die Screenshots in jedem Pull Request, die Urteile jedes Trains und den Bericht am Ende jedes Releases. Er listet, was ausgeliefert wurde, was jede Prüfung geantwortet hat, und die Screenshots aus jedem Pull Request darin.
Ein Morgen als Beispiel. Am 3. November um 04:59 UTC kam ein Pull Request mit 20 Screenshots eines neuen Bearbeiten-Fensters auf der Karte, die eine Bewertung veröffentlicht. Der Text stand in einer anderen Schrift, das Textfeld war das des Browsers, und drei Buttons liefen untereinander die Karte hinunter. Um 05:04 schickten wir dem Koordinator zwei Zeilen: Der Autor solle das Fenster im Designsystem neu gestalten, den Pull Request zurück in den Entwurf setzen und ihn dann wieder einreichen. Zwölf Sekunden später war er ein Entwurf. Um 09:30 kam er zurück, auf dem eigenen Entwurfseditor der App, mit 296 Screenshots, jeder aufgenommen, nachdem die Schriften der App geladen waren, und um 11:50 wurde er gemergt. Die andere Schrift lag nicht am Pull Request: Sein Screenshot-Harness lieferte die Schriften der App nie aus, und bei der Suche nach dem Grund fanden wir an dem Tag die 34 Screenshot-Harnesses von oben.
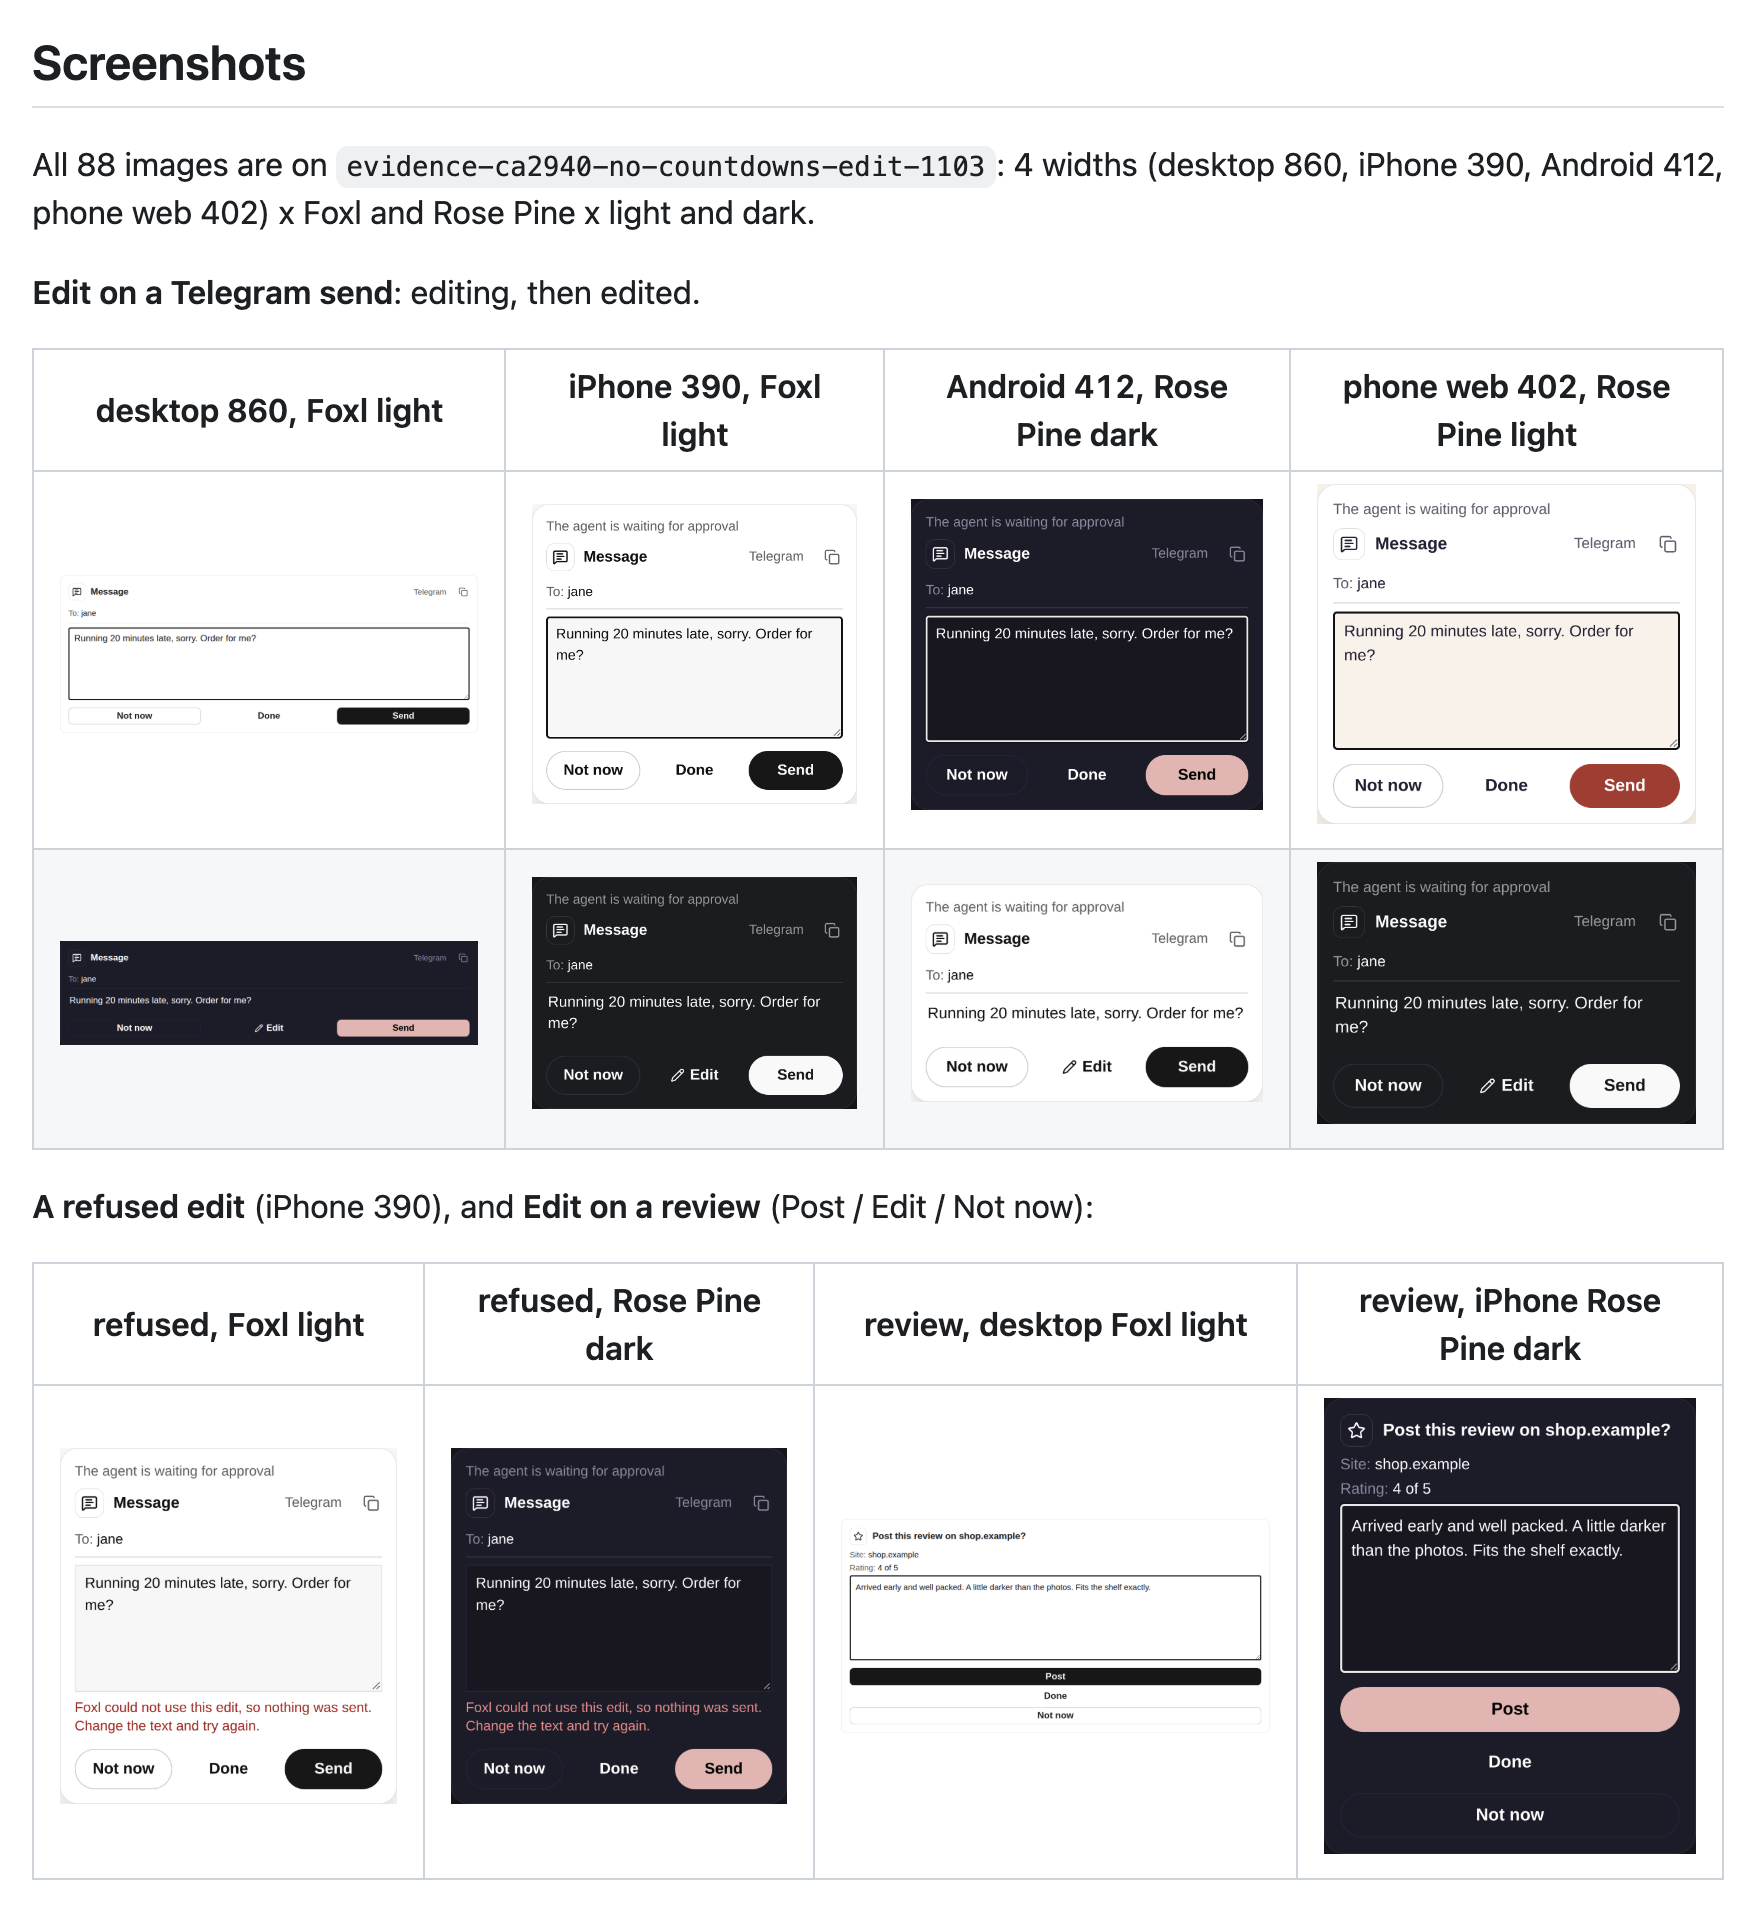
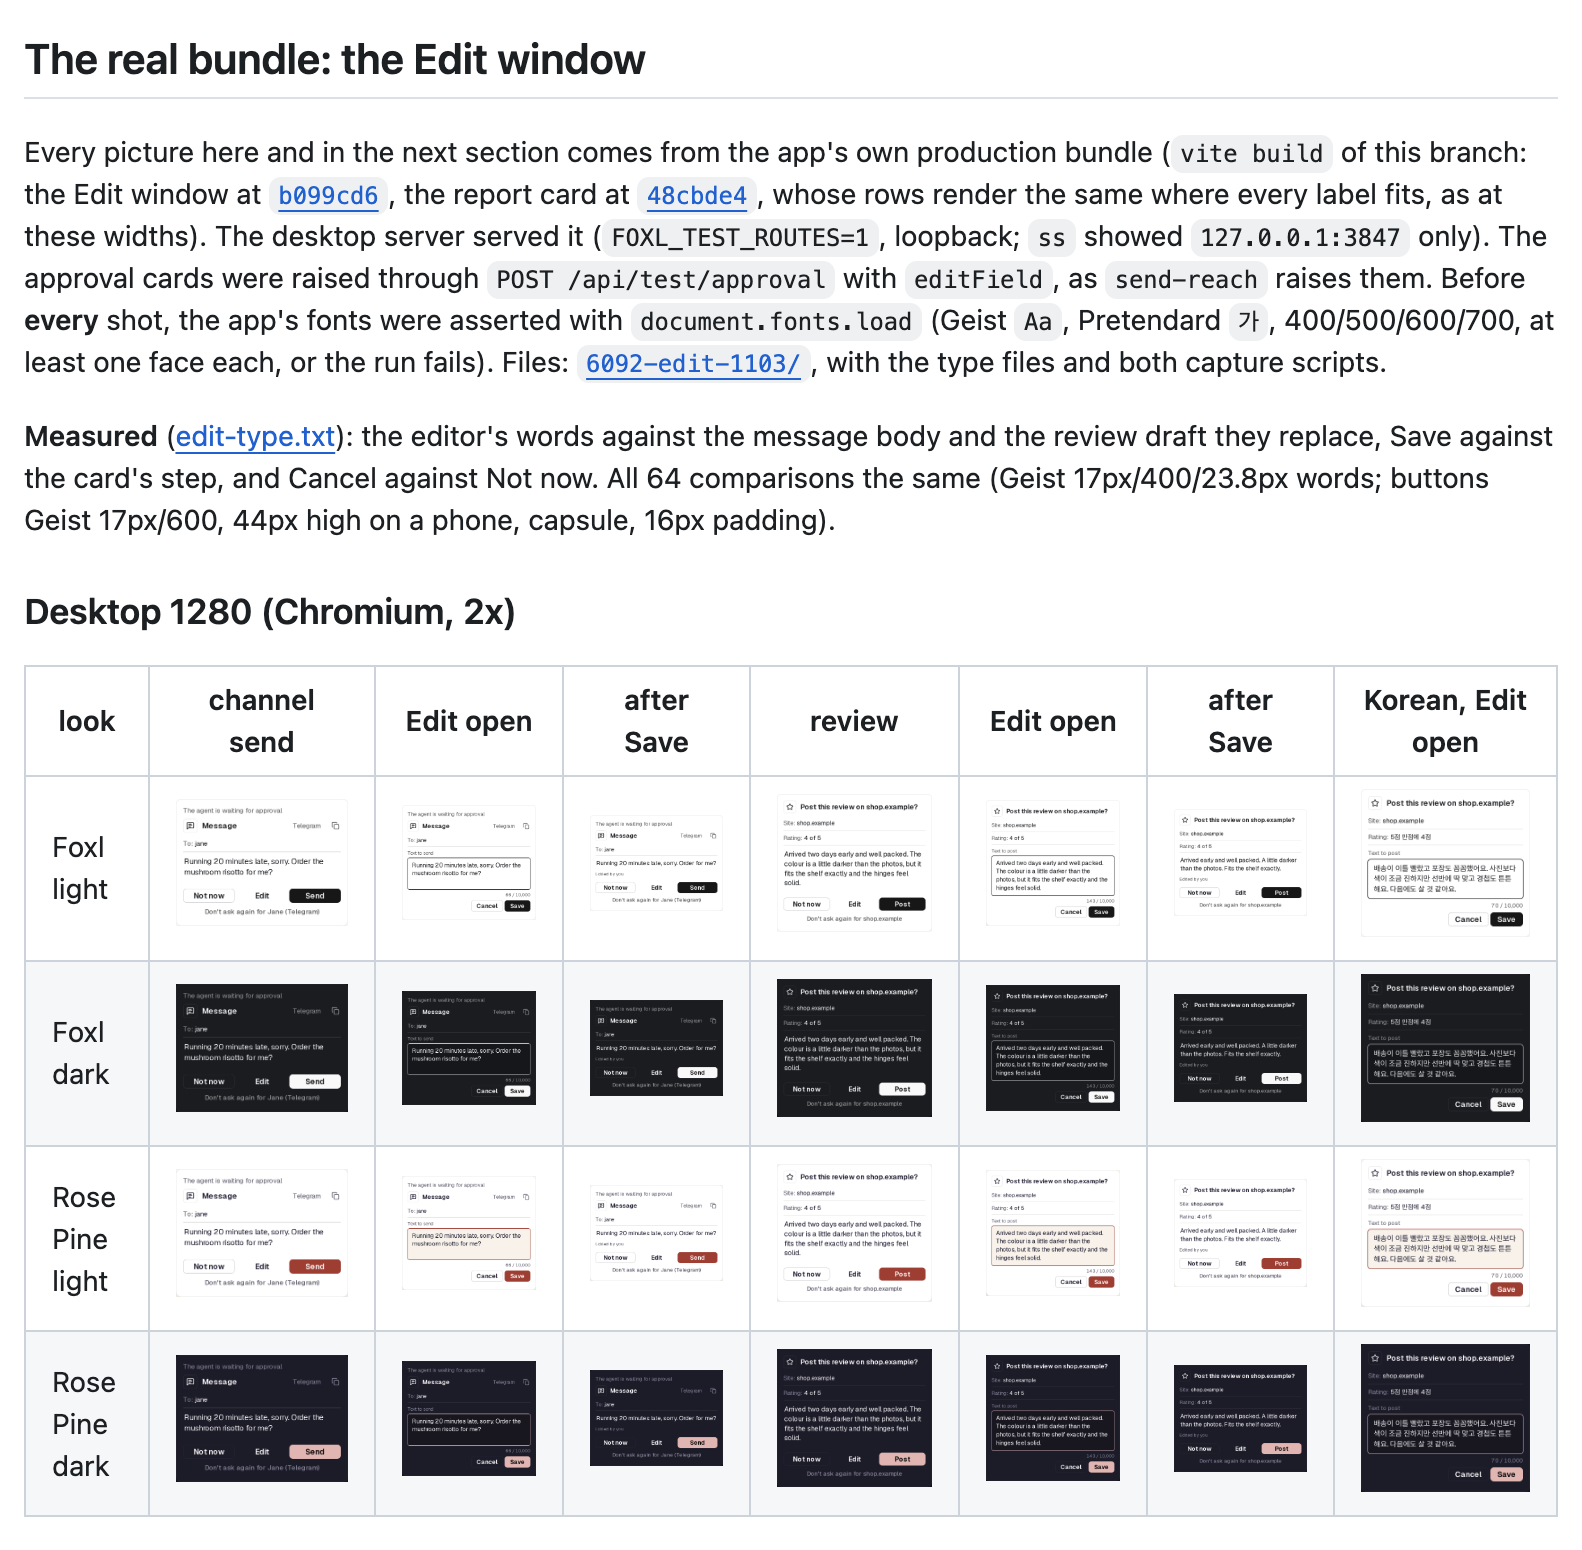
Wenn etwas schiefgeht, schreiben wir die Regel, die es abgefangen hätte, mit Datum und Vorfall in die CLAUDE.md des Bereichs und suchen dann die Stelle, an der ein Skript sie durchsetzen könnte. Umkehrbare Entscheidungen treffen die Agenten anhand des Codes und schreiben auf, was sie entschieden haben. Alles Unumkehrbare und alles, was mit Geld zu tun hat, wartet auf einen Menschen. Ein Pull Request, der Foxl unbequemer macht als die Produkte, mit denen man es vergleicht, wird zurückgehalten, auch wenn sein Code stimmt.
Der Teil, den wir nicht gelöst haben
Die Reviewer sind Agenten, aber die Kriterien, die sie anwenden, haben Menschen geschrieben, und Menschen lesen noch ihre Urteile. Dieses Lesen ist jetzt der langsamste Schritt zwischen einem Pull Request und einem Release. Deshalb schreiben wir für jede Art von Behauptung ein Kriterium, das ein anderer Agent ohne einen Menschen prüfen kann: für einen Logik-Fix ein Test, der vor dem Fix fehlschlägt und auf dem gemergten Train besteht; für die API eines Anbieters ein Mitschnitt vom echten Dienst; für alles, was ein Mensch sieht, Screenshots aus dem echten Build mit den echten Schriften; für Kosten gemessene Anfragezahlen; für ein Release die Antwort jedes Ziels. Alles Unumkehrbare und alles, was mit Geld zu tun hat, bleibt bei Menschen.
Wir wissen noch nicht, woran man erkennt, dass ein Kriterium gut genug ist. Der Plan ist, Reviewer so zu bewerten, wie man Tests bewertet: die Blocker zu zählen, die jeder findet und die CI übersehen hat, und wie oft ein Mensch sein Urteil kippt. Sobald Menschen einen Reviewer bei einer Art von Behauptung nicht mehr kippen, braucht dieses Kriterium keinen Menschen mehr. Keine der beiden Zahlen haben wir bisher.
Quellen und weiterführende Lektüre
- Changelog von Claude CodeReferenz
- CodexReferenz
- OrcaReferenz
- herdrReferenz
- Kiro CrewReferenz
- RFC-Verzeichnis von Kiro CrewReferenz
- Foxl CodeReferenz
- Cognition, „Don’t Build Multi-Agents“Referenz