Почему наш облачный агент промахивался мимо кэша промптов и что изменил TTL в один час
За первые 19 ходов в продакшене наш облачный агент прочитал из кэша промптов 42,6% входных токенов, и каждая крупная запись в кэш шла после паузы длиннее пятиминутного срока жизни кэша. TTL в один час поднял долю попаданий в измеренной сессии из девяти вызовов с 71,8% до 85,7% (93,9% после первого вызова) и снизил её стоимость на 8%, но чат, который заканчивается за пять минут, платит примерно на 23% больше. Как мы это измеряли, куда ставить четыре точки кэширования и когда более длинный TTL того стоит.
На этой странице
Облачный агент Foxl отвечает на чаты человека с телефона или из браузера, пока его компьютер выключен. За первые 19 ходов в продакшене он прочитал из кэша промптов 42,6% входных токенов. Когда мы посмотрели на крупные записи в кэш, оказалось, что каждая из них шла после перерыва длиннее пяти минут, а именно столько по умолчанию живёт запись в кэше. Люди, которые отвечают с телефона, часто молчат дольше.
Мы дали записям кэша агента срок жизни в один час и заново прогнали измеренную сессию из девяти вызовов. Доля попаданий выросла с 71,8% до 85,7%, или до 93,9%, если не считать первый вызов, который всегда пишет в кэш. Сессия обошлась на 8% дешевле в целом и на 15% дешевле по входу, хотя часовая запись стоит вдвое больше базовой цены входных токенов. Чат, который укладывается в пять минут, выходит наоборот: он платит вдвое за каждую запись и ни одну не читает обратно, и если убрать паузу, те же девять вызовов с часовой настройкой стоят примерно на 23% больше, чем с пятиминутной. Изменение вышло в Foxl v0.9.3-beta.5, а метод подходит любому агенту, который вызывает Claude через Messages API, у Anthropic или в Amazon Bedrock.
Как измерить долю попаданий в кэш промптов?
Доля попаданий - это доля входных токенов вызова, которые провайдер прочитал из кэша, а не обработал заново: cache_read / (uncached input + cache_read + cache_write). Кэш работает по точкам кэширования. Точка кэширования (breakpoint) - это маркер cache_control на одном блоке запроса, который просит провайдера закэшировать всё вплоть до этого блока, то есть префикс. Запись живёт в течение своего TTL (time to live, время жизни), по умолчанию пять минут, и следующий запрос, который начинается с того же префикса, читает её, а не платит за неё снова. В Bedrock точки кэширования называются контрольными точками (checkpoints).
Каждый ответ Messages API сообщает три счётчика входных токенов, и на странице Anthropic приведена их связь: total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokens. Значит, input_tokens считает только то, что не было ни прочитано из кэша, ни записано в него, и если разделить cache_read на input_tokens, получится другое и намного большее число. Converse API в Bedrock документирует то же для своих полей: при включённом кэшировании inputTokens «представляет только некэшированные входные токены».
Для каждого прогона мы приводим две цифры. Доля попаданий по всем вызовам включает первый вызов после истечения кэша, который всегда пишет. Доля попаданий после первого вызова показывает, во что обходится разговор, когда его кэш уже заполнен. Часть промпта одинакова для всех пользователей (первая точка кэширования ниже), поэтому в продакшене первый вызов одного человека может прочитать то, что записал чужой разговор, и увидеть это можно только в цифре по всем вызовам. Наш тест шёл от имени одного человека, так что этого он не измеряет.
Базовая цифра продакшена взята из биллинговых записей Foxl по облачному агенту: 19 ходов в 8 разговорах с момента запуска, 35 054 токена прочитано из кэша, 47 173 записано и 72 без кэша. 35 054 / (35 054 + 47 173 + 72) - это 42,6%. Агент записал больше, чем прочитал: как минимум 12 119 токенов (47 173 минус 35 054), примерно четверть того, за что он заплатил при кэшировании, так и не были прочитаны.
Почему чат-агент промахивается мимо собственного кэша
Ретранслятор Foxl, сервер между приложениями Foxl и Bedrock, уже ставил три точки кэширования на каждый запрос к Claude: на последний инструмент, на системный промпт и на последнее сообщение пользователя, все с пятиминутным TTL по умолчанию. Когда вызовы шли близко друг к другу, они попадали в кэш. Уточняющий вопрос, отправленный через 15 секунд после ответа, прочитал 3616 токенов и записал 44.
Все крупные записи шли после перерывов длиннее пяти минут. Сообщение, отправленное через 26 минут после предыдущего ответа, или чат, открытый через два часа после прошлого, заново записывали весь префикс, около 3,6 тыс. токенов инструментов и системного промпта. Рекомендации AWS для часового кэша описывают почти ровно этот случай: «когда вы храните длинный разговор с пользователем и обычно ожидаете, что пользователь может не ответить в ближайшие 5 минут».
Кроме того, попадание бесплатно обновляет запись («Кэш обновляется без дополнительной платы каждый раз, когда используется закэшированное содержимое»). Поэтому агент, который работает в цикле инструментов, редко упирается в пятиминутный предел, если только отдельный вызов или инструмент не длится дольше пяти минут. Чат с человеком упирается в него между ходами, а именно там такой чат проводит большую часть времени.
Куда ставить четыре точки кэширования
Запрос к Claude может нести не больше четырёх точек кэширования (Anthropic: «Можно задать до 4 точек кэширования»; Bedrock указывает 4 для каждой модели Claude в своей таблице). Закэшированный префикс читается в порядке tools, system, messages, и изменение в любом месте делает недействительным всё, что идёт после него. Все точки ретранслятора были пятиминутными, поэтому облачный агент теперь сам ставит все четыре, каждую со своим TTL. Запрос, в котором уже есть точки кэширования, ретранслятор не трогает и своих не добавляет.
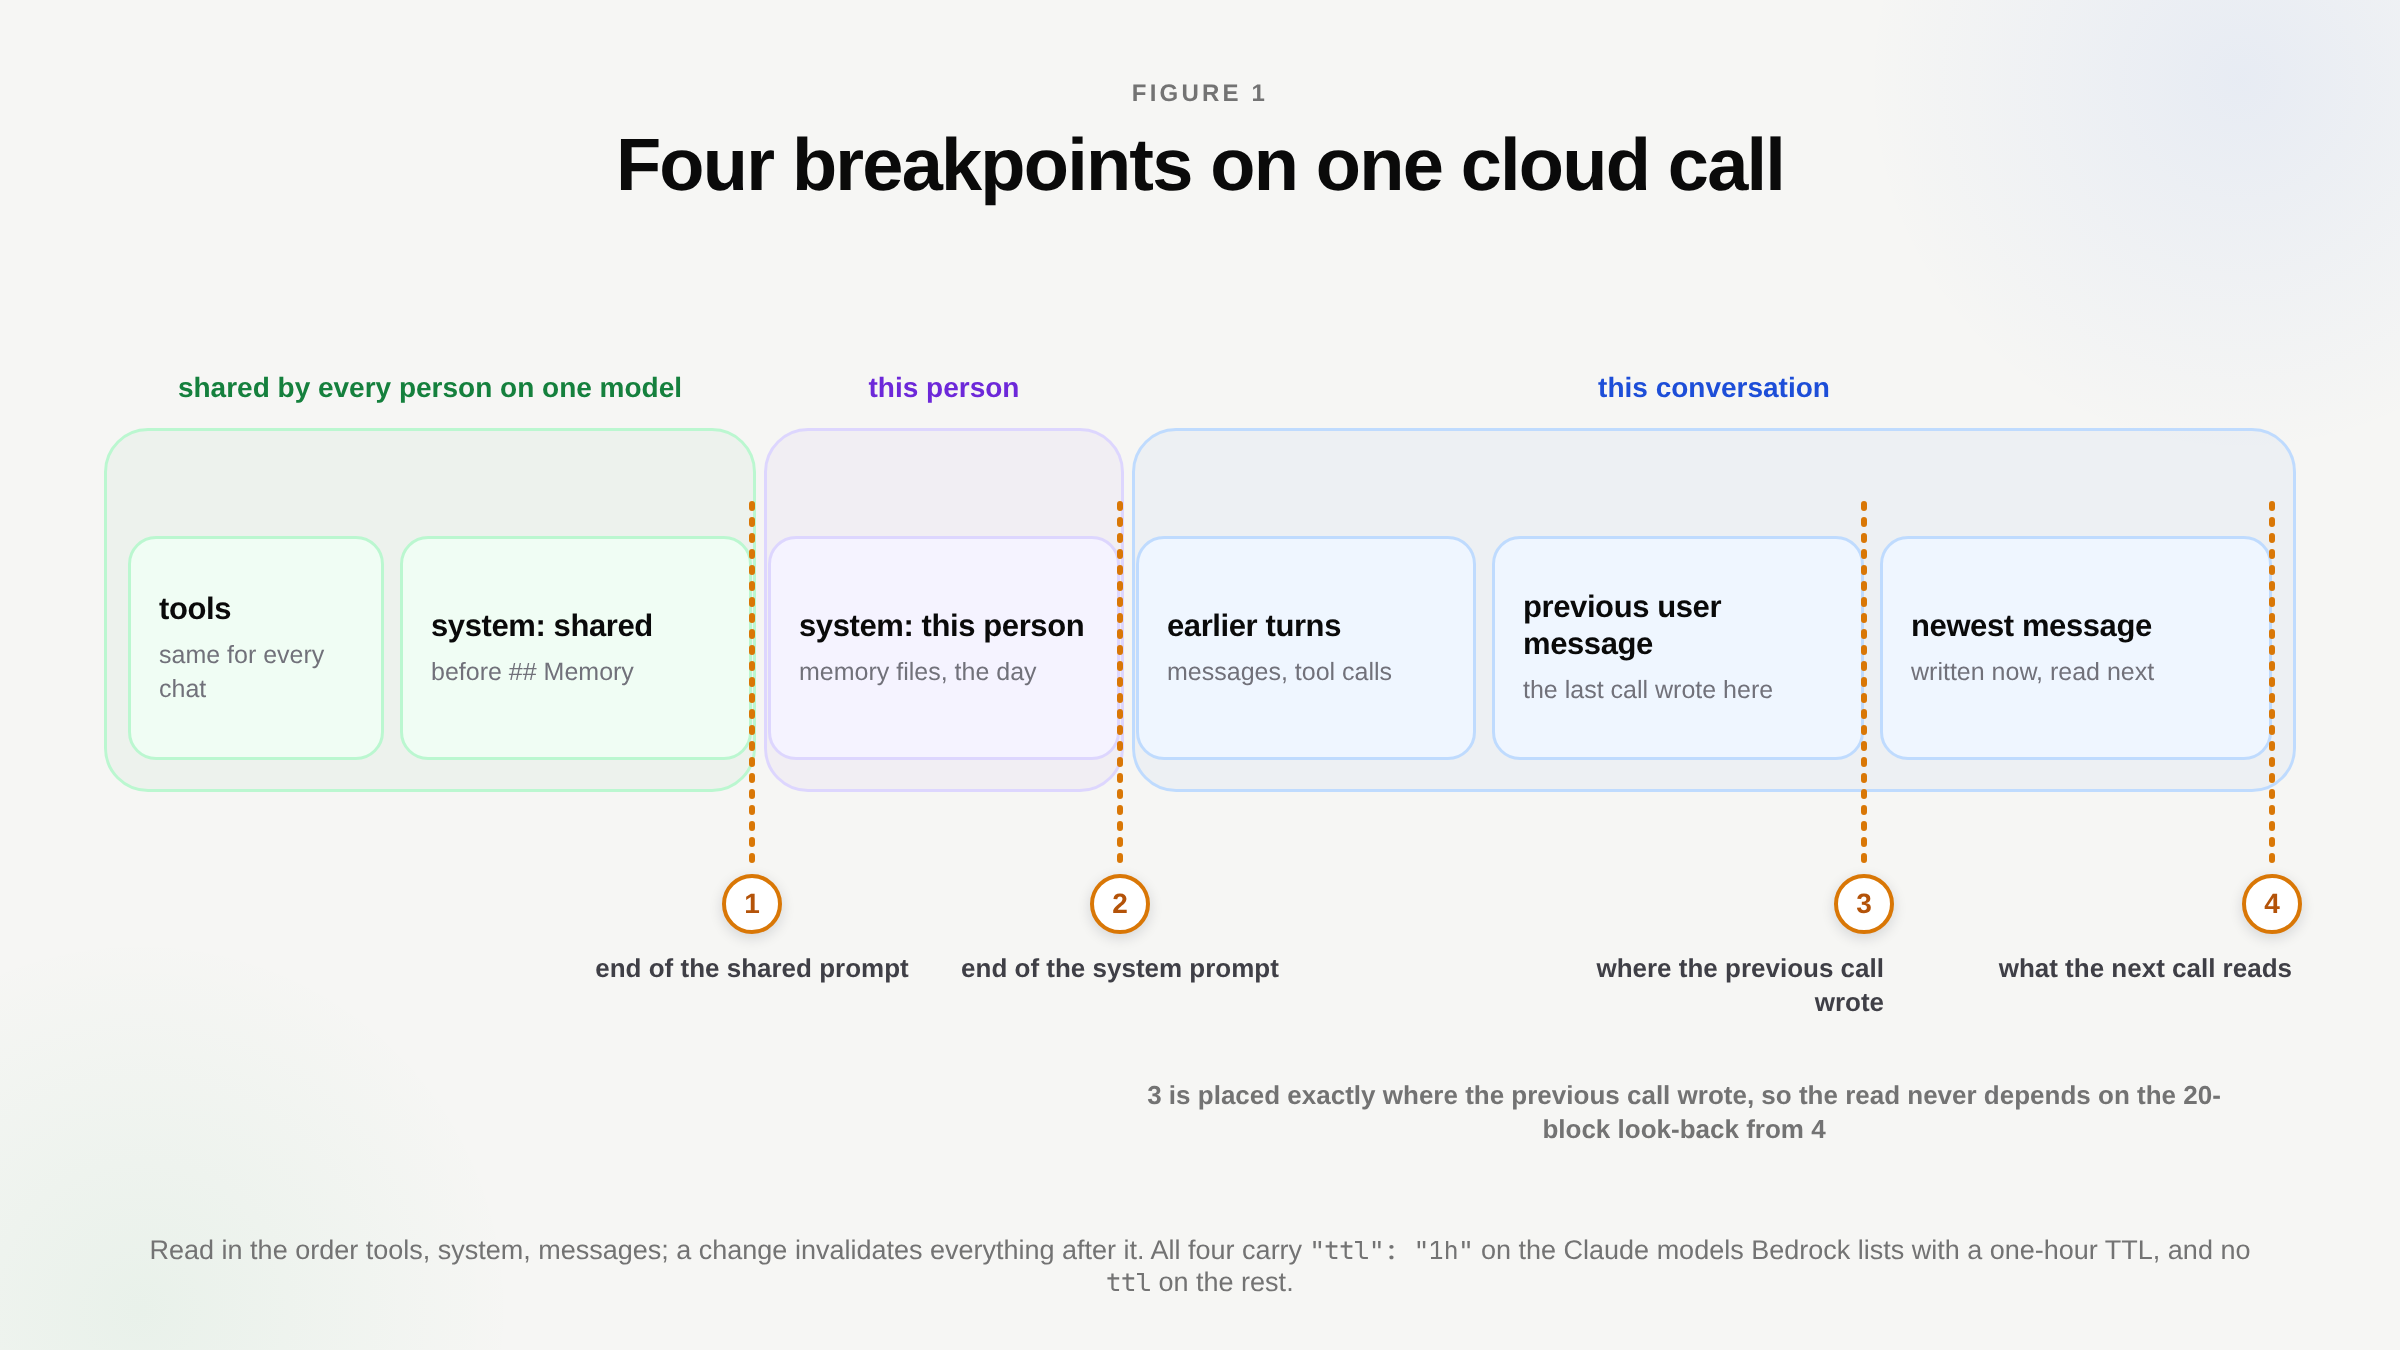
- Конец общей части системного промпта. Мы разделили системный промпт там, где начинается память конкретного пользователя, на заголовке
## Memory. Инструменты и всё, что выше этого заголовка (кто такой агент, что он может и чего не может в облаке), одинаковы для каждого разговора каждого человека на одной модели, поэтому совершенно новый чат от кого угодно начинается с их чтения. - Конец системного промпта. Вторая точка добавляет собственную память человека и строку с датой. В строке указан день, а не время, поэтому между вызовами она префикс не меняет.
- Последний кэшируемый блок предыдущего сообщения пользователя. Ровно сюда писал предыдущий вызов, поэтому чтение этой записи не зависит от того, как далеко API заглядывает назад. Без этой точки API начинает с самой новой и ищет более раннюю запись в кэше, но только на ограниченную глубину («Окно поиска назад составляет 20 блоков»), и ход с большим числом вызовов инструментов может вытолкнуть предыдущую запись за его пределы. Как считаются эти блоки, зависит от того, где вы вызываете Claude: API Anthropic считает серию идущих подряд блоков
tool_useилиtool_resultодной позицией, а на странице Bedrock сказано только «примерно 20 блоков содержимого», без такого исключения. - Последний кэшируемый блок самого нового сообщения. Это запись, которую прочитает следующий вызов.
У всех четырёх один и тот же TTL. Bedrock принимает оба TTL в одном запросе, если каждая часовая запись идёт раньше («часовая запись в кэше должна стоять перед любыми пятиминутными»), и один TTL для всех четырёх гарантирует это без всяких проверок. Точки ставятся только на блоки text, image, document, tool_use и tool_result: именно это содержимое сообщений Anthropic перечисляет как кэшируемое.
Часовой TTL получают только те модели Claude, которые в таблице Bedrock указаны с «Supported TTL: 5 minutes, 1 hour». Bedrock предупреждает, что передача этого поля модели, которая поддерживает только пять минут, «может привести к ValidationException», поэтому остальные модели Claude получают те же четыре точки без ttl. GPT-5.6 и более новые модели в Bedrock мы не трогаем: у них своё поле prompt_cache_breakpoint и, согласно той же странице, «минимальный TTL 30 минут».
// the marker on each of the four blocks, on a model that takes it
"cache_control": { "type": "ephemeral", "ttl": "1h" }
Есть ещё минимальный размер. Bedrock кэширует контрольную точку, только если всё до неё достигает минимальной длины для модели: 512 токенов у моделей 5.5 и 1024 или 4096 у некоторых более старых. Ниже минимума «инференс всё равно выполняется, но префикс не кэшируется». На модели с минимумом в 4096 токенов промпт на 3,6 тыс. токенов оставляет точки на инструментах и системном промпте без кэша, пока сам разговор не вытолкнет префикс за минимум, так что проверьте таблицу для каждой модели, которую вы обслуживаете.
Не обходится ли часовой кэш дороже, чем экономит?
По ценам Anthropic пятиминутная запись стоит в 1,25 раза больше базовой цены входных токенов, часовая - в 2 раза, а чтение - 0,1 от неё (0,05 у Opus 5.5 и Sonnet 5.5). Значит, часовая запись дороже пятиминутной на 0,75 базовой цены. Эту надбавку вы платите за префикс раз в час, а за новое содержимое каждого вызова - каждый раз. Взамен пауза дольше пяти минут больше не переписывает весь префикс по цене 1,25: префикс вместо этого читается.
Чтобы это измерить, мы прогнали продакшен-код облачного агента через локальную копию нашего ретранслятора на настоящем Bedrock. Сценарий: один чат из четырёх ходов (план, который отслеживается инструментом, уточнение, сохранение файла и затем, через 6,5 минуты, вопрос о первом ходе), а после него новый чат. Всего это девять вызовов модели на Sonnet 5.5, потому что ход с инструментом делает больше одного вызова. Расход считывался из потока, который вернул Bedrock, а в столбце стоимости собственные потокенные цены Foxl для Sonnet 5.5.
| настройка | чтение из кэша | запись в кэш | попадания, все 9 вызовов | попадания, вызовы 2-9 | стоимость прогона |
|---|---|---|---|---|---|
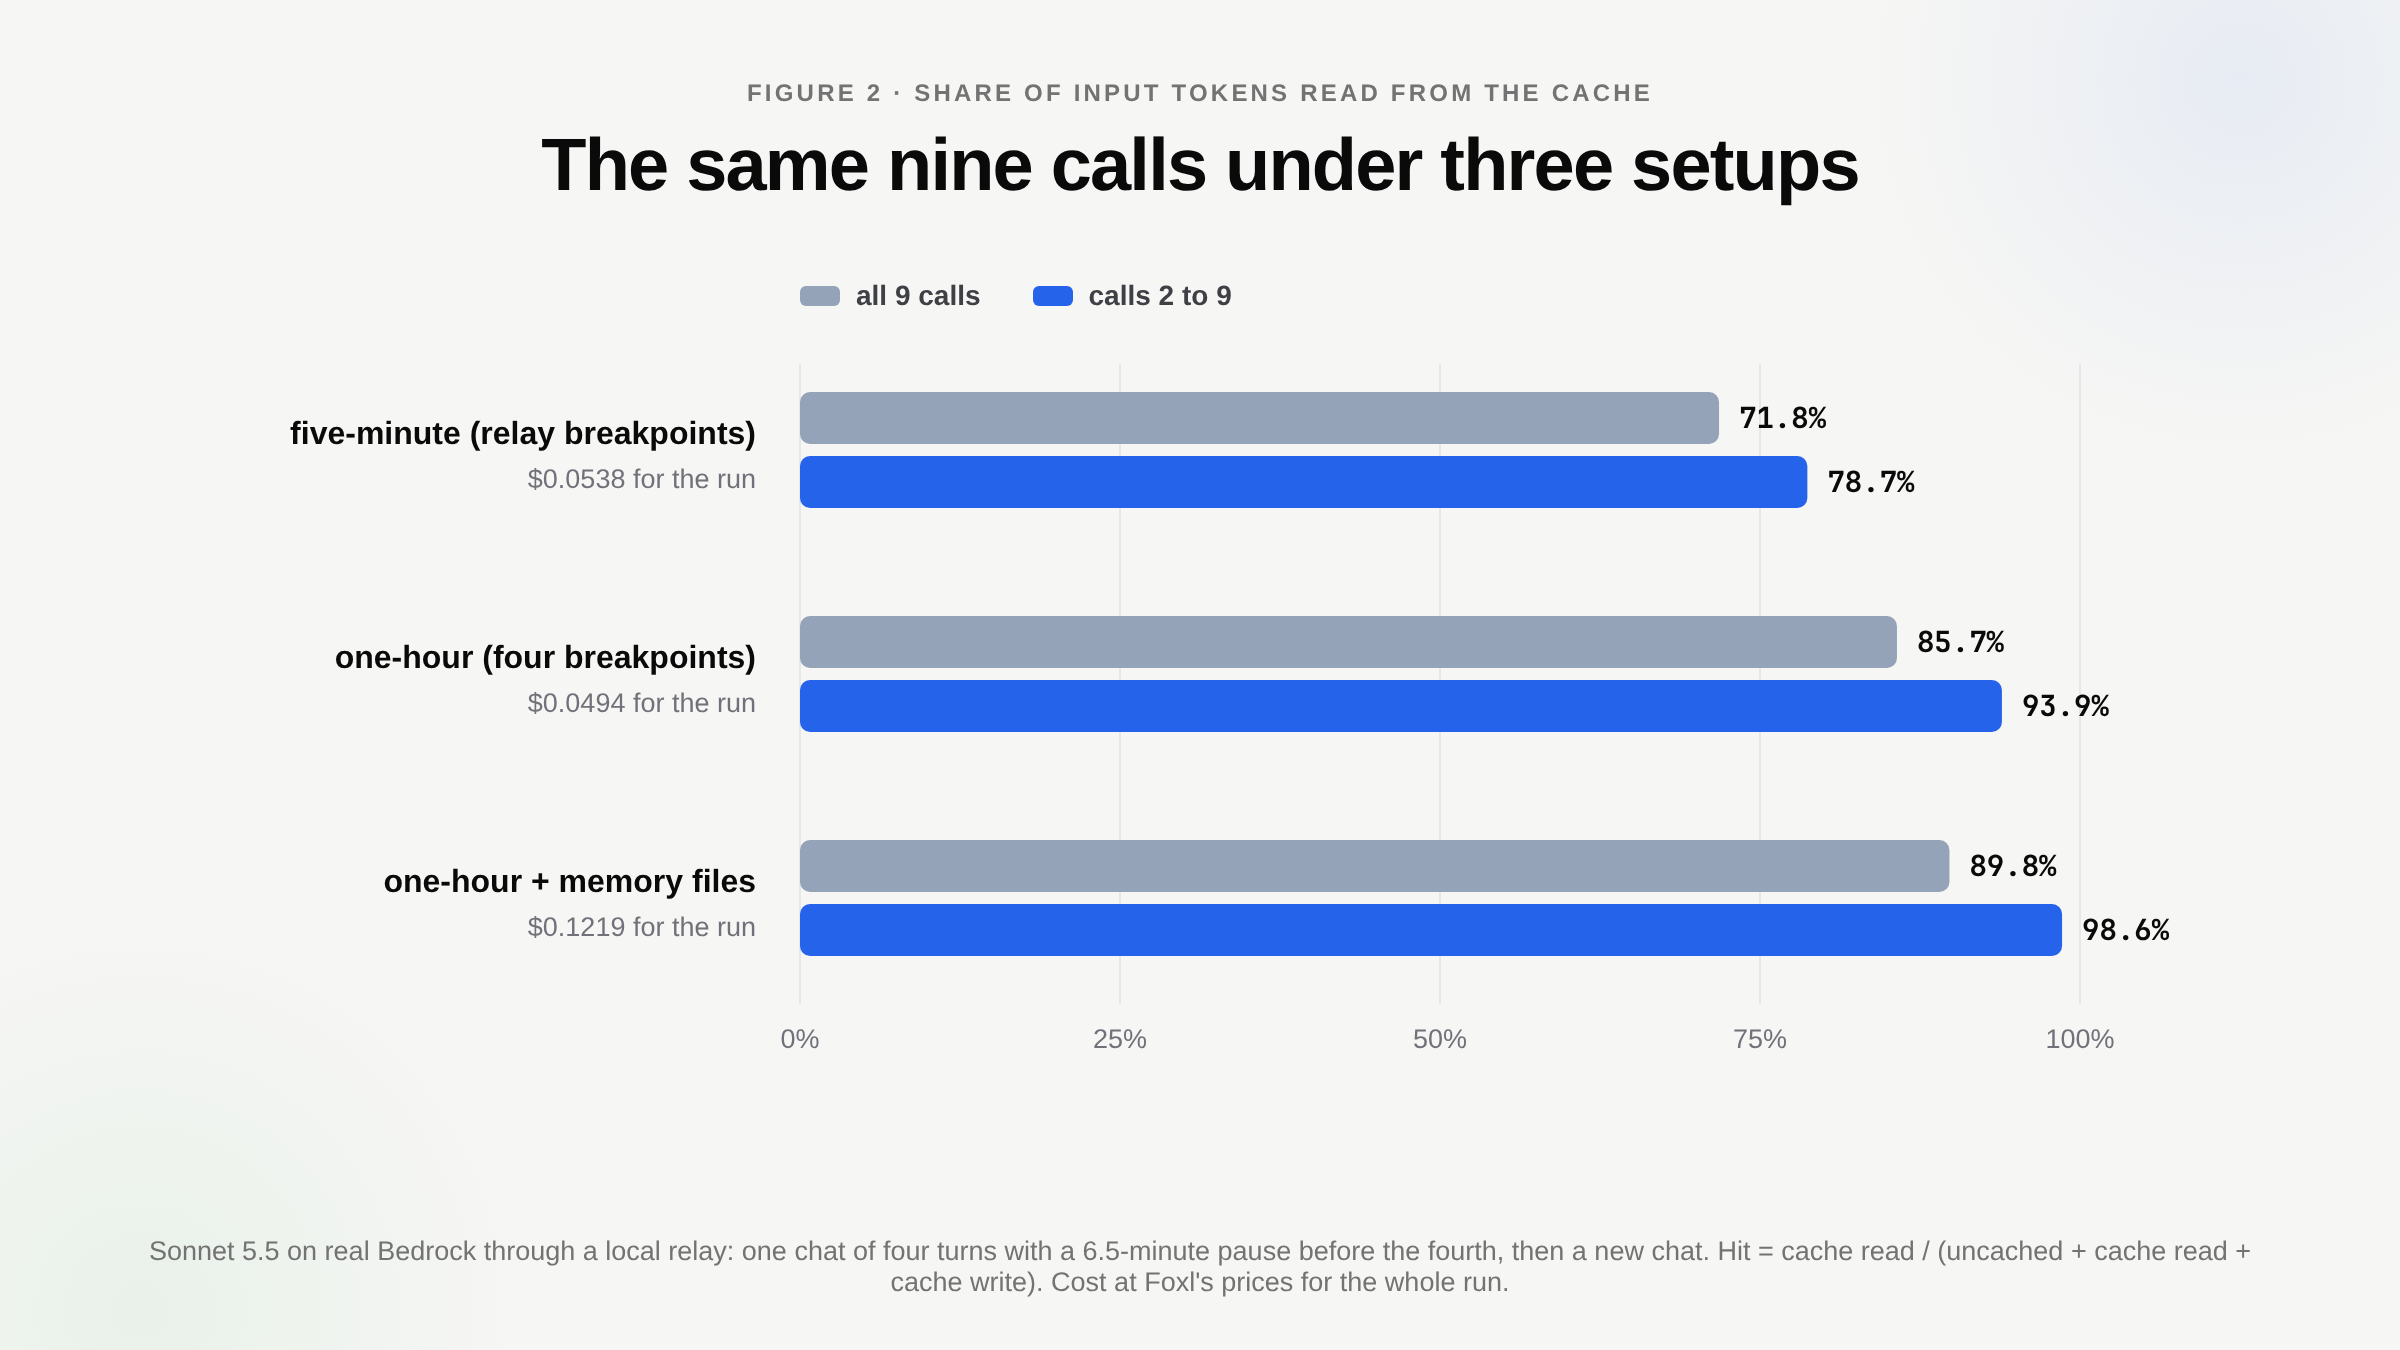
| пятиминутная (точки ретранслятора) | 29 979 | 11 755 (5 мин) | 71,8% | 78,7% | $0,0538 |
| часовая (четыре точки) | 35 859 | 5 974 (1 ч) | 85,7% | 93,9% | $0,0494 |
| часовая плюс файлы памяти (о них ниже) | 177 347 | 20 108 (1 ч) | 89,8% | 98,6% | $0,1219 |
Почти вся разница приходится на вызов после паузы в 6,5 минуты. С пятиминутными записями он заново записал свой префикс из 5873 токенов. С часовыми он прочитал 5750 токенов и записал 133, и Bedrock отчитался о каждой записи как о ephemeral_1h_input_tokens, так что мы знаем, что более длинный TTL действительно применился, а не был молча проигнорирован. Часовой прогон прочитал на 5880 токенов больше, чем пятиминутный (35 859 минус 29 979); 5750 из них пришлись на этот один вызов, а остальные примерно 130 - на перенос точек кэширования. В сценарии не было хода с большим числом вызовов инструментов, то есть того случая, ради которого нужна третья точка. Некэшированный вход в каждом прогоне составил 28 токенов.
Пятиминутная настройка набирает в этом тесте 71,8% против 42,6% в продакшене, потому что в тесте один перерыв в 6,5 минуты, а 19 ходов продакшена были разбросаны по 8 разговорам с перерывами в 26 минут и в два часа. Один и тот же код показывает очень разные результаты на разном трафике, поэтому сравнивайте доли попаданий только между прогонами одного и того же сценария.
Без паузы результат обратный. Уберите её из тех же измерений, и пятиминутная настройка ни разу не переписывает префикс, так что дешевле оказывается она: часовой прогон стоит примерно на 23% больше в целом и примерно на 48% больше по входу, потому что за каждую запись он заплатил двойную базовую цену, а после пятой минуты их никто не прочитал.
Для своего трафика на Sonnet 5.5 или Opus 5.5 сравните два числа:
- Экономия: каждый токен префикса, который пауза заставила бы переписать, экономит примерно 1,2 базовой цены (перезапись по 1,25 заменяется чтением по 0,05).
- Надбавка: каждый токен, записанный в течение этого часа, стоит на 0,75 базовой цены больше (2 вместо 1,25).
Часовой TTL выигрывает, когда экономия больше. Чат с паузой от пяти до шестидесяти минут обычно до этого дотягивает, как и второй чат, начатый в течение часа; а чат, который заканчивается в пределах пяти минут, если в этот час больше ничего не происходит, не дотягивает. Для людей, которые отвечают с телефона, мы выбрали один час. Для агента, вызовы которого идут с разницей в секунды, лучше пять минут.
Если вы резервируете кредит перед каждым вызовом, TTL меняет и резерв. Ретранслятор Foxl резервирует по худшему случаю, поэтому запрос с часовым TTL резервируется по ставке часовой записи. Эта ставка (2) в 1,6 раза выше пятиминутной (1,25), так что вызов Sonnet 5.5 с контекстом в 100 тыс. токенов резервирует на вход около $0,40 вместо $0,25. Списывается по-прежнему фактический расход вызова, но почти пустой баланс может получить отказ на один вызов раньше.
Что задаёт потолок
Новое содержимое. Каждое новое сообщение пользователя и каждый ответ записываются в кэш один раз, прежде чем их можно прочитать, поэтому никакая расстановка точек не позволит вызову прочитать токены, которые он сам добавляет. В часовом прогоне первый вызов ничего не прочитал, потому что пятиминутные записи предыдущего прогона истекли, так что все 35 859 прочитанных токенов пришлись на вызовы со 2-го по 9-й: 93,9% от примерно 38 200 входных токенов, которые они взяли. Остальные примерно 2300 - это новые сообщения и ответы этого прогона, поэтому 93,9% - потолок для этого сценария. Более длинный чат несёт больше истории на каждый новый токен, поэтому его потолок выше.
Больший стабильный префикс тоже поднимает долю, ничего при этом не удешевляя. Мы увидели это, когда у облачного агента появилась возможность включать файлы памяти пользователя: четыре файла Markdown (SOUL.md, USER.md, MEMORY.md и AGENTS.md), которые настольное приложение Foxl кладёт в собственный промпт. Телефон или браузер копирует их, пока компьютер подключён, обрезает тем же кодом, что и настольное приложение, и отправляет вместе с каждым облачным сообщением. Один реальный набор таких файлов, обрезанный таким образом, занял около 41 тыс. символов, примерно 14 тыс. входных токенов на вызов; в третьем прогоне использовался тестовый файл того же размера.
В этом прогоне первый вызов записал 17 619 токенов промпта человека, каждый следующий вызов их читал, и доля попаданий после первого вызова достигла 98,6%. При этом прогон стоил $0,1219 против $0,0494, потому что промпт в несколько раз больше; без кэша те же девять вызовов стоили бы $0,4187. У него была лучшая доля попаданий из трёх прогонов и самый большой счёт, и именно поэтому рядом с каждой долей попаданий мы указываем стоимость.
Что мы не измерили
- Продакшен после изменения. На 2026-10-23 после развёртывания изменения в продакшене не прошло ни одного облачного хода, так что 42,6% - единственная цифра из продакшена, а цифры «после» получены на локальном ретрансляторе с настоящим Bedrock.
- Другие модели. Мы запускали только Sonnet 5.5. Остальные модели Claude, которые получают часовой TTL, получают его на основании таблицы Bedrock, а Opus 5.5 ещё и на основании более раннего измерения через наш ретранслятор.
- Другие сценарии. Девять вызовов по одному шаблону, и ни один из них не ход с большим числом вызовов инструментов. Чат, который простаивает больше часа, снова платит за первую запись, а один час - самый длинный TTL, который любой из двух провайдеров предлагает для Claude.
Если вы запускаете собственных агентов на Claude, долю попаданий проверить дешевле всего. Сложите три счётчика каждого вызова, разделите чтения на весь вход и посмотрите, что предшествовало каждому вызову, который записал большой префикс. Если перед ним был перерыв длиннее пяти минут, это исправит часовой TTL, как и произошло почти со всем выигрышем в этом сценарии. Если перед ним был вызов секундами раньше, то либо префикс изменился между двумя вызовами, либо предыдущая запись оказалась за пределами окна поиска назад, а от этого и защищает третья точка. В одной из прошлых статей рассказано, как удержать субагента на кэше родительского агента (на английском), то есть о том же правиле префикса внутри одного хода.