我们的云端智能体为什么错过提示缓存,一小时 TTL 又改变了什么
我们的云端智能体在前 19 个生产轮次中,有 42.6% 的输入是从提示缓存读取的,而每一次大的缓存写入都发生在超过缓存五分钟存活时间的停顿之后。改用一小时 TTL 后,一次经过测量的九次调用会话命中率从 71.8% 升到 85.7%(第一次调用之后为 93.9%),成本降低 8%,但五分钟内结束的聊天要多付约 23%。本文介绍我们如何测量、四个断点放在哪里,以及什么时候值得用更长的 TTL。
本页内容
Foxl 的云端智能体会在用户的电脑关机时,回答他们从手机或网页发来的聊天。在上线后的前 19 个生产轮次里,它的输入有 42.6% 是从提示缓存中读取的。我们查看那些大的缓存写入时发现,每一次都发生在超过五分钟的间隔之后,而五分钟正是缓存条目的默认存活时间。用手机回复的人,常常隔得比这更久。
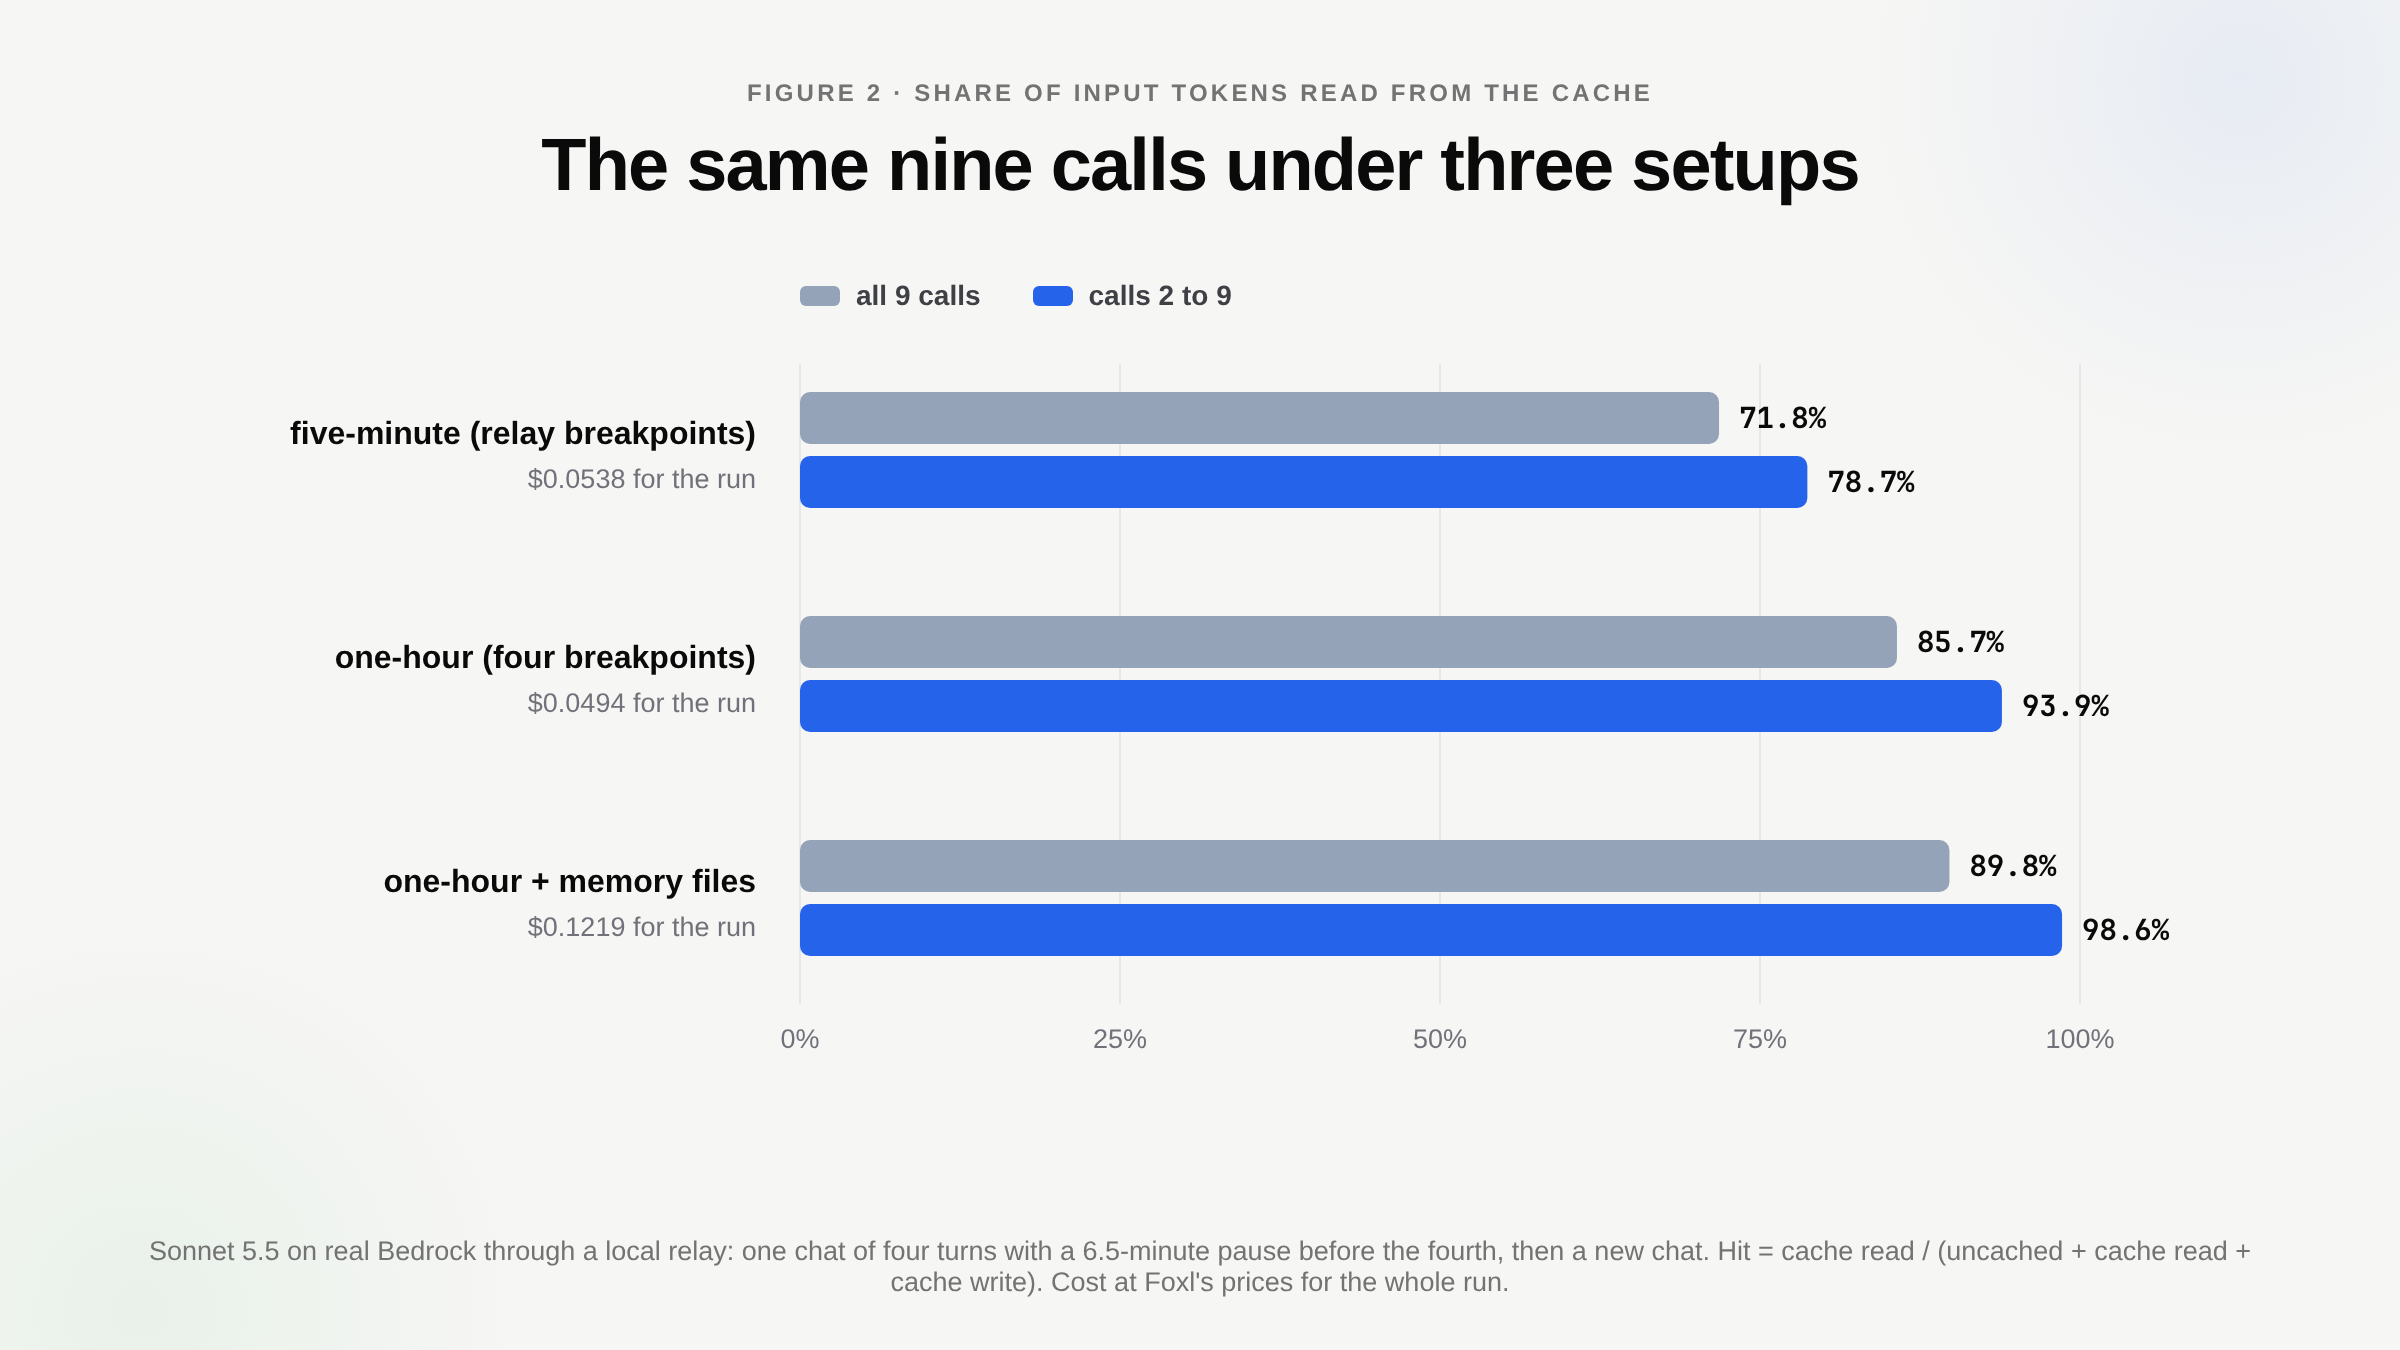
我们把智能体缓存条目的存活时间改成一小时,再重新跑了一次经过测量的九次调用会话。命中率从 71.8% 升到 85.7%;如果不算总是要写入的第一次调用,则是 93.9%。尽管一小时写入的价格是基础输入价格的两倍,这次会话的总成本仍下降了 8%,输入部分下降了 15%。五分钟内就结束的聊天结果正好相反:每次写入都付双倍价钱,却从来读不回来;去掉间隔后,同样的九次调用在一小时设置下比在五分钟设置下贵了约 23%。这项改动随 Foxl v0.9.3-beta.5 发布,方法适用于任何通过 Messages API 调用 Claude 的智能体,无论是在 Anthropic 上还是在 Amazon Bedrock 上。
如何测量提示缓存命中率?
命中率是一次调用的输入 token 中,提供商从缓存读取、而不是重新处理的那部分所占的比例:cache_read / (uncached input + cache_read + cache_write)。缓存以断点为单位工作。缓存断点是请求中某个块上的 cache_control 标记,要求提供商把截至这个块的全部内容缓存起来,这部分内容就是前缀。缓存条目在它的 TTL(time to live,存活时间)内有效,默认是五分钟;下一个以相同前缀开头的请求会直接读取它,而不用再为它付一次费。Bedrock 把断点称为检查点(checkpoint)。
每个 Messages API 响应都会报告三个输入计数器,Anthropic 的文档给出了它们之间的关系:total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokens。所以 input_tokens 只统计既没有从缓存读取、也没有写入缓存的部分;用 cache_read 除以 input_tokens,得到的是一个完全不同、也大得多的数字。Bedrock 的 Converse API 对自己的字段也有同样的说明:开启缓存后,inputTokens“只表示未缓存的输入 token”。
每次运行我们都报告两个数字。所有调用的命中率包含缓存过期后的第一次调用,而这次调用总是写入。第一次调用之后的命中率,则反映缓存填满后一段对话的成本。提示中有一部分对每个用户都一样(下文的第一个断点),所以在生产环境中,一个人的第一次调用可能读到别人的对话写入的内容,而只有所有调用的命中率能体现这一点。我们的测试只以一个人的身份运行,所以没有测到它。
生产基线来自 Foxl 对云端智能体的计费记录:上线以来 8 段对话共 19 个轮次,从缓存读取 35,054 个 token,写入 47,173 个,未缓存 72 个。35,054 / (35,054 + 47,173 + 72) 等于 42.6%。智能体写入的比读取的多:至少有 12,119 个 token(47,173 减去 35,054),约占它为缓存所付费用的四分之一,从来没有被读回过。
为什么聊天智能体会错过自己的缓存
Foxl 的中继是位于 Foxl 各个应用和 Bedrock 之间的服务器,它原本就会在每个 Claude 请求上放三个断点:最后一个工具上、系统提示上和最后一条用户消息上,都使用默认的五分钟 TTL。调用间隔很近时,它们都能命中。在一次回复 15 秒后发出的追问,读取了 3,616 个 token,写入了 44 个。
大的写入全都发生在超过五分钟的间隔之后。在上一条回复 26 分钟后发出的消息,或者在上一次聊天两小时后打开的聊天,都把整个前缀重新写了一遍,也就是约 3.6K token 的工具和系统提示。AWS 关于一小时缓存的指南描述的几乎正是这种情况:“在存储与某个用户的长时间聊天对话,并且你通常预计该用户可能不会在接下来 5 分钟内回复时”。
命中还会免费刷新条目(“每次使用缓存内容时,缓存都会刷新,不收取额外费用”)。因此,在工具循环里连续工作的智能体很少会碰到五分钟的限制,除非某一次调用或某个工具本身就超过五分钟。和人聊天时,限制会出现在轮次之间,而这样的聊天大部分时间恰恰都花在那里。
四个断点放在哪里
一个 Claude 请求最多可以带四个断点(Anthropic:“你最多可以定义 4 个缓存断点”;Bedrock 的表格中每个 Claude 模型也都是 4 个)。缓存的前缀按 tools、system、messages 的顺序读取,任何一处改动都会让它之后的所有内容失效。中继的断点全都是五分钟的,所以现在由云端智能体自己设置全部四个断点,每个都带上各自的 TTL。对于已经带有断点的请求,中继不会改动,也不会再加自己的断点。
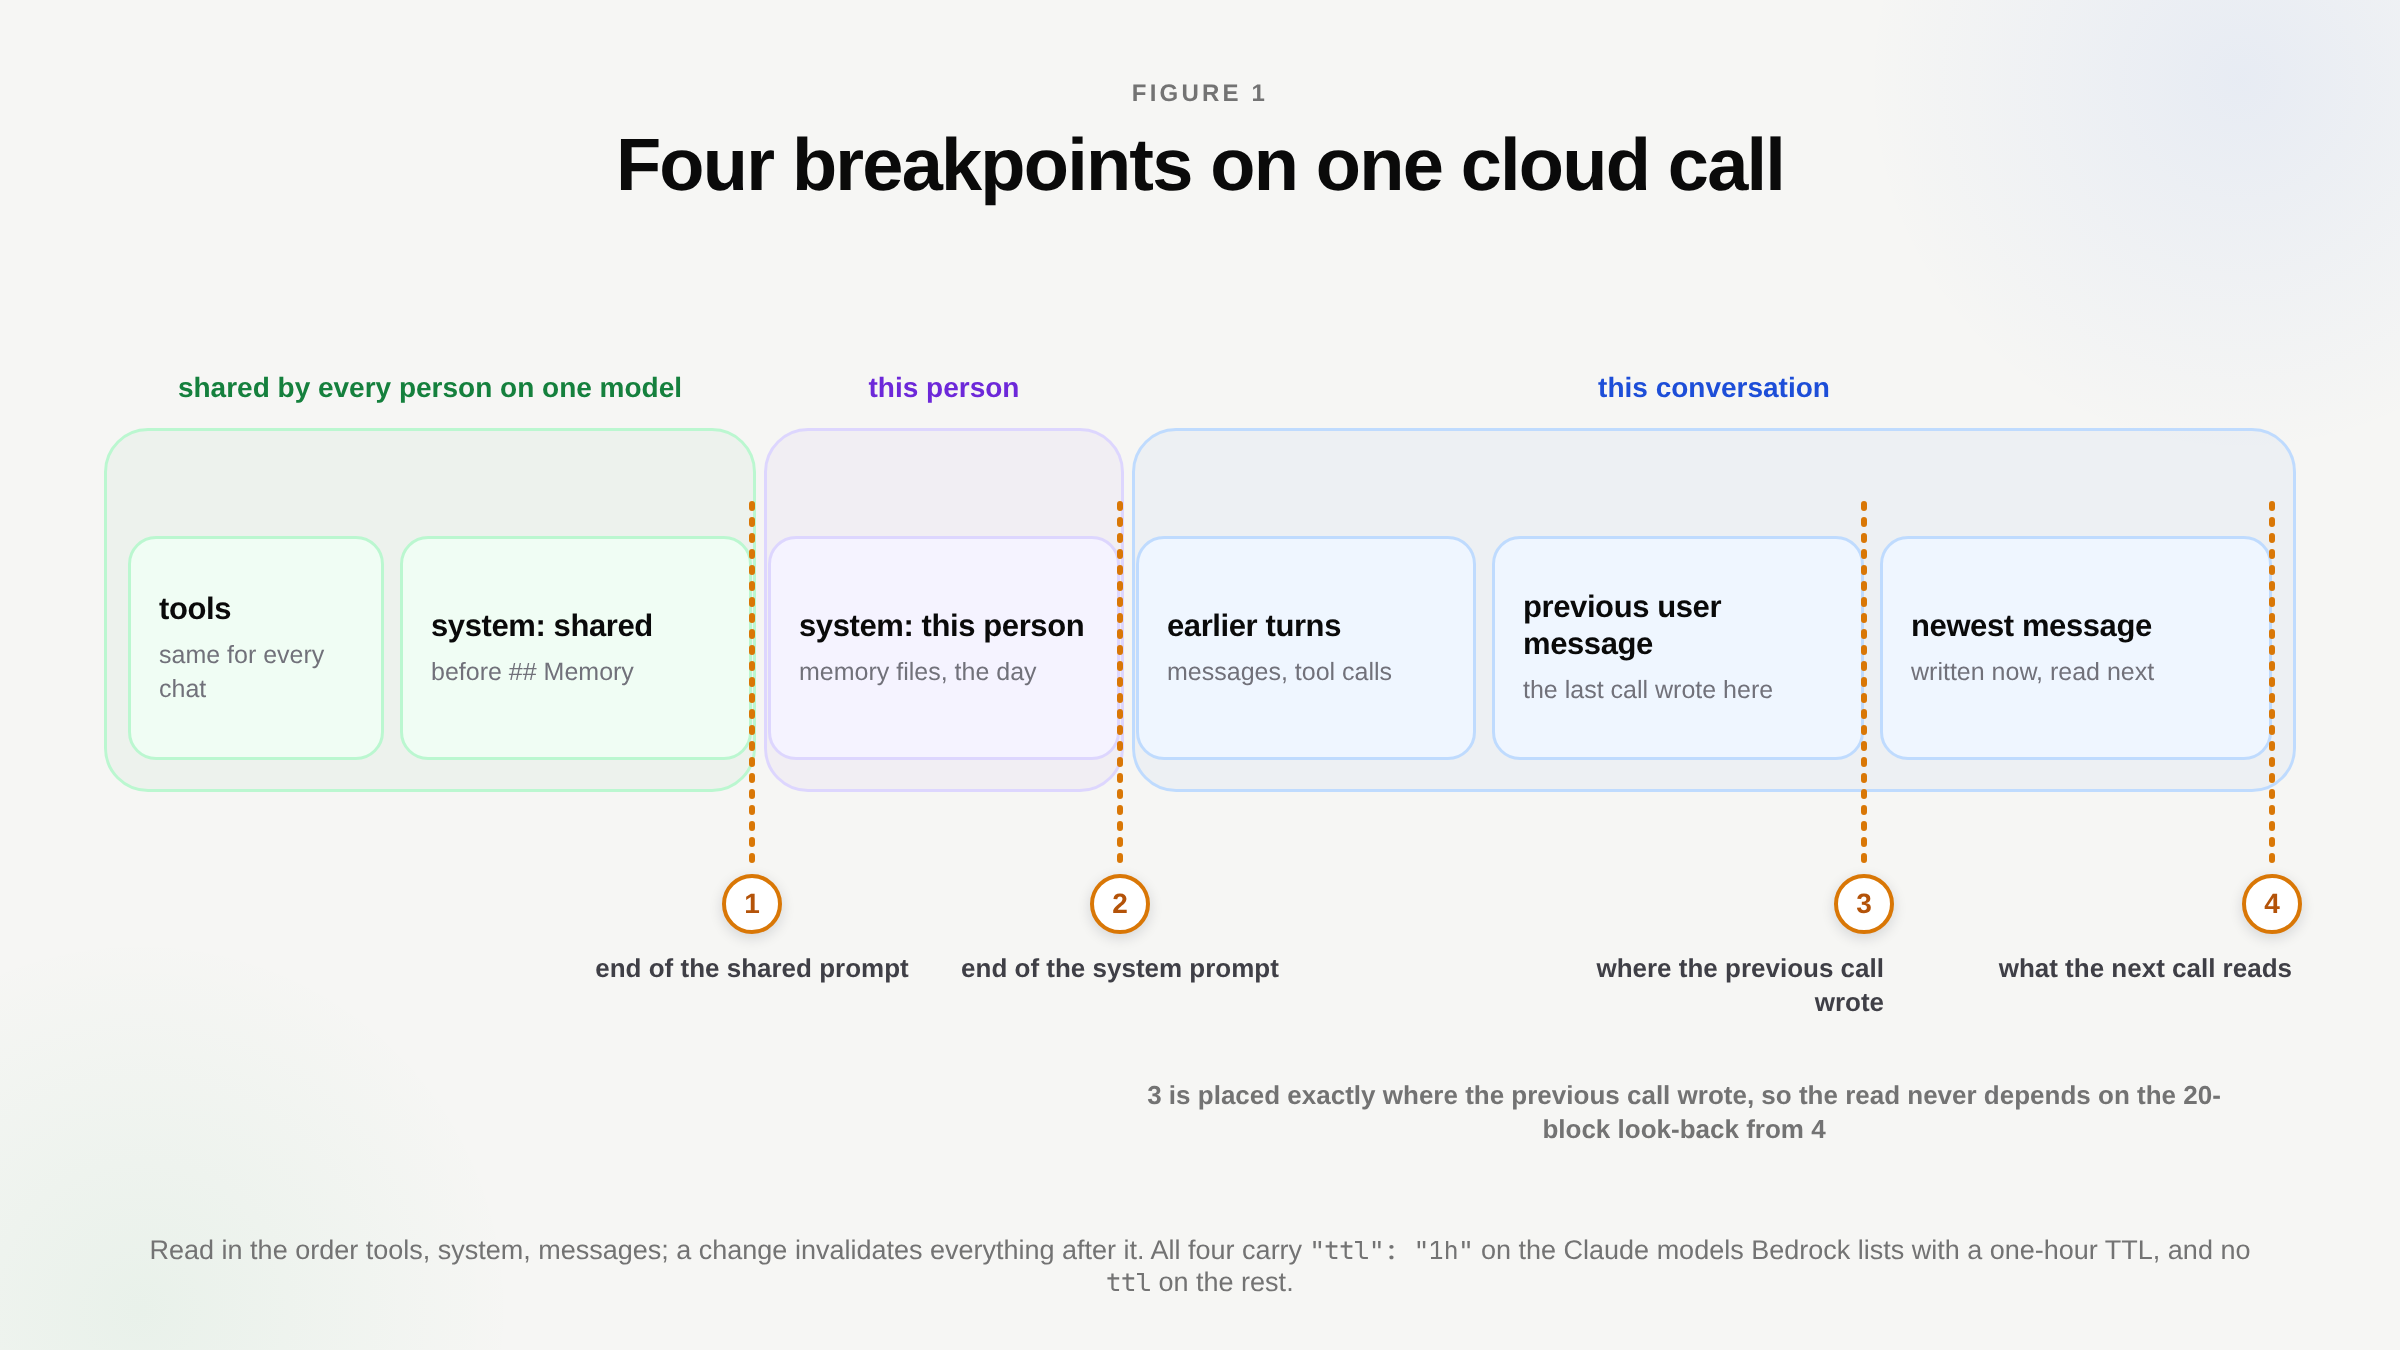
- 系统提示共享部分的末尾。我们在每个用户的记忆开始的地方,也就是
## Memory标题处,把系统提示一分为二。工具以及这个标题之上的所有内容(智能体是谁、它在云端能做什么不能做什么),对同一个模型上每个人的每段对话都完全一样,所以任何人新开的聊天,一开始就能读取它们。 - 系统提示的末尾。第二个断点加上了这个人自己的记忆和一行日期。日期行只写日期,不写时间,所以不会在两次调用之间改变前缀。
- 上一条用户消息中最后一个可缓存的块。这里正是上一次调用写入的位置,所以能否读到它,不取决于 API 的回溯。没有这个断点时,API 会从最新的断点开始往回寻找更早的缓存条目,但只找到一定范围(“回溯窗口为 20 个块”),一个包含大量工具调用的轮次可能会把上一次的写入挤出这个范围。这些块怎么计数,取决于你在哪里调用 Claude:Anthropic 的 API 把一串连续的
tool_use或tool_result块算作一个位置,而 Bedrock 的文档只写了“大约 20 个内容块”,没有这样的例外。 - 最新消息中最后一个可缓存的块。这就是下一次调用将要读取的写入。
四个断点都使用相同的 TTL。只要所有一小时条目都排在前面,Bedrock 就接受同一个请求里同时出现两种 TTL(“1 小时的缓存条目必须出现在任何 5 分钟的缓存条目之前”);四个断点用同一个 TTL,就能在不做任何检查的情况下始终满足这一条。断点只放在 text、image、document、tool_use 和 tool_result 块上,这些正是 Anthropic 列为可缓存的消息内容。
一小时 TTL 只用于 Bedrock 表格中标为“Supported TTL: 5 minutes, 1 hour”的 Claude 模型。Bedrock 警告说,把这个字段发给只支持五分钟的模型“可能会导致 ValidationException”,所以其他 Claude 模型得到的是同样的四个断点,但不带 ttl。Bedrock 上的 GPT-5.6 及之后的模型我们不做处理:它们使用自己的 prompt_cache_breakpoint 字段,而且按同一页面的说法,有“30 分钟的最短 TTL”。
// the marker on each of the four blocks, on a model that takes it
"cache_control": { "type": "ephemeral", "ttl": "1h" }
还有一个最小长度要求。只有当检查点之前的全部内容达到模型的最小长度时,Bedrock 才会缓存这个检查点:5.5 系列模型是 512 个 token,一些较早的模型是 1,024 或 4,096 个。低于最小长度时,“推理仍会成功,但你的前缀不会被缓存”。在最小长度为 4,096 个 token 的模型上,一个 3.6K token 的提示会让工具和系统提示处的断点什么都缓存不了,直到对话本身把前缀撑过最小长度为止,所以请为你提供的每个模型查一下这张表。
一小时缓存会得不偿失吗?
按 Anthropic 的价格,五分钟写入是基础输入价格的 1.25 倍,一小时写入是 2 倍,读取是 0.1 倍(Opus 5.5 和 Sonnet 5.5 上是 0.05 倍)。所以一小时写入比五分钟写入多出基础价格的 0.75 倍。这笔溢价,前缀部分每小时付一次,每次调用新增的内容则每次都要付。作为交换,超过五分钟的间隔不再以 1.25 倍的价格重写整个前缀,而是直接读取前缀。
为了测量这一点,我们让云端智能体的生产代码通过本地运行的一份中继,调用真实的 Bedrock。场景是一段四个轮次的聊天(用工具跟踪的计划、一次追问、一次保存文件、6.5 分钟后再问一个关于第一轮的问题),之后再开一段新聊天。因为使用工具的轮次会产生不止一次调用,所以总共是对 Sonnet 5.5 的九次模型调用。用量从 Bedrock 返回的流中读取,成本一栏使用的是 Foxl 自己的 Sonnet 5.5 按 token 计价。
| 设置 | 缓存读取 | 缓存写入 | 命中率(全部 9 次) | 命中率(第 2-9 次) | 本次运行成本 |
|---|---|---|---|---|---|
| 五分钟(中继的断点) | 29,979 | 11,755 (5m) | 71.8% | 78.7% | $0.0538 |
| 一小时(四个断点) | 35,859 | 5,974 (1h) | 85.7% | 93.9% | $0.0494 |
| 一小时,外加记忆文件(见下文) | 177,347 | 20,108 (1h) | 89.8% | 98.6% | $0.1219 |
差异几乎全部来自 6.5 分钟间隔之后的那次调用。用五分钟条目时,它把 5,873 个 token 的前缀重新写了一遍;用一小时条目时,它读取了 5,750 个 token,只写入了 133 个,而且 Bedrock 把每次写入都报告为 ephemeral_1h_input_tokens,由此我们知道更长的 TTL 确实生效了,而不是被悄悄忽略。一小时运行比五分钟运行多读取了 5,880 个 token(35,859 减去 29,979),其中 5,750 个来自那一次调用,其余约 130 个来自断点位置的调整。这个场景里没有包含大量工具调用的轮次,而第三个断点正是为这种情况准备的。每次运行的未缓存输入都是 28 个 token。
五分钟设置在这次测试中是 71.8%,而在生产环境中只有 42.6%,原因是测试里只有一次 6.5 分钟的间隔,而生产环境的 19 个轮次分散在 8 段对话里,间隔有 26 分钟,也有两小时。同样的代码在不同流量下得分差异很大,所以只应在同一场景的多次运行之间比较命中率。
没有这个间隔,结果就会反过来。从同一组测量中去掉它,五分钟设置就从不需要重写前缀,于是它更便宜:一小时运行的总成本高出约 23%,输入部分高出约 48%,因为它每次写入都付了两倍的基础价格,而五分钟之后没有任何调用把它们读回来。
对于你自己在 Sonnet 5.5 或 Opus 5.5 上的流量,比较这两个数字:
- 节省:每个原本会因间隔而被迫重写的前缀 token,可以节省约 1.2 倍的基础价格(1.25 的重写变成了 0.05 的读取)。
- 溢价:这一小时里写入的每个 token,都要多付 0.75 倍的基础价格(2 而不是 1.25)。
节省更大时,一小时 TTL 就更划算。中间有五到六十分钟停顿的聊天通常能做到,一小时内开始的第二段聊天也一样;五分钟内就结束、这一小时里也没有别的调用的聊天则不行。对于用手机回复的人,我们选择了一小时。对于调用间隔只有几秒的智能体,五分钟是更好的设置。
如果你在每次调用前预留额度,TTL 也会改变预留的金额。Foxl 的中继按最坏情况预留,所以请求一小时 TTL 的请求会按一小时写入的费率预留。这个费率(2 倍)是五分钟费率(1.25 倍)的 1.6 倍,所以一次带 100K token 上下文的 Sonnet 5.5 调用,会为输入预留约 $0.40,而不是 $0.25。实际扣费仍然是这次调用的用量,但余额快用完时,可能会提前一次调用被拒绝。
上限由什么决定
由新内容决定。每条新的用户消息和每条回复,都要先写入缓存一次,之后才能被读取,所以无论断点怎么放,一次调用都读不到它自己新加的 token。在一小时运行中,第一次调用什么也没读到,因为上一次运行的五分钟条目已经过期,所以读取的全部 35,859 个 token 都来自第 2 到第 9 次调用:占这些调用约 38,200 个输入 token 的 93.9%。剩下的约 2,300 个是这次运行中的新消息和回复,因此 93.9% 就是这个场景的上限。聊天越长,每个新 token 携带的历史就越多,所以上限也越高。
更大的稳定前缀也会提高这个比例,但不会让任何东西变便宜。我们是在云端智能体新增一个选项、可以带上用户的记忆文件时看到这一点的。记忆文件是 Foxl 桌面应用放进自己提示里的四个 Markdown 文件(SOUL.md、USER.md、MEMORY.md 和 AGENTS.md)。手机或浏览器在电脑连接期间复制这些文件,用和桌面端相同的代码裁剪,再随每条云端消息一起发送。一组真实的此类文件按这种方式裁剪后约为 41K 个字符,每次调用大约 14K 个输入 token;第三次运行使用的是同样大小的测试文件。
在那次运行中,第一次调用写入了这个人提示中的 17,619 个 token,之后的每次调用都读取它们,第一次调用之后的命中率达到 98.6%。但由于提示大了好几倍,这次运行的成本是 $0.1219,而前一种设置只要 $0.0494;如果没有缓存,同样的九次调用要花 $0.4187。它在三次运行中命中率最高,账单也最大,这就是为什么我们报告的每个命中率旁边都附上了成本。
我们还没测量的
- 改动后的生产环境。截至 2026-10-23,改动部署后生产环境中还没有运行过任何云端轮次,所以 42.6% 是唯一的生产数据,改动后的数据都来自本地中继对真实 Bedrock 的调用。
- 其他模型。我们只跑了 Sonnet 5.5。其他获得一小时 TTL 的 Claude 模型,依据的是 Bedrock 的表格,Opus 5.5 还有一次之前通过我们中继做的测量。
- 其他场景。只有一种模式下的九次调用,其中没有包含大量工具调用的轮次。闲置超过一小时的聊天会再次支付第一次写入的费用,而一小时是两家提供商为 Claude 提供的最长 TTL。
如果你自己也在运行 Claude 智能体,命中率是最省事的检查项。把每次调用的三个计数器加起来,用读取量除以全部输入,然后看看每次写入大段前缀的调用之前发生了什么。如果它前面是一段超过五分钟的间隔,一小时 TTL 就能解决,这个场景几乎全部的提升都来自这里。如果它前面是几秒前的一次调用,那么要么两次调用之间前缀变了,要么上一次写入超出了回溯范围,而后者正是第三个断点要防止的。之前有一篇文章介绍了如何让子智能体沿用父智能体的缓存,这是同一条前缀规则在单个轮次内的应用。