클라우드 에이전트가 프롬프트 캐시를 놓친 이유와 1시간 TTL로 달라진 점
Foxl의 클라우드 에이전트는 처음 19번의 실서비스 턴에서 입력의 42.6%를 프롬프트 캐시에서 읽었어요. 큰 캐시 쓰기는 모두 캐시 수명 5분보다 오래 쉰 뒤에 나왔어요. 1시간 TTL을 주자 9번 호출 세션의 적중률이 71.8%에서 85.7%로(첫 호출 뒤로는 93.9%) 오르고 총비용은 8% 줄었어요. 대신 5분 안에 끝나는 대화는 23%쯤 더 들어요. 적중률을 재는 법, breakpoint 네 개를 두는 자리, 1시간 TTL이 이득인 조건, 적중률의 천장을 정리했어요.
이 페이지에서
프롬프트 캐시 적중률은 호출 한 번의 입력 토큰 가운데 캐시에서 읽은 비율이에요. 식으로 쓰면 cache_read / (캐시를 안 거친 입력 + cache_read + cache_write)예요. 이 글의 내용은 Anthropic이든 Amazon Bedrock이든 Messages API로 Claude를 부르는 에이전트라면 어디에나 적용돼요. 예로 드는 건 Foxl Agent의 클라우드 버전(원격 채팅)이에요. 컴퓨터가 꺼져 있을 때 휴대폰이나 웹에서 보낸 채팅에 대신 답하는 에이전트인데, 처음 19번의 실서비스 턴에서 입력의 42.6%를 캐시에서 읽었어요. 큰 캐시 쓰기는 모두 원인이 같았어요. 캐시 항목은 5분만 남는데, 사람은 그보다 늦게 답하거든요.
그래서 캐시 항목의 수명을 1시간으로 늘리고, 호출 9번으로 된 시험 세션을 다시 쟀어요. 적중률은 71.8%에서 85.7%로 올랐어요. 언제나 캐시에 쓰는 첫 호출을 빼면 93.9%예요. 1시간짜리 캐시 쓰기는 기본 입력 가격의 두 배인데도, 세션 총비용은 8%, 입력 비용만 보면 15% 줄었어요. 긴 수명에도 대가는 있어요. 5분 안에 끝나는 대화는 캐시에 쓸 때마다 두 배를 내고 돌려받는 게 없어요. 같은 9번 호출을 쉬지 않고 했다고 치고 계산하면, 1시간 구성이 5분 구성보다 23%쯤 더 들어요. 이 변경은 Foxl v0.9.3-beta.5에 들어갔어요.
에이전트의 프롬프트 캐시 적중률은 어떻게 재나요?
먼저 용어 세 개예요. breakpoint는 요청의 블록 하나에 다는 cache_control 표시예요. 요청 처음부터 그 블록까지를 캐시해 달라는 뜻이고, 이 부분을 prefix라고 불러요. 캐시 항목은 TTL(남아 있는 시간, 기본 5분) 동안 남고, 같은 prefix로 시작하는 다음 요청은 그 부분을 다시 처리하지 않고 읽어요. Bedrock 문서는 breakpoint를 checkpoint라고 불러요.
Messages API 응답에는 입력 카운터가 세 개 있고, Anthropic 문서는 셋의 관계를 한 줄로 적어 둬요. total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokens. 그러니까 input_tokens는 캐시에서 읽지도, 캐시에 쓰지도 않은 부분일 뿐이에요. cache_read / input_tokens로 계산하면 엉뚱하게 큰 숫자가 나와요. Bedrock의 Converse API 문서에도 캐싱을 켜면 inputTokens에는 캐시를 거치지 않은 입력 토큰만 들어간다고 적혀 있어요.
저희는 실행마다 숫자를 두 개 적어요. 둘이 답하는 질문이 달라서예요. 전체 호출 적중률에는 캐시가 아직 없거나 만료된 뒤의 첫 호출이 들어가요. 이런 호출은 언제나 캐시에 써요. 첫 호출을 뺀 적중률은 캐시가 채워진 뒤 대화에 드는 비용을 보여 줘요. 프롬프트의 일부는 모든 사용자에게 똑같아서(아래 첫 번째 breakpoint), 실서비스에서는 한 사람의 첫 호출이 다른 사람의 대화가 캐시에 쓴 걸 읽을 수 있어요. 이건 전체 호출 쪽 숫자에만 드러나요. 아래에서 설명할 시험은 사용자 한 명으로만 돌렸으니, 이 부분은 재지 못했어요.
실서비스 기준값은 클라우드 에이전트의 과금 기록에서 구했어요. 출시 뒤 8개 대화의 19개 턴에서 캐시 읽기가 35,054토큰, 캐시 쓰기가 47,173토큰, 캐시를 안 거친 입력이 72토큰이었고, 적중률은 35,054 / (35,054 + 47,173 + 72)로 42.6%였어요. 읽은 것보다 캐시에 쓴 게 더 많았어요. 캐시에 쓴 47,173토큰에서 읽은 35,054토큰을 빼면, 적어도 12,119토큰은 한 번도 다시 읽히지 않았어요. 캐시에 쓰느라 낸 돈의 4분의 1쯤이에요.
채팅 에이전트는 왜 자기 캐시를 자꾸 놓치나요?
Foxl 앱과 Bedrock 사이에 있는 Foxl 서버(relay)는 이미 모든 Claude 요청에 breakpoint를 세 개씩 달고 있었어요. 마지막 도구, system 프롬프트, 마지막 사용자 메시지에 하나씩, 모두 기본값인 5분 TTL로요. 호출이 몰려 있을 때는 잘 적중했어요. 답장 15초 뒤에 보낸 후속 질문은 3,616토큰을 읽고 44토큰만 캐시에 썼어요.
큰 캐시 쓰기는 모두 5분보다 긴 쉬는 시간 뒤에 나왔어요. 앞 답장을 받고 26분 뒤에 보낸 메시지나, 마지막 대화 두 시간 뒤에 연 채팅은 prefix 전체, 그러니까 도구와 system 프롬프트 3.6K토큰쯤을 통째로 다시 캐시에 썼어요. 휴대폰을 쓰는 사람은 다음에 휴대폰을 볼 때 답해요. AWS 문서도 1시간 캐시가 맞는 경우로 거의 이 상황을 꼽아요. 사용자와 나눈 긴 대화를 저장해 두는데, 그 사용자가 5분 안에 답하지 않을 것 같을 때예요.
캐시는 적중할 때마다 추가 비용 없이 수명이 다시 늘어나요. 그래서 도구를 연달아 부르는 에이전트는 호출 하나나 도구 하나가 5분을 넘기지 않는 한 이 제한을 느낄 일이 거의 없어요. 사람과 나누는 채팅은 턴과 턴 사이에서 이 제한에 걸리는데, 채팅은 대부분의 시간을 바로 그 사이에서 보내요.
breakpoint 네 개는 어디에 두나요?
Claude 요청 하나에는 breakpoint를 4개까지 달 수 있어요. Anthropic 문서에 그렇게 나오고, Bedrock 표에도 모든 Claude 모델이 4개로 나와 있어요. 캐시된 prefix는 tools, system, messages 순서로 읽히고, 어느 한 곳이 바뀌면 그 뒤가 전부 무효가 돼요. relay가 다는 breakpoint는 모두 5분짜리였어요. 그래서 이제는 클라우드 에이전트가 TTL을 붙인 breakpoint 4개를 직접 달아요. relay는 원래부터 breakpoint가 이미 있는 요청에는 자기 것을 더하지 않아요.
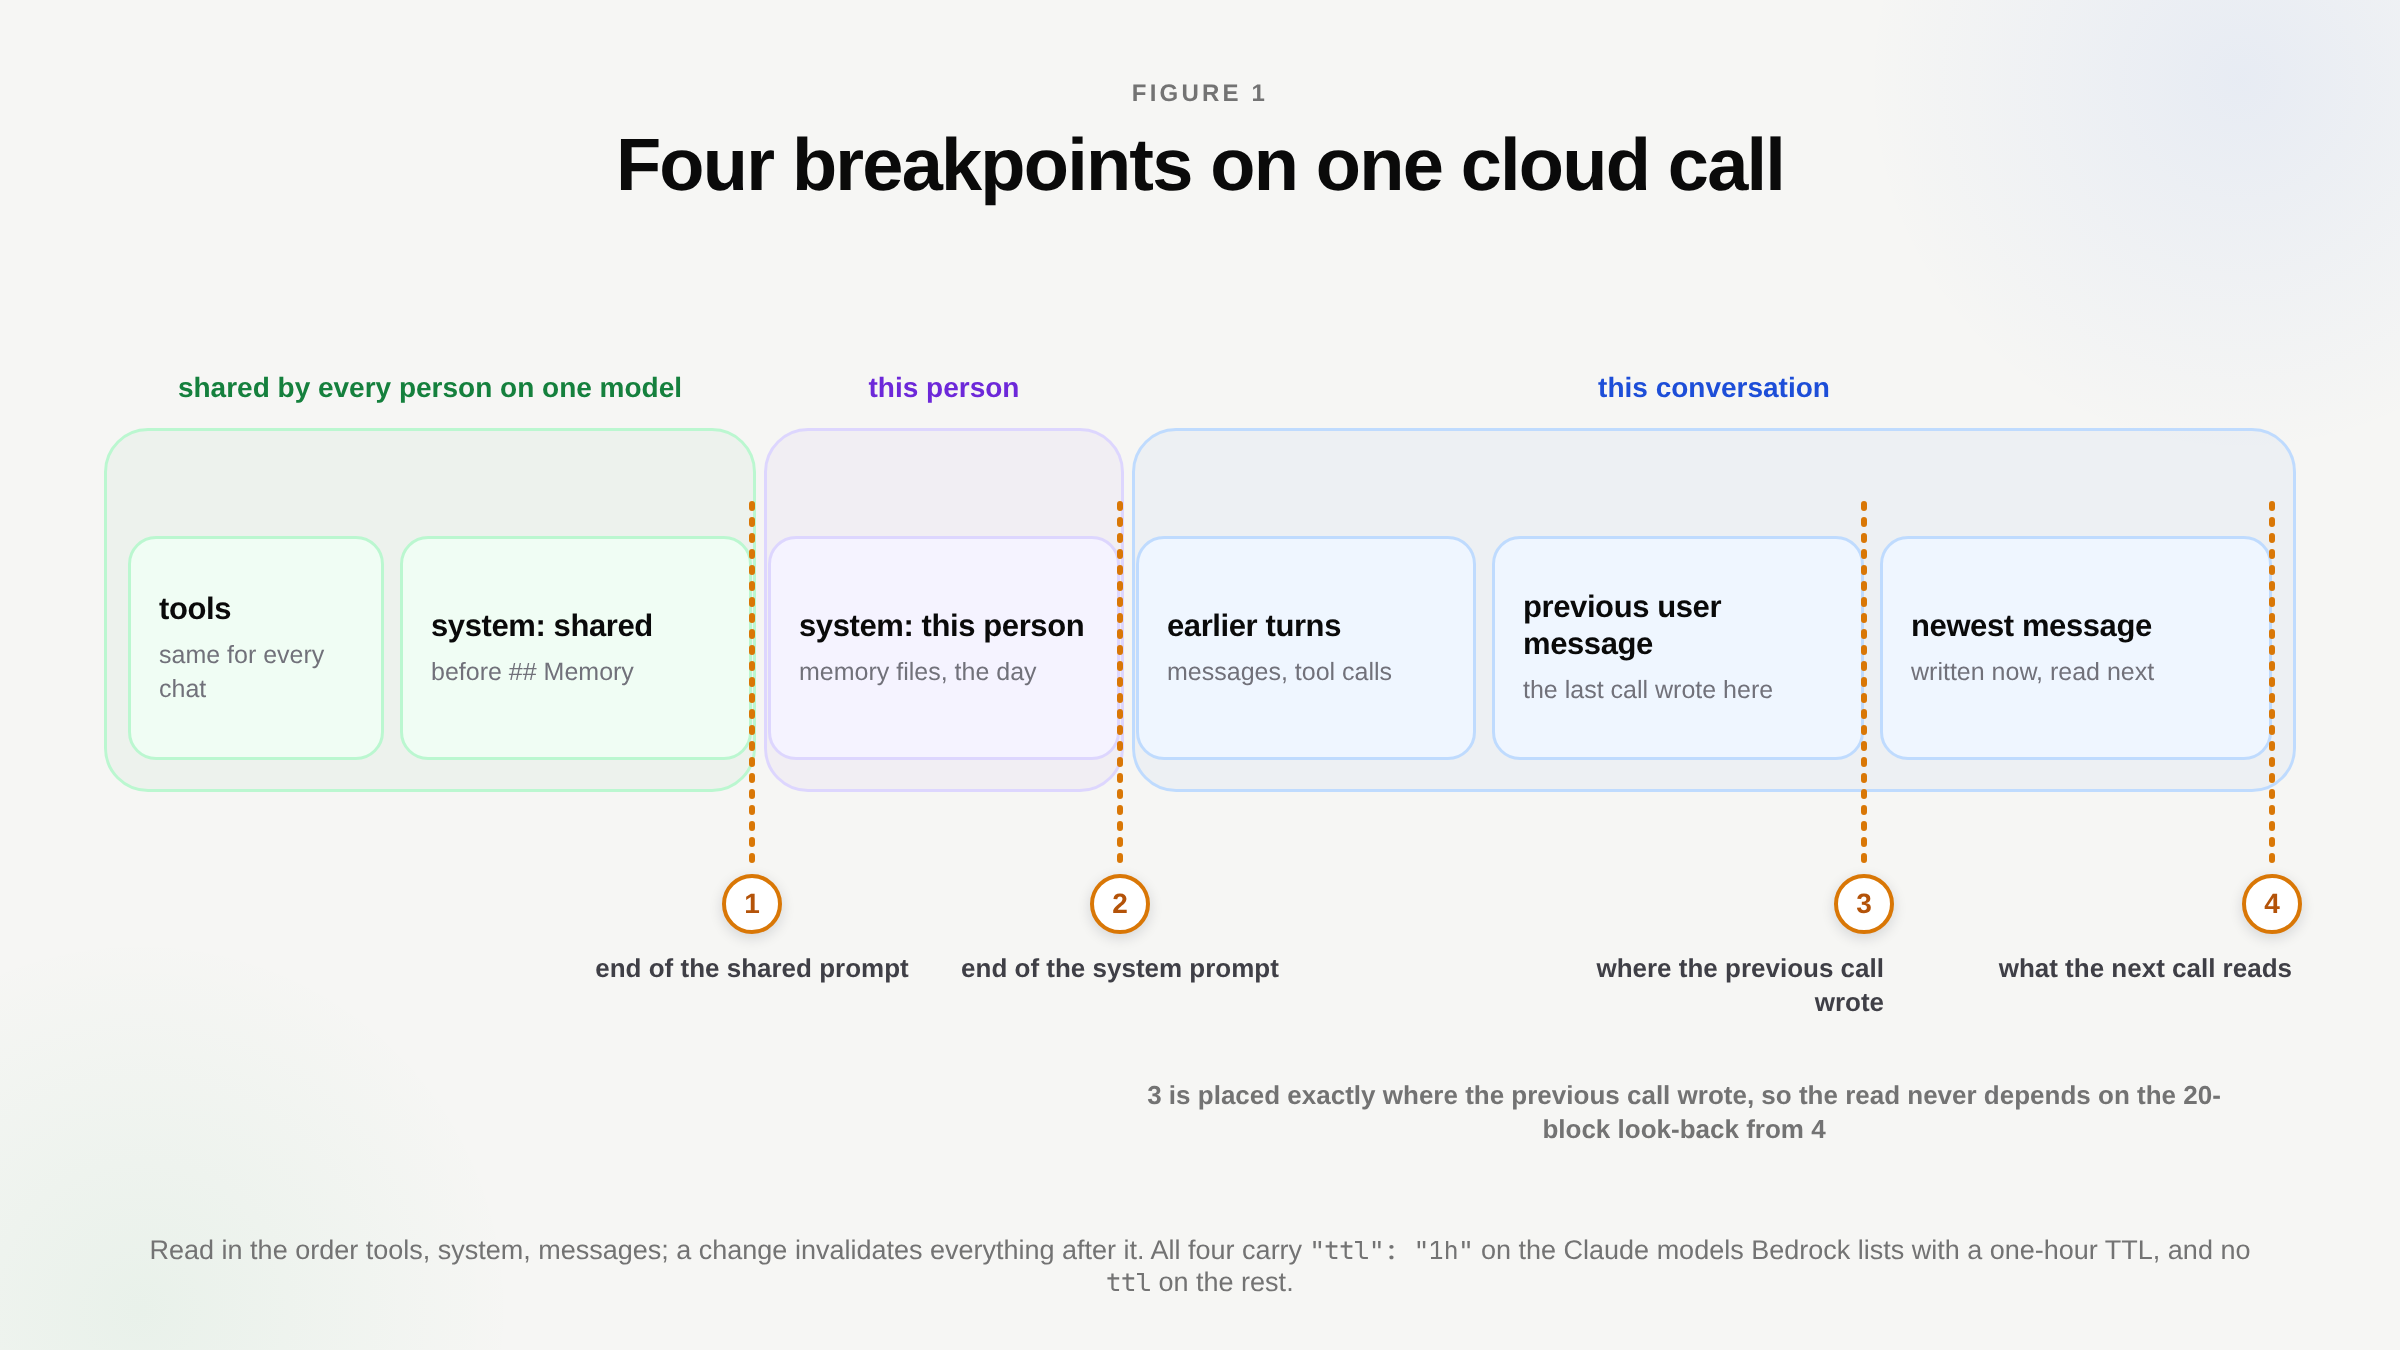
- system 프롬프트에서 공유되는 부분의 끝. 저희는 system 프롬프트를 사용자별 메모리가 시작되는
## Memory제목에서 둘로 나눠요. 도구 정의와 이 제목 앞부분 (에이전트가 누구인지, 클라우드에서 할 수 있는 일과 없는 일)은 같은 모델이라면 누구의 어떤 대화에서든 똑같아요. 그래서 누가 새 채팅을 열든 이 부분을 읽으며 시작해요. - system 프롬프트의 끝. 두 번째 breakpoint까지는 사용자의 메모리와 날짜 줄이 더해져요. 날짜 줄에는 시각이 아니라 날짜만 적어서, 호출 사이에 prefix가 바뀌지 않게 했어요.
- 직전 사용자 메시지의 마지막 캐시 가능 블록. 바로 이전 호출이 캐시에 쓴 자리예요. 이 표시가 없으면, 가장 새 breakpoint에서부터 거꾸로 올라가며 이전 캐시를 찾는 자동 탐색에 맡겨야 해요. 그런데 이 탐색은 정해진 칸 수까지만 봐요("The lookback window is 20 blocks"). 그래서 도구를 많이 부른 턴은 직전 호출이 쓴 자리를 탐색 범위 밖으로 밀어낼 수 있어요. 칸을 세는 방식은 Claude를 어디서 부르느냐에 따라 달라요. Anthropic API는 연달아 나오는
tool_use블록 묶음과tool_result블록 묶음을 각각 한 칸으로 세지만, Bedrock 문서에는 "approximately 20 content blocks"라고만 있고 이런 예외가 없어요. 직전 호출이 쓴 자리에 breakpoint를 두면 어느 규칙이든 상관없이 그 캐시를 읽을 수 있어요. - 가장 새 메시지의 마지막 캐시 가능 블록. 여기까지 캐시에 써 두면 다음 호출이 읽어요.
네 개 모두 같은 TTL을 써요. Bedrock은 1시간 항목이 모두 5분 항목보다 앞에 있기만 하면 한 요청 안에 두 TTL을 섞을 수 있게 해요. 넷 다 같은 TTL이면 이 조건은 저절로 지켜져요. breakpoint는 Anthropic이 캐시 가능하다고 적은 메시지 내용인 text, image, document, tool_use, tool_result 블록에만 달아요.
1시간 TTL은 Foxl이 제공하는 Claude 모델 가운데 Bedrock 표에 "Supported TTL: 5 minutes, 1 hour"로 적힌 모델에만 보내요. 5분만 되는 모델에 이 필드를 보내면 ValidationException이 날 수 있다고 Bedrock이 경고하거든요. 나머지 Claude 모델은 같은 breakpoint 네 개를 ttl 없이 받아요. Bedrock의 GPT-5.6 이후 모델은 손대지 않았어요. 이 모델들은 자기만의 prompt_cache_breakpoint 필드를 쓰고, 같은 문서에 따르면 TTL도 최소 30분이에요.
// 1시간을 받는 모델에서 네 블록 각각에 다는 표시
"cache_control": { "type": "ephemeral", "ttl": "1h" }
breakpoint가 캐시에 뭔가를 남기는지 정하는 규칙이 하나 더 있어요. Bedrock은 breakpoint 앞의 내용이 모델별 최소 토큰 수를 넘어야만 그 지점까지 캐시해요. 5.5 모델은 512토큰이고, 몇몇 이전 모델은 1,024나 4,096토큰이에요. 그보다 짧아도 요청은 성공하지만 prefix는 캐시되지 않아요. 그래서 최소가 4,096토큰인 모델이라면, 3.6K토큰짜리 도구와 system 프롬프트는 대화가 쌓여 prefix가 최소를 넘을 때까지 전혀 캐시되지 않아요. 쓰는 모델마다 표를 확인하세요.
1시간 캐시는 아끼는 것보다 더 들까요?
Anthropic 가격표로는 5분짜리 캐시 쓰기가 기본 입력 가격의 1.25배, 1시간짜리가 2배, 읽기가 0.1배(Opus 5.5와 Sonnet 5.5는 0.05배)예요. 그러니 TTL을 1시간으로 늘리면 캐시에 쓰는 토큰마다 기본 가격의 0.75배(2에서 1.25를 뺀 값)를 더 내요. 이 추가 비용은 prefix에는 한 시간에 한 번 붙지만, 호출마다 새로 들어오는 내용에는 매번 붙어요. 그 대가로 5분보다 오래 쉬어도 캐시가 남아 있어요. 원래는 prefix 전체를 1.25배로 다시 캐시에 썼을 텐데, 1시간 TTL에서는 읽기만 해요.
이걸 재려고, 클라우드 에이전트의 실서비스 코드를 로컬에 띄운 relay를 거쳐 실제 Bedrock에 보내는 스크립트(probe)를 돌렸어요. 시나리오는 네 턴짜리 채팅 하나(도구로 계획 관리, 후속 질문, 파일 저장, 6.5분 뒤 첫 턴에 대한 질문)와 새 채팅 하나예요. 도구를 쓰는 턴은 모델을 여러 번 부르기 때문에, 모두 합쳐 Sonnet 5.5 호출이 9번이에요. 사용량은 Bedrock이 돌려준 스트림에서 읽었고, 비용 열은 Foxl의 Sonnet 5.5 토큰 가격으로 계산했어요.
| 구성 | 캐시 읽기 | 캐시 쓰기 | 적중률(9번 전체) | 적중률(2-9번) | 실행 비용 |
|---|---|---|---|---|---|
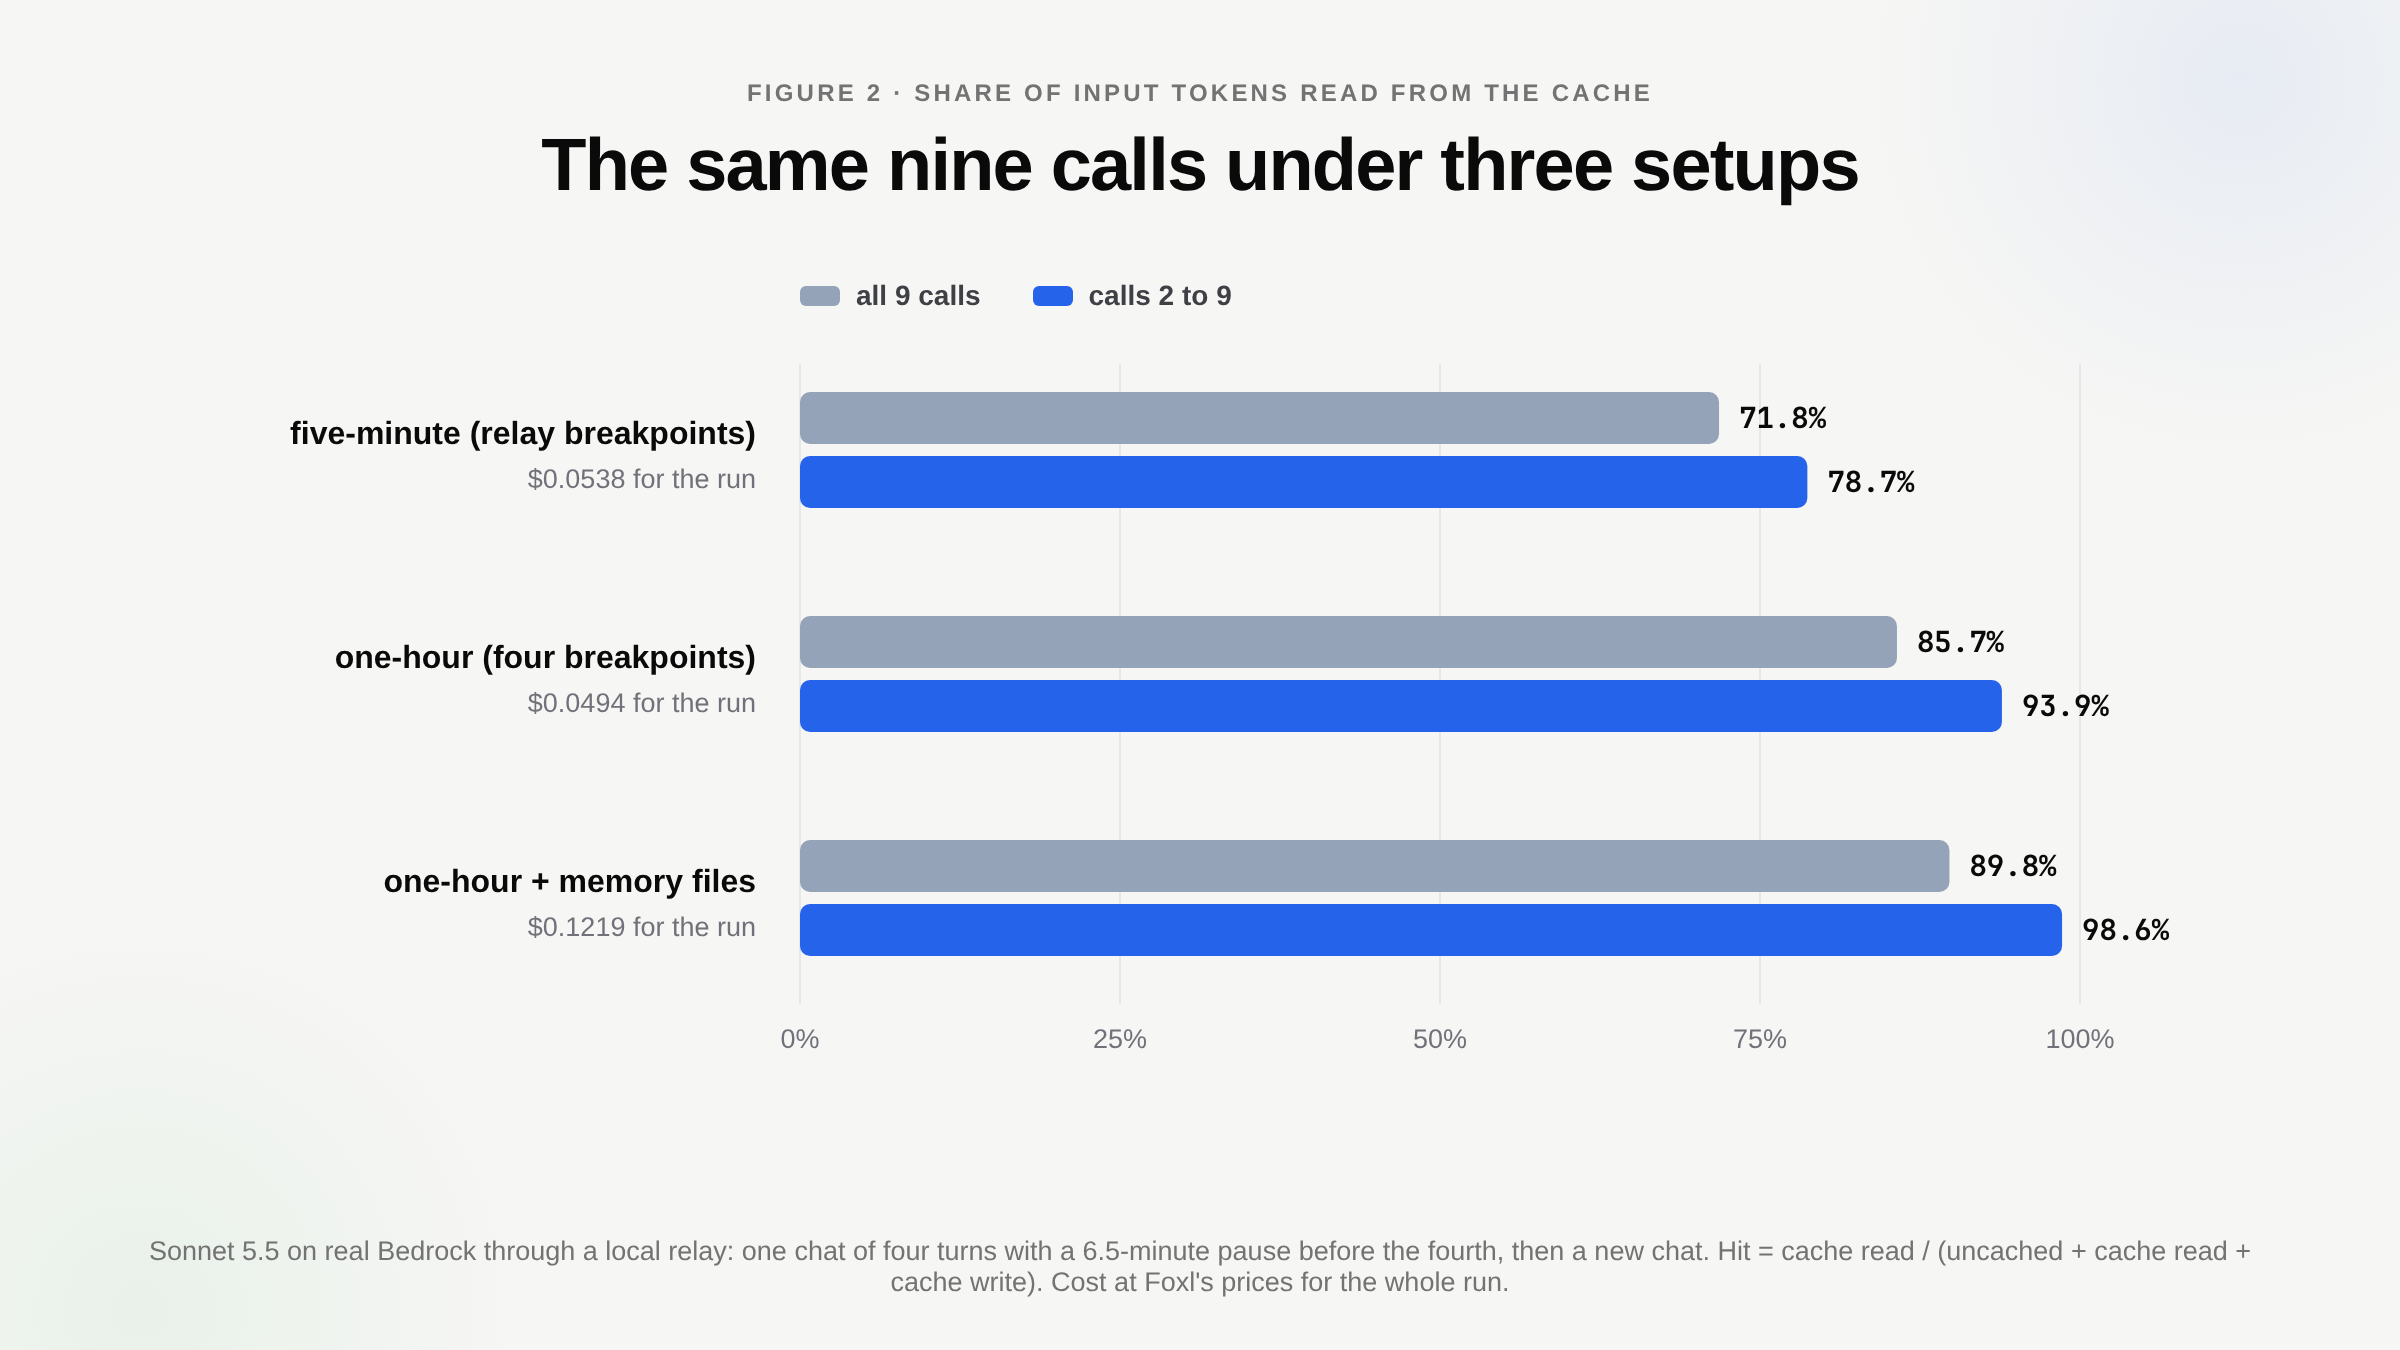
| 5분 구성(relay의 breakpoint) | 29,979 | 11,755 (5m) | 71.8% | 78.7% | $0.0538 |
| 1시간 구성(breakpoint 네 개) | 35,859 | 5,974 (1h) | 85.7% | 93.9% | $0.0494 |
| 1시간 구성 + 메모리 파일(아래에서 설명해요) | 177,347 | 20,108 (1h) | 89.8% | 98.6% | $0.1219 |
차이는 거의 전부 6.5분 쉰 뒤의 호출 하나에서 나와요. 5분 구성에서는 이 호출이 5,873토큰짜리 prefix를 캐시에 다시 썼어요. 1시간 구성에서는 5,750토큰을 읽고 133토큰만 썼어요. Bedrock이 캐시 쓰기를 모두 ephemeral_1h_input_tokens로 보고했으니, 1시간 TTL이 무시되지 않고 실제로 적용된 거예요.
1시간 구성의 캐시 읽기는 5분 구성보다 5,880토큰 많은데(35,859 - 29,979), 그중 5,750토큰이 이 호출 하나에서 나왔어요. breakpoint 위치를 옮긴 효과는 나머지 130토큰쯤이에요. 세 번째 breakpoint는 도구를 많이 부르는 턴을 위한 건데, 이 시나리오에는 그런 턴이 없었어요. 캐시를 안 거친 입력은 세 실행 모두 28토큰이었어요.
시험에서 5분 구성은 71.8%가 나왔는데 실서비스는 42.6%였어요. 시험에는 6.5분 쉬는 시간이 한 번뿐이지만, 실서비스의 19개 턴은 8개 대화에 흩어져 있고 그 사이에 26분, 두 시간씩 쉬었기 때문이에요. 같은 코드도 트래픽에 따라 점수가 크게 달라지니, 적중률은 같은 시나리오로 잰 것끼리만 비교하세요.
쉬는 시간이 없는 대화에서는 계산이 반대로 나와요. 같은 측정값에서 쉬는 시간을 빼면 5분 구성은 prefix를 다시 쓸 일이 없어서 더 싸요. 이때 1시간 구성은 총비용이 23%쯤, 입력 비용만 보면 48%쯤 더 들어요. 캐시 쓰기마다 두 배 가격을 냈는데, 5분이 지난 뒤 그걸 읽을 호출이 없으니까요.
내 트래픽에 맞는 쪽을 고르려면, Sonnet 5.5나 Opus 5.5 기준으로 두 숫자를 비교하면 돼요.
- 아끼는 쪽: 쉬는 시간 때문에 다시 캐시에 써야 했을 prefix는 토큰마다 기본 가격의 1.2배쯤을 아껴요(다시 쓰기 1.25배 대신 읽기 0.05배).
- 더 내는 쪽: 그 한 시간 동안 캐시에 쓴 모든 토큰에 기본 가격의 0.75배가 더 붙어요(1.25배 대신 2배).
아끼는 쪽이 더 크면 1시간 TTL이 이득이에요. 중간에 5분에서 60분쯤 쉬는 대화나, 한 시간 안에 새로 여는 채팅은 대개 이 선을 넘어요. 5분 안에 끝나고 그 한 시간 동안 다른 대화도 없는 채팅은 넘을 수 없어요. 저희는 휴대폰으로 답하는 사람을 생각해 1시간 TTL을 골랐어요. 호출이 몇 초 간격으로 오는 에이전트라면 5분을 그대로 두세요.
호출 전에 크레딧을 미리 잡아 두는 서비스라면, TTL은 잡아 두는 양도 바꿔요. Foxl의 relay는 최악의 경우를 가정해 크레딧을 잡는데, 1시간 TTL을 요청한 호출은 1시간 쓰기 가격(2배)으로 잡아요. 5분 쓰기 가격(1.25배)의 1.6배라서, 컨텍스트가 100K토큰인 Sonnet 5.5 호출이라면 입력으로 $0.25 대신 $0.40쯤을 잡아요. 실제 청구는 쓴 만큼만 되지만, 잔액이 거의 없으면 예전보다 호출 한 번 일찍 거절될 수 있어요.
적중률의 천장은 무엇이 정하나요?
새로 들어오는 내용이 정해요. 새 사용자 메시지와 새 답장은 읽히기 전에 한 번은 캐시에 써야 하니까, breakpoint를 어디에 두든 호출이 지금 더하는 토큰을 읽게 할 수는 없어요. 1시간 구성의 첫 호출은 아무것도 읽지 못했어요. 앞선 실행의 5분짜리 캐시가 이미 만료됐거든요. 그래서 읽은 35,859토큰은 모두 2번부터 9번 호출에서 나왔고, 이 호출들이 받은 입력 38,200토큰쯤의 93.9%예요. 나머지 2,300토큰쯤은 그 실행에서 새로 생긴 메시지와 답장이라, 93.9%가 이 시나리오의 천장이었어요. 어떤 breakpoint로도 더 올릴 수 없었어요. 대화가 길면 새 토큰 하나당 쌓인 기록이 많아서 천장이 더 높아요.
바뀌지 않는 prefix가 커져도 적중률은 올라가요. 다만 그렇다고 싸지지는 않아요. 클라우드 에이전트에 사용자의 메모리 파일을 읽는 옵션(설정 > 채팅 > 내 컴퓨터의 메모리 사용)이 생겼을 때 이걸 재 봤어요. 메모리 파일은 Foxl 데스크톱 앱이 자기 프롬프트에 넣는 Markdown 파일 네 개(SOUL.md, USER.md, MEMORY.md, AGENTS.md)예요. 휴대폰이나 브라우저가 컴퓨터와 연결된 동안 이 파일을 복사해 두고, 데스크톱 앱과 같은 코드로 잘라서 클라우드 메시지마다 함께 보내요. 실제 파일 한 벌을 그렇게 자르니 41K자쯤, 호출마다 입력 14K토큰쯤이었어요. 표의 세 번째 실행은 이와 크기가 같은 시험용 파일로 쟀어요.
세 번째 실행에서는 첫 호출이 사용자 프롬프트 17,619토큰을 캐시에 썼고, 이후 호출은 모두 이를 읽어서 첫 호출 뒤 적중률이 98.6%가 됐어요. 프롬프트가 몇 배로 커진 만큼 비용도 $0.0494에서 $0.1219로 늘었어요. 캐시가 없었다면 같은 9번 호출에 $0.4187이 들었을 거예요. 세 실행 가운데 적중률이 가장 높은데 비용도 가장 많이 들었어요. 그러니 적중률을 적을 때는 비용도 나란히 적으세요.
이 측정이 다루지 못한 건 무엇인가요?
- 변경 뒤의 실서비스 수치. 2026-10-23 기준으로 새 버전이 배포된 뒤 실서비스에서 클라우드 턴이 아직 한 번도 없어요. 그래서 실서비스 숫자는 42.6%뿐이고, 변경 뒤 숫자는 로컬 relay와 실제 Bedrock으로 잰 거예요.
- 다른 모델. 돌린 건 Sonnet 5.5뿐이에요. 1시간 TTL을 받는 나머지 Claude 모델의 근거는 Bedrock 표이고, Opus 5.5에는 예전에 relay로 잰 결과도 있어요.
- 다른 시나리오. 한 가지 흐름으로 된 9번 호출이고, 도구를 많이 부른 턴은 없었어요. 한 시간 넘게 쉬는 대화는 첫 캐시 쓰기를 다시 내요. Anthropic도 Bedrock도 Claude에 1시간보다 긴 TTL은 주지 않아요.
직접 Claude 에이전트를 돌린다면 가장 손쉬운 점검은 적중률 자체예요. 호출마다 카운터 세 개를 더하고, 전체 입력 가운데 읽기의 비율을 구한 뒤, 캐시에 큰 prefix를 쓴 호출이 있으면 그 직전에 무슨 일이 있었는지 보세요. 5분보다 긴 쉬는 시간 뒤였다면 1시간 TTL이 답이에요. 이 시나리오의 이득도 거의 다 거기서 나왔어요. 몇 초 전 호출 바로 뒤였다면 두 호출 사이에 prefix가 바뀌었거나 직전 호출이 쓴 자리가 탐색 범위 밖에 있었던 거예요. 세 번째 breakpoint가 막으려는 게 바로 이 경우예요. 같은 prefix 규칙을 한 턴 안에서 다룬 글도 있어요. subagent가 부모의 캐시를 이어 쓰게 한 이야기(영어)예요.
참고 자료
- Anthropic: Prompt cachingDocumentation
- Amazon Bedrock: Prompt cachingDocumentation
- Foxl v0.9.3-beta.5 릴리스Release