Por que o nosso agente na nuvem errava o cache de prompt, e o que um TTL de uma hora mudou
O nosso agente na nuvem leu 42,6% da entrada a partir do cache de prompt nos primeiros 19 turnos em produção, e toda gravação grande no cache veio depois de uma pausa maior que os cinco minutos de vida do cache. Um TTL de uma hora levou uma sessão medida de nove chamadas de 71,8% para 85,7% (93,9% depois da primeira chamada) e cortou o custo dela em 8%, mas um chat que termina em menos de cinco minutos paga cerca de 23% a mais. Como medimos, onde ficam os quatro breakpoints e quando o TTL mais longo vale a pena.
Nesta página
O agente na nuvem do Foxl responde aos chats que uma pessoa manda do celular ou da web enquanto o computador dela está desligado. Nos primeiros 19 turnos em produção, ele leu 42,6% da entrada a partir do cache de prompt. Quando olhamos as gravações grandes no cache, todas vieram depois de um intervalo de mais de cinco minutos, que é quanto tempo uma entrada de cache vive por padrão. Quem responde pelo celular muitas vezes demora mais do que isso.
Demos às entradas de cache do agente um tempo de vida de uma hora e rodamos de novo uma sessão medida de nove chamadas. A taxa de acerto foi de 71,8% para 85,7%, ou 93,9% se você deixar de fora a primeira chamada, que sempre grava. A sessão custou 8% menos no total e 15% menos na entrada, mesmo que uma gravação de uma hora custe o dobro do preço base de entrada. Um chat que termina em menos de cinco minutos sai ao contrário: ele paga o dobro por cada gravação e nunca lê nenhuma de volta, e, sem a pausa, as mesmas nove chamadas custam cerca de 23% mais com a configuração de uma hora do que com a de cinco minutos. A mudança saiu no Foxl v0.9.3-beta.5, e o método vale para qualquer agente que chame o Claude pela Messages API, na Anthropic ou no Amazon Bedrock.
Como medir a taxa de acerto de um cache de prompt?
A taxa de acerto é a fatia dos tokens de entrada de uma chamada que o provedor leu do cache em vez de processar de novo: cache_read / (uncached input + cache_read + cache_write). O cache funciona com breakpoints. Um breakpoint de cache é um marcador cache_control num bloco da requisição, pedindo ao provedor que guarde em cache tudo até aquele bloco, o prefixo. A entrada vive pelo seu TTL (time to live, o tempo de vida), cinco minutos por padrão, e a próxima requisição que começar com o mesmo prefixo lê essa entrada em vez de pagar por ela de novo. O Bedrock chama os breakpoints de checkpoints.
Toda resposta da Messages API informa três contadores de entrada, e a página da Anthropic dá a relação entre eles: total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokens. Ou seja, input_tokens conta só o que não foi lido do cache nem gravado nele, e dividir cache_read por input_tokens dá outro número, bem maior. A Converse API do Bedrock documenta o mesmo para os próprios campos: com o cache ativado, inputTokens “representa apenas os tokens de entrada que não estão em cache”.
Informamos dois números para cada execução. A taxa de acerto em todas as chamadas inclui a primeira chamada depois que o cache expirou, que sempre grava. A taxa de acerto depois da primeira chamada mostra quanto custa uma conversa quando o cache dela já está preenchido. Parte do prompt é idêntica para todos os usuários (o primeiro breakpoint abaixo), então, em produção, a primeira chamada de uma pessoa pode ler o que a conversa de outra gravou, e só o número de todas as chamadas consegue mostrar isso. Nosso teste rodou como uma única pessoa, então não mede esse efeito.
A linha de base de produção vem dos registros de cobrança do Foxl para o agente na nuvem: 19 turnos em 8 conversas desde o lançamento, com 35.054 tokens lidos do cache, 47.173 gravados e 72 fora do cache. 35.054 / (35.054 + 47.173 + 72) dá 42,6%. O agente gravou mais do que leu: pelo menos 12.119 tokens (47.173 menos 35.054), cerca de um quarto do que ele pagou para pôr em cache, nunca foram lidos de volta.
Por que um agente de chat erra o próprio cache
O relay do Foxl, o servidor entre os apps do Foxl e o Bedrock, já colocava três breakpoints em toda requisição ao Claude: na última ferramenta, no prompt de sistema e na última mensagem do usuário, todos com o TTL padrão de cinco minutos. Quando as chamadas vinham próximas, elas acertavam. Uma pergunta de acompanhamento enviada 15 segundos depois de uma resposta leu 3.616 tokens e gravou 44.
As gravações grandes vieram todas depois de intervalos de mais de cinco minutos. Uma mensagem enviada 26 minutos depois da resposta anterior, ou um chat aberto duas horas depois do último, gravou o prefixo inteiro de novo, cerca de 3,6 mil tokens de ferramentas e prompt de sistema. A orientação da AWS para o cache de uma hora descreve quase exatamente esse caso: “ao armazenar uma longa conversa de chat com um usuário quando, em geral, você espera que esse usuário não responda nos próximos 5 minutos”.
Um acerto também renova a entrada de graça (“O cache é renovado sem custo adicional cada vez que o conteúdo em cache é usado”). Por isso, um agente que está num loop de ferramentas raramente esbarra no limite de cinco minutos, a não ser que uma única chamada ou ferramenta leve mais de cinco minutos. Um chat com uma pessoa esbarra nele entre os turnos, e é aí que esse tipo de chat passa a maior parte do tempo.
Onde ficam os quatro breakpoints
Uma requisição ao Claude pode ter no máximo quatro breakpoints (Anthropic: “Você pode definir até 4 breakpoints de cache”; o Bedrock informa 4 para cada modelo Claude da sua tabela). O prefixo em cache é lido na ordem tools, system, messages, e uma mudança em qualquer ponto invalida tudo o que vem depois. Os breakpoints do relay eram todos de cinco minutos, então agora o próprio agente na nuvem define os quatro, cada um com seu TTL. O relay não mexe numa requisição que já traz breakpoints e não acrescenta nenhum dele.
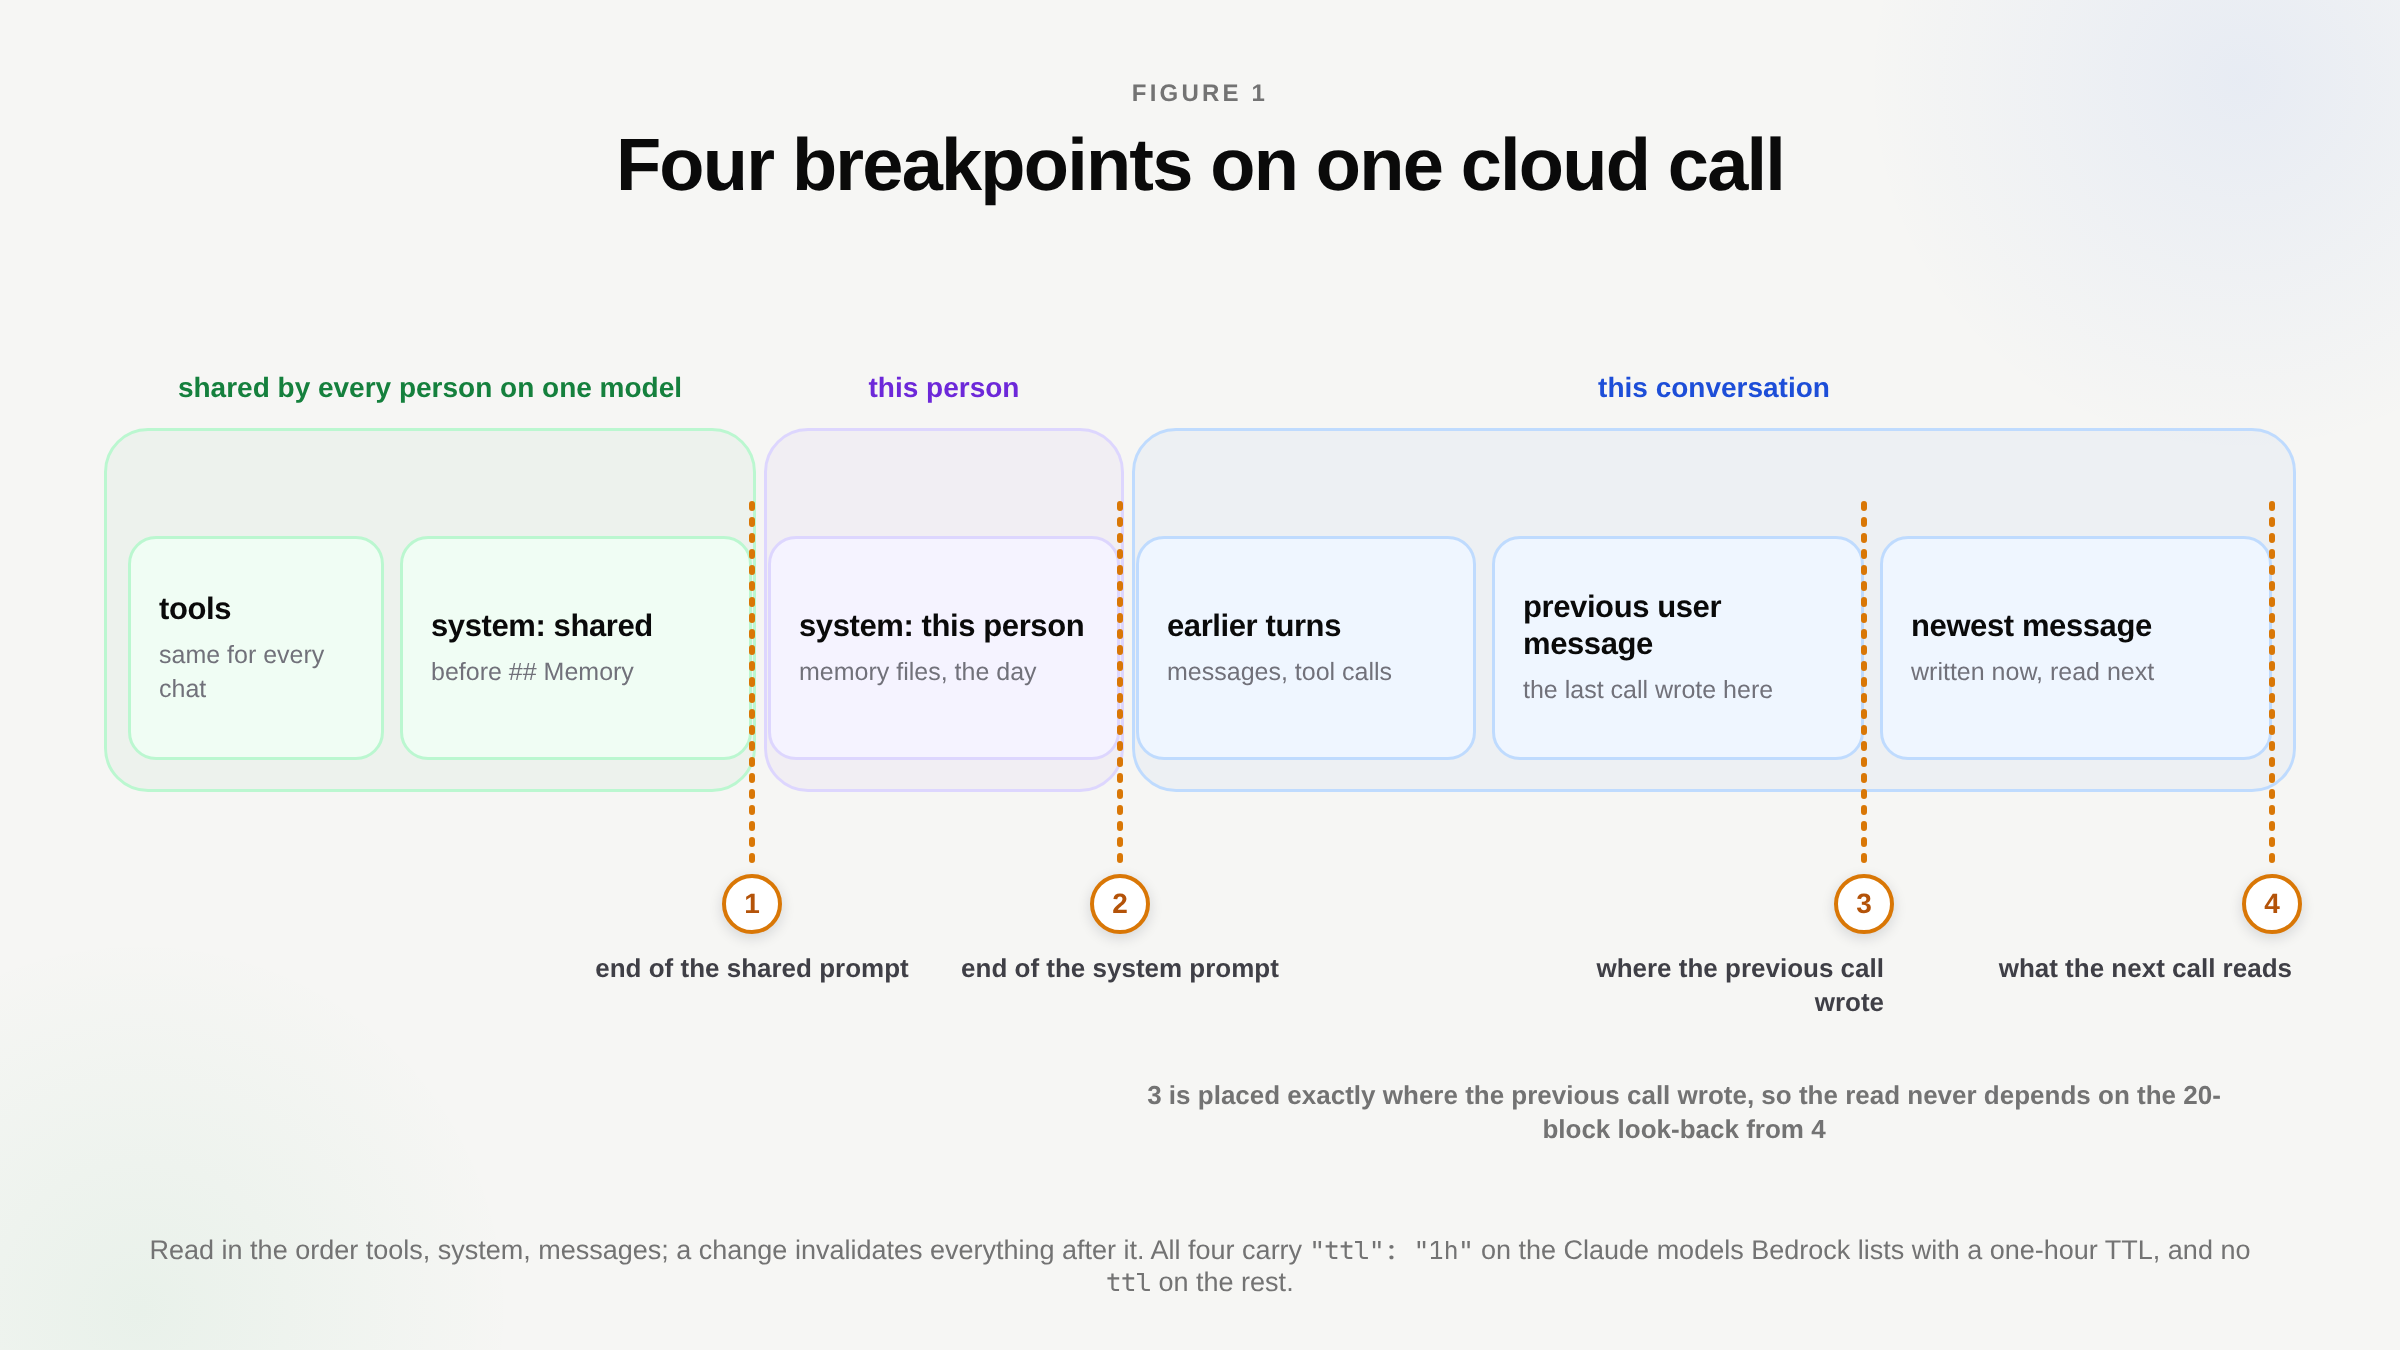
- O fim da parte compartilhada do prompt de sistema. Dividimos o nosso prompt de sistema onde começa a memória de cada usuário, num título
## Memory. As ferramentas e tudo o que fica acima desse título (quem é o agente, o que ele pode e não pode fazer na nuvem) são idênticos para todas as conversas de todas as pessoas num mesmo modelo, então um chat novinho, de qualquer pessoa, começa lendo essa parte. - O fim do prompt de sistema. O segundo breakpoint acrescenta a memória da própria pessoa e uma linha de data. A linha de data traz o dia, não a hora, então não muda o prefixo de uma chamada para outra.
- O último bloco que pode ir para o cache na mensagem anterior do usuário. É exatamente onde a chamada anterior gravou, então lê-lo não depende da busca para trás da API. Sem esse breakpoint, a API começa pelo mais recente e procura para trás uma entrada de cache anterior, mas só até certo ponto (“A janela de busca retroativa é de 20 blocos”), e um turno com muitas chamadas de ferramenta pode empurrar a gravação anterior para fora de alcance. A forma de contar esses blocos depende de onde você chama o Claude: a API da Anthropic conta uma sequência de blocos
tool_useoutool_resultconsecutivos como uma posição só, enquanto a página do Bedrock diz apenas “aproximadamente 20 blocos de conteúdo” e não faz essa exceção. - O último bloco que pode ir para o cache na mensagem mais recente. É a gravação que a próxima chamada vai ler.
Os quatro usam o mesmo TTL. O Bedrock aceita os dois TTLs numa mesma requisição desde que toda entrada de uma hora venha primeiro (“uma entrada de cache de 1 hora deve aparecer antes de qualquer entrada de cache de 5 minutos”), e um TTL só para os quatro garante isso sem verificação nenhuma. Os breakpoints vão apenas em blocos text, image, document, tool_use e tool_result, que é o conteúdo de mensagem que a Anthropic lista como cacheável.
O TTL de uma hora vai só para os modelos Claude que a tabela do Bedrock lista com “Supported TTL: 5 minutes, 1 hour”. O Bedrock avisa que enviar o campo para um modelo que só aceita cinco minutos “pode resultar numa ValidationException”, então os outros modelos Claude recebem os mesmos quatro breakpoints sem ttl. Deixamos de fora o GPT-5.6 e versões posteriores no Bedrock: eles usam o próprio campo prompt_cache_breakpoint e, segundo a mesma página, um “TTL mínimo de 30 minutos”.
// the marker on each of the four blocks, on a model that takes it
"cache_control": { "type": "ephemeral", "ttl": "1h" }
Também existe um tamanho mínimo. O Bedrock só põe um checkpoint em cache se tudo o que vem antes dele atingir o comprimento mínimo do modelo: 512 tokens nos modelos 5.5 e 1.024 ou 4.096 em alguns mais antigos. Abaixo do mínimo, “sua inferência ainda funciona, mas o seu prefixo não vai para o cache”. Num modelo com mínimo de 4.096 tokens, um prompt de 3,6 mil tokens deixa os breakpoints de ferramentas e de sistema sem guardar nada até que a própria conversa leve o prefixo além do mínimo, então confira a tabela para cada modelo que você oferece.
Um cache de uma hora custa mais do que economiza?
Pelos preços da Anthropic, uma gravação de cinco minutos custa 1,25 vez o preço base de entrada, uma gravação de uma hora custa 2 vezes e uma leitura custa 0,1 vez (0,05 vez no Opus 5.5 e no Sonnet 5.5). Uma gravação de uma hora custa, portanto, 0,75 vez o preço base a mais do que uma de cinco minutos. Você paga esse adicional sobre o prefixo uma vez por hora e sobre o conteúdo novo de cada chamada todas as vezes. Em troca, uma pausa de mais de cinco minutos não grava mais o prefixo inteiro de novo a 1,25 vez; o prefixo é lido.
Para medir, rodamos o código de produção do agente na nuvem por uma cópia local do nosso relay contra o Bedrock de verdade. O cenário é um chat de quatro turnos (um plano acompanhado com uma ferramenta, uma pergunta de acompanhamento, o salvamento de um arquivo e depois uma pergunta sobre o primeiro turno 6,5 minutos mais tarde), seguido de um chat novo. Isso dá nove chamadas ao modelo no Sonnet 5.5, já que um turno que usa ferramenta faz mais de uma chamada. O uso foi lido do stream que o Bedrock devolveu, e a coluna de custo usa os preços por token do próprio Foxl para o Sonnet 5.5.
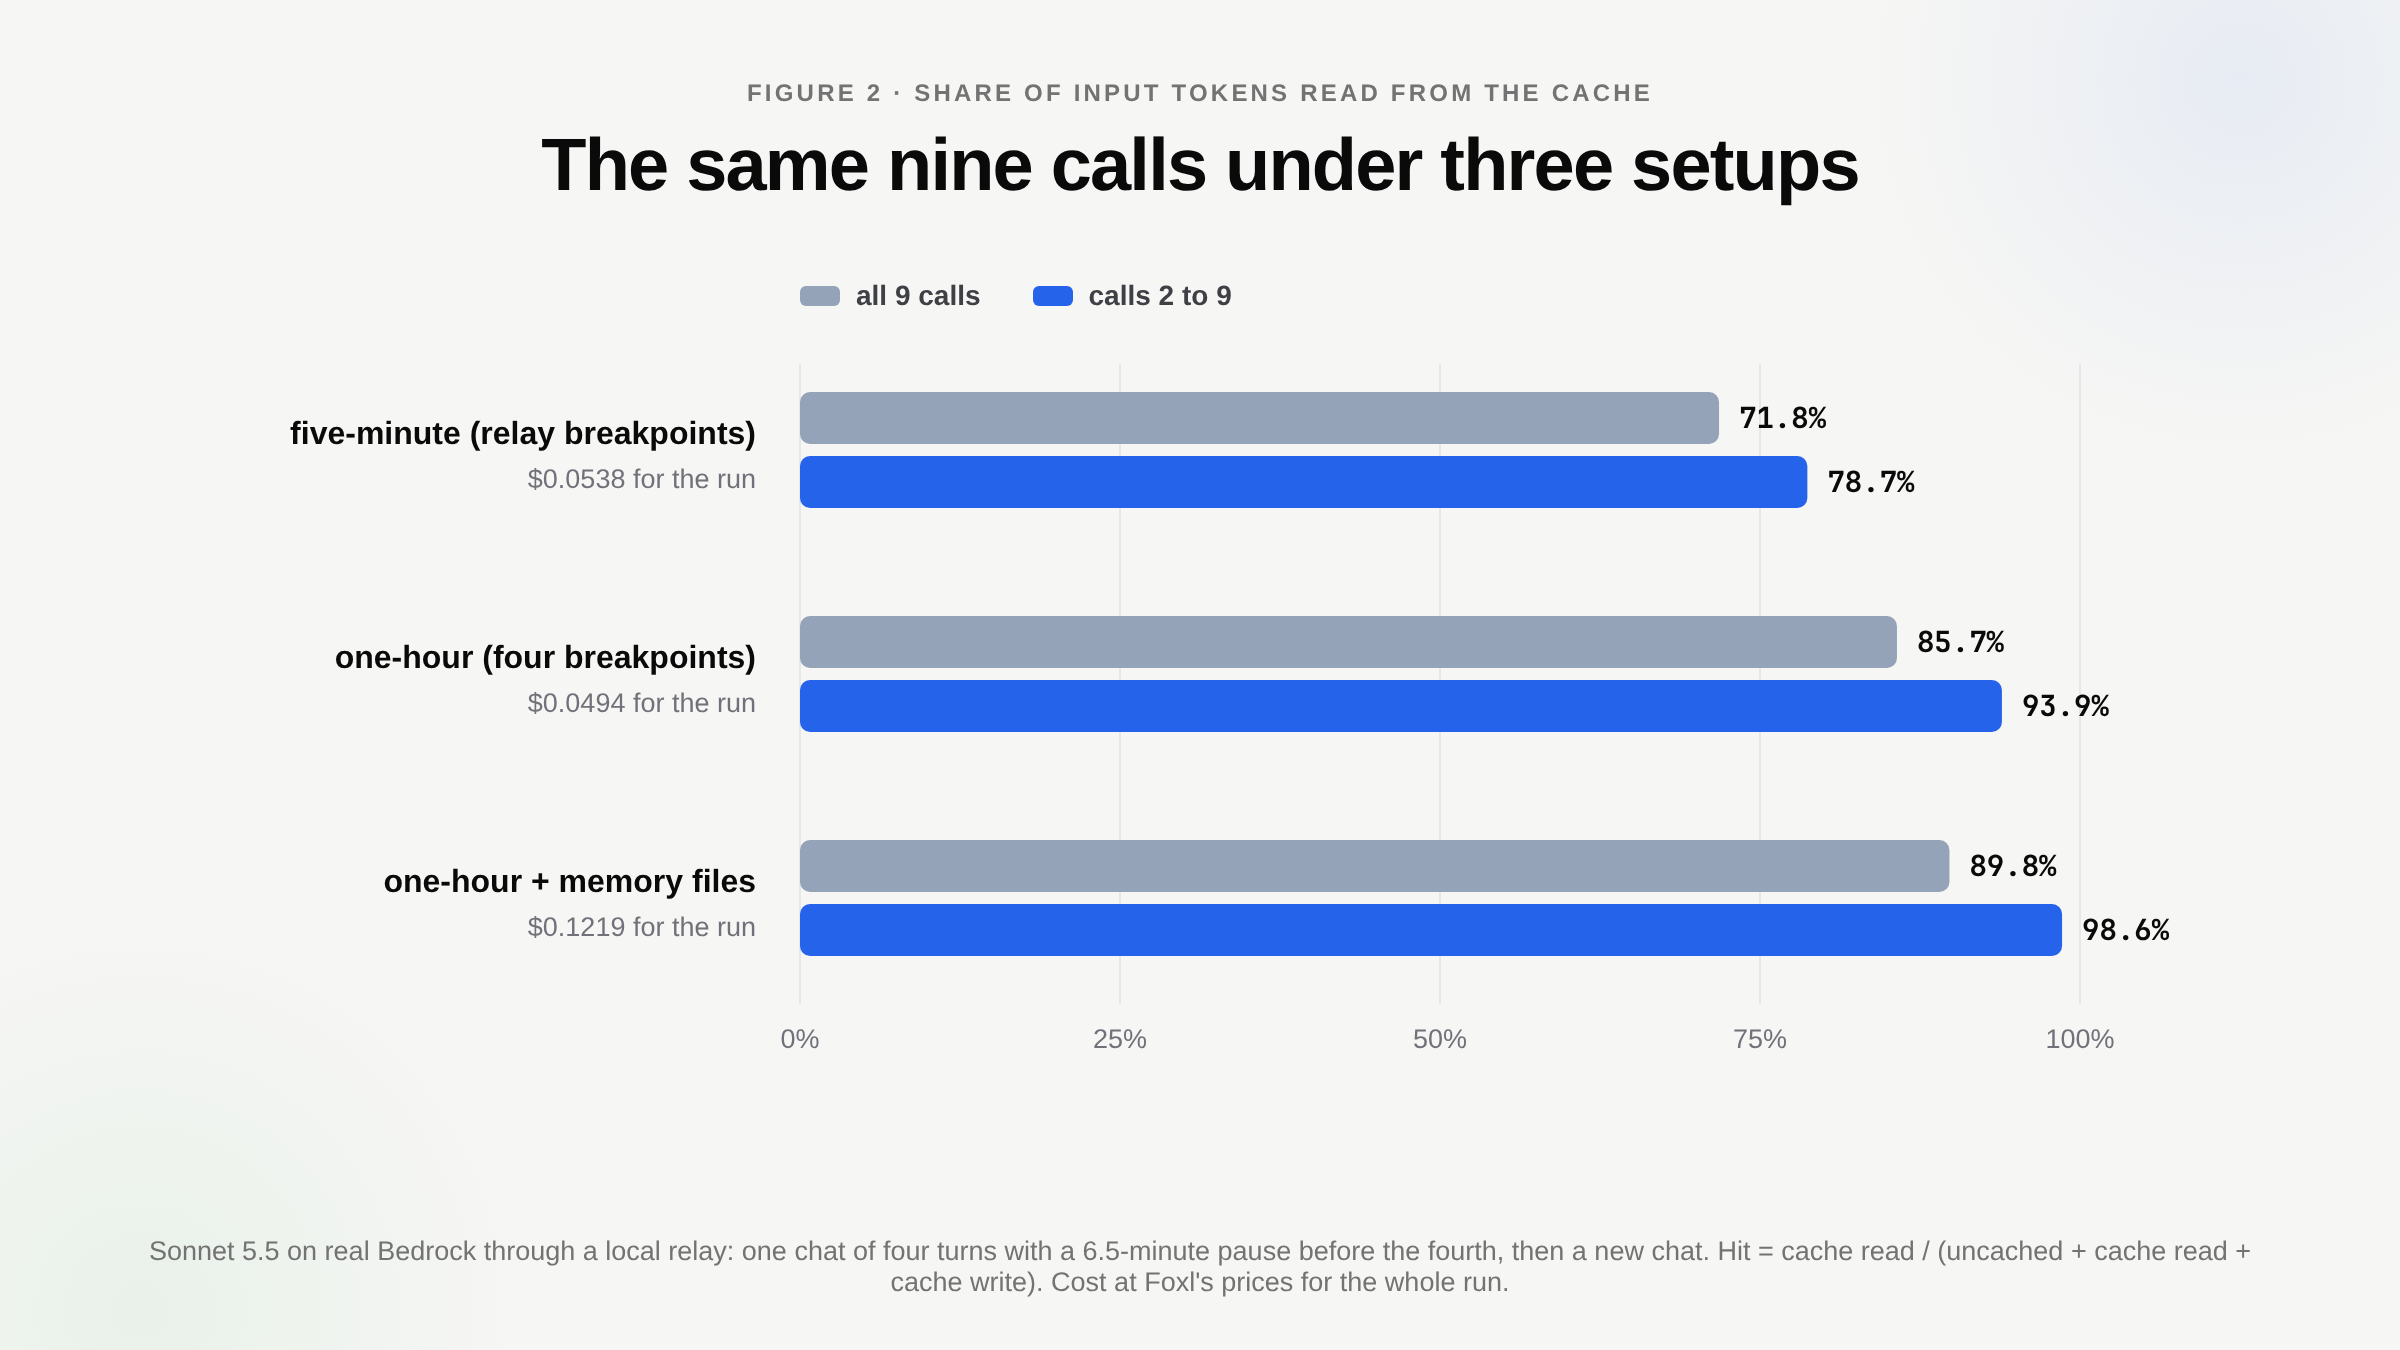
| configuração | leitura do cache | gravação no cache | acerto, as 9 chamadas | acerto, chamadas 2-9 | custo da execução |
|---|---|---|---|---|---|
| cinco minutos (os breakpoints do relay) | 29.979 | 11.755 (5 min) | 71,8% | 78,7% | US$ 0,0538 |
| uma hora (quatro breakpoints) | 35.859 | 5.974 (1 h) | 85,7% | 93,9% | US$ 0,0494 |
| uma hora, mais os arquivos de memória (explicado abaixo) | 177.347 | 20.108 (1 h) | 89,8% | 98,6% | US$ 0,1219 |
Quase toda a diferença está na chamada depois da pausa de 6,5 minutos. Com entradas de cinco minutos, ela gravou de novo o seu prefixo de 5.873 tokens. Com entradas de uma hora, leu 5.750 tokens e gravou 133, e o Bedrock informou cada gravação como ephemeral_1h_input_tokens: é assim que sabemos que o TTL mais longo foi aplicado e não ignorado em silêncio. A execução de uma hora leu 5.880 tokens a mais do que a de cinco minutos (35.859 menos 29.979); 5.750 deles vieram dessa única chamada e os outros 130 e poucos da mudança de lugar dos breakpoints. O cenário não teve nenhum turno com muitas chamadas de ferramenta, o caso para o qual existe o terceiro breakpoint. A entrada fora do cache foi de 28 tokens em todas as execuções.
A configuração de cinco minutos marca 71,8% neste teste contra 42,6% em produção porque o teste tem um único intervalo de 6,5 minutos, enquanto os 19 turnos de produção estavam espalhados por 8 conversas, com intervalos de 26 minutos e de duas horas. O mesmo código tem resultados muito diferentes com tráfegos diferentes, então só compare taxas de acerto entre execuções do mesmo cenário.
Sem a pausa, o resultado se inverte. Tire a pausa das mesmas medições e a configuração de cinco minutos nunca grava o prefixo de novo, então ela é a mais barata: a execução de uma hora custa cerca de 23% mais no total e cerca de 48% mais na entrada, porque pagou o dobro do preço base por cada gravação e nada depois do quinto minuto as leu de volta.
Para o seu próprio tráfego no Sonnet 5.5 ou no Opus 5.5, compare dois números:
- Economia: cada token de prefixo que uma pausa obrigaria você a gravar de novo economiza cerca de 1,2 vez o preço base (uma regravação a 1,25 substituída por uma leitura a 0,05).
- Adicional: cada token gravado naquela hora custa 0,75 vez o preço base a mais (2 em vez de 1,25).
O TTL de uma hora sai na frente quando a economia é maior. Um chat com uma pausa de cinco a sessenta minutos geralmente chega lá, assim como um segundo chat começado dentro da mesma hora; um chat que termina em menos de cinco minutos, sem mais nada naquela hora, não chega. Para pessoas que respondem pelo celular, escolhemos uma hora. Para um agente cujas chamadas chegam com segundos de diferença, cinco minutos é a melhor configuração.
Se você reserva crédito antes de cada chamada, o TTL muda a reserva também. O relay do Foxl reserva para o pior caso, então uma requisição que pede um TTL de uma hora é reservada pela tarifa de gravação de uma hora. Essa tarifa (2 vezes) é 1,6 vez a tarifa de cinco minutos (1,25 vez), então uma chamada ao Sonnet 5.5 com 100 mil tokens de contexto reserva cerca de US$ 0,40 de entrada em vez de US$ 0,25. A cobrança continua sendo o que a chamada usou, mas, com um saldo quase vazio, a recusa pode vir uma chamada antes.
O que define o teto
O conteúdo novo. Cada nova mensagem do usuário e cada resposta é gravada uma vez no cache antes de poder ser lida, então nenhuma posição de breakpoints deixa uma chamada ler os tokens que ela está acrescentando. Na execução de uma hora, a primeira chamada não leu nada, porque as entradas de cinco minutos da execução anterior tinham expirado, então todos os 35.859 tokens lidos vieram das chamadas 2 a 9: 93,9% dos cerca de 38.200 tokens de entrada que elas consumiram. Os outros 2.300 e poucos eram as mensagens e respostas novas dessa execução, o que faz de 93,9% o teto desse cenário. Um chat mais longo carrega mais histórico por token novo, então o teto dele é mais alto.
Um prefixo estável maior também aumenta a proporção, sem deixar nada mais barato. Vimos isso quando o agente na nuvem ganhou uma opção para incluir os arquivos de memória do usuário: quatro arquivos Markdown (SOUL.md, USER.md, MEMORY.md e AGENTS.md) que o app para computador do Foxl coloca no próprio prompt. O celular ou o navegador copia esses arquivos enquanto o computador está conectado, corta-os com o mesmo código que o app para computador usa e os envia com cada mensagem na nuvem. Um conjunto real desses arquivos, cortado dessa forma, deu cerca de 41 mil caracteres, mais ou menos 14 mil tokens de entrada por chamada; a terceira execução usou um arquivo de teste do mesmo tamanho.
Nessa execução, a primeira chamada gravou 17.619 tokens do prompt da pessoa, todas as chamadas seguintes os leram e a taxa de acerto depois da primeira chamada chegou a 98,6%. A execução também custou US$ 0,1219 contra US$ 0,0494, porque o prompt é várias vezes maior; sem o cache, as mesmas nove chamadas teriam custado US$ 0,4187. Ela teve a melhor taxa de acerto das três execuções e a maior conta, e é por isso que colocamos o custo ao lado de cada taxa de acerto que informamos.
O que não medimos
- A produção depois da mudança. Até 23 de outubro de 2026, nenhum turno na nuvem rodou em produção desde que a mudança foi implantada, então 42,6% é o único número de produção, e os números de depois vêm do relay local no Bedrock de verdade.
- Outros modelos. Rodamos só o Sonnet 5.5. Os outros modelos Claude que recebem o TTL de uma hora o recebem com base na tabela do Bedrock e, no caso do Opus 5.5, numa medição anterior feita pelo nosso relay.
- Outros cenários. Nove chamadas num único padrão, nenhuma delas um turno com muitas chamadas de ferramenta. Um chat parado por mais de uma hora paga a primeira gravação de novo, e uma hora é o TTL mais longo que qualquer um dos dois provedores oferece para o Claude.
Se você roda os seus próprios agentes Claude, a taxa de acerto do cache é a coisa mais barata de verificar. Some os três contadores por chamada, divida as leituras pela entrada total e veja o que veio antes de cada chamada que gravou um prefixo grande. Se ela veio depois de um intervalo de mais de cinco minutos, um TTL de uma hora resolve, como resolveu quase todo o ganho deste cenário. Se veio depois de uma chamada feita segundos antes, ou o prefixo mudou entre as duas chamadas ou a gravação anterior estava fora do alcance da busca para trás, que é o que o terceiro breakpoint evita. Um post anterior mostra como manter um subagente no cache do agente pai (em inglês), a mesma regra de prefixo dentro de um único turno.
Referências e leituras complementares
- Anthropic: cache de promptDocumentação
- Amazon Bedrock: cache de prompt para uma inferência mais rápidaDocumentação
- Versão Foxl v0.9.3-beta.5Versão