Pourquoi notre agent cloud ratait son cache de prompt, et ce qu’a changé un TTL d’une heure
Notre agent cloud a lu 42,6 % de son entrée dans le cache de prompt sur ses 19 premiers tours en production, et chaque grosse écriture dans le cache est arrivée après une pause plus longue que les cinq minutes de durée de vie du cache. Un TTL d’une heure a fait passer une session mesurée de neuf appels de 71,8 % à 85,7 % (93,9 % après le premier appel) et a réduit son coût de 8 %, mais un chat qui se termine en moins de cinq minutes paie environ 23 % de plus. Comment nous l’avons mesuré, où placer les quatre points d’arrêt, et quand le TTL plus long en vaut la peine.
Sur cette page
L’agent cloud de Foxl répond aux chats qu’une personne envoie depuis son téléphone ou le web pendant que son ordinateur est éteint. Sur ses 19 premiers tours en production, il a lu 42,6 % de son entrée dans le cache de prompt. En examinant les grosses écritures dans le cache, nous avons vu que chacune arrivait après un intervalle de plus de cinq minutes, soit la durée de vie par défaut d’une entrée de cache. Quand on répond depuis un téléphone, on met souvent plus longtemps que cela.
Nous avons donné aux entrées de cache de l’agent une durée de vie d’une heure et relancé une session mesurée de neuf appels. Le taux de succès est passé de 71,8 % à 85,7 %, ou 93,9 % si l’on exclut le premier appel, qui écrit toujours. La session a coûté 8 % de moins au total et 15 % de moins en entrée, alors qu’une écriture d’une heure coûte deux fois le prix de base de l’entrée. Un chat terminé en moins de cinq minutes donne le résultat inverse : il paie double chaque écriture sans jamais la relire, et, une fois la pause retirée, les mêmes neuf appels coûtent environ 23 % de plus avec le réglage d’une heure qu’avec celui de cinq minutes. Le changement est sorti dans Foxl v0.9.3-beta.5, et la méthode s’applique à tout agent qui appelle Claude via l’API Messages, chez Anthropic ou sur Amazon Bedrock.
Comment mesurer le taux de succès d’un cache de prompt ?
Le taux de succès est la part des tokens d’entrée d’un appel que le fournisseur a lue dans son cache au lieu de la traiter à nouveau : cache_read / (uncached input + cache_read + cache_write). Le cache fonctionne par points d’arrêt. Un point d’arrêt de cache est un marqueur cache_control posé sur un bloc de la requête, qui demande au fournisseur de mettre en cache tout ce qui va jusqu’à ce bloc : le préfixe. L’entrée vit pendant son TTL (time to live, sa durée de vie), cinq minutes par défaut, et la requête suivante qui commence par le même préfixe la lit au lieu de la payer à nouveau. Bedrock appelle les points d’arrêt des checkpoints.
Chaque réponse de l’API Messages indique trois compteurs d’entrée, et la page d’Anthropic donne la relation entre eux : total_input_tokens = cache_read_input_tokens + cache_creation_input_tokens + input_tokens. input_tokens ne compte donc que ce qui n’a été ni lu dans le cache ni écrit dedans, et diviser cache_read par input_tokens donne un autre nombre, bien plus grand. L’API Converse de Bedrock documente la même chose pour ses propres champs : avec le cache activé, inputTokens « ne représente que les tokens d’entrée non mis en cache ».
Nous donnons deux chiffres pour chaque exécution. Le taux de succès sur tous les appels inclut le premier appel après l’expiration du cache, qui écrit toujours. Le taux de succès après le premier appel montre ce que coûte une conversation une fois son cache rempli. Une partie du prompt est identique pour tous les utilisateurs (le premier point d’arrêt ci-dessous) : en production, le premier appel d’une personne peut donc lire ce que la conversation de quelqu’un d’autre a écrit, et seul le chiffre sur tous les appels peut le montrer. Notre test tournait pour une seule personne, il ne mesure donc pas cet effet.
La référence de production vient des relevés de facturation de Foxl pour l’agent cloud : 19 tours dans 8 conversations depuis le lancement, avec 35 054 tokens lus dans le cache, 47 173 écrits et 72 non mis en cache. 35 054 / (35 054 + 47 173 + 72) donne 42,6 %. L’agent a écrit plus qu’il n’a lu : au moins 12 119 tokens (47 173 moins 35 054), environ un quart de ce qu’il a payé pour mettre en cache, n’ont jamais été relus.
Pourquoi un agent de chat rate son propre cache
Le relais de Foxl, le serveur situé entre les apps de Foxl et Bedrock, posait déjà trois points d’arrêt sur chaque requête Claude : sur le dernier outil, sur le prompt système et sur le dernier message de l’utilisateur, tous avec le TTL par défaut de cinq minutes. Quand les appels se suivaient de près, ils faisaient mouche. Une relance envoyée 15 secondes après une réponse a lu 3 616 tokens et en a écrit 44.
Les grosses écritures arrivaient toutes après des intervalles de plus de cinq minutes. Un message envoyé 26 minutes après la réponse précédente, ou un chat ouvert deux heures après le dernier, réécrivait tout le préfixe, environ 3,6 k tokens d’outils et de prompt système. Les recommandations d’AWS pour le cache d’une heure décrivent presque exactement ce cas : « lorsque vous stockez une longue conversation de chat avec un utilisateur et que vous vous attendez généralement à ce que cet utilisateur ne réponde pas dans les 5 prochaines minutes ».
Un succès rafraîchit aussi l’entrée gratuitement (« Le cache est rafraîchi sans coût supplémentaire chaque fois que le contenu en cache est utilisé »). Un agent qui enchaîne une boucle d’outils se heurte donc rarement à la limite de cinq minutes, sauf si un seul appel ou un seul outil dure plus de cinq minutes. Un chat avec une personne s’y heurte entre les tours, et c’est là qu’un tel chat passe le plus clair de son temps.
Où placer les quatre points d’arrêt
Une requête Claude peut porter au plus quatre points d’arrêt (Anthropic : « Vous pouvez définir jusqu’à 4 points d’arrêt de cache » ; Bedrock en indique 4 pour chaque modèle Claude de son tableau). Le préfixe en cache se lit dans l’ordre tools, system, messages, et un changement à n’importe quel endroit invalide tout ce qui suit. Les points d’arrêt du relais étaient tous à cinq minutes : l’agent cloud pose donc désormais lui-même les quatre, chacun avec son TTL. Le relais ne touche pas à une requête qui porte déjà des points d’arrêt et n’en ajoute aucun.
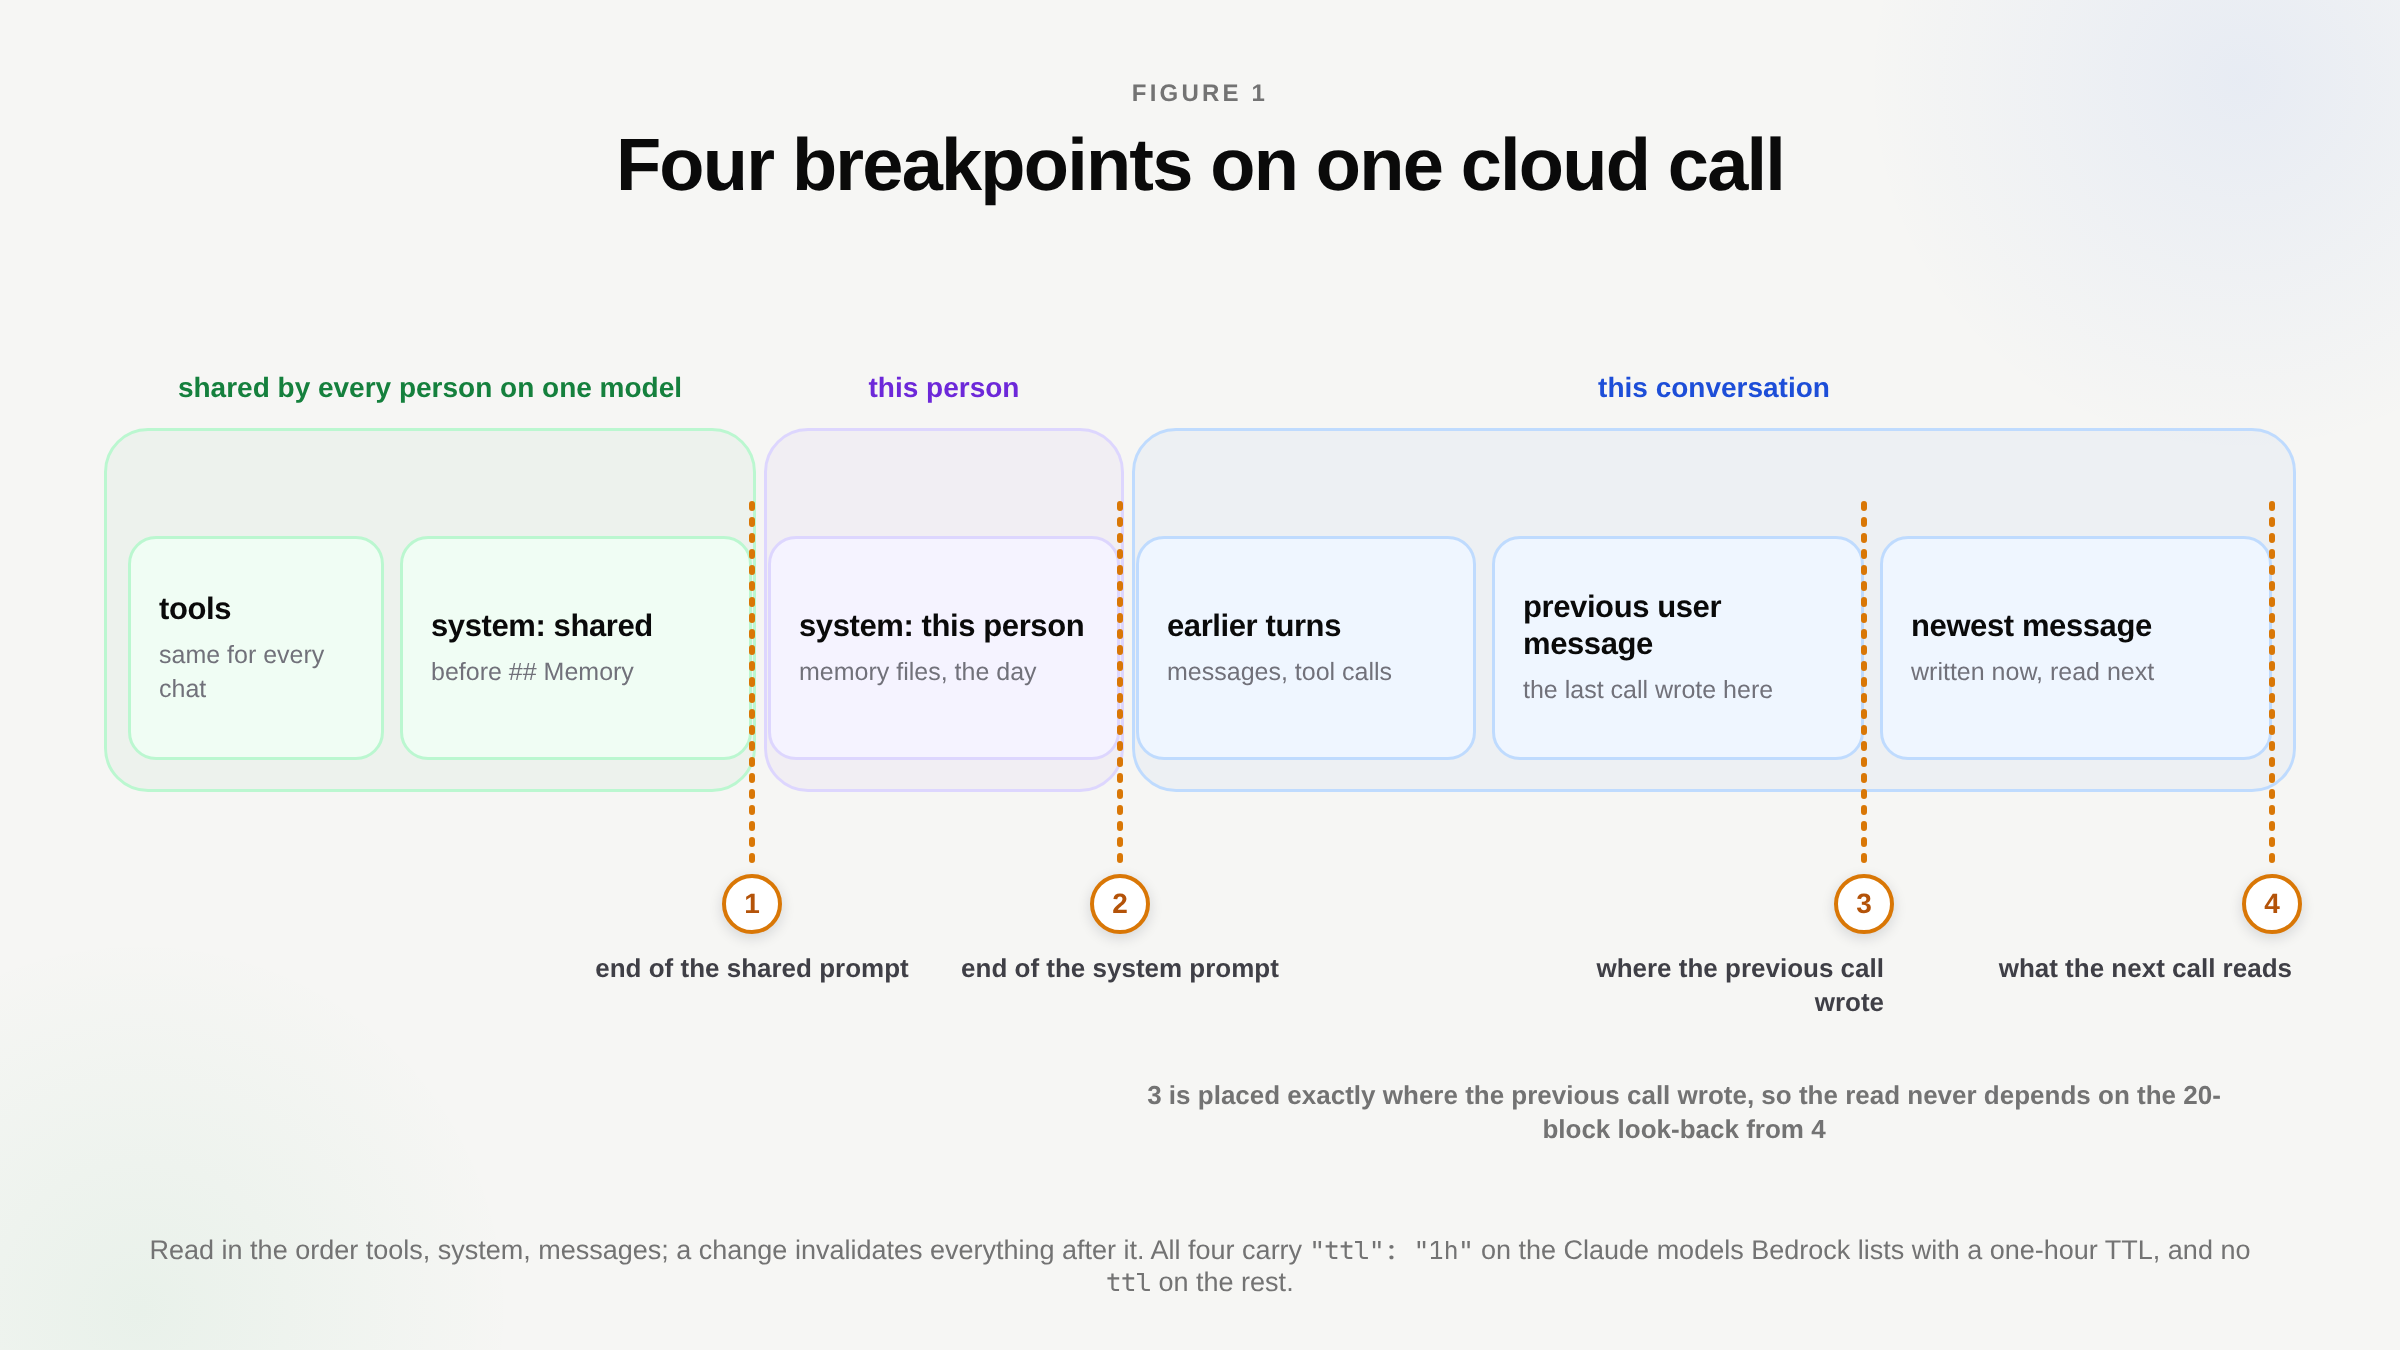
- La fin de la partie partagée du prompt système. Nous coupons notre prompt système là où commence la mémoire propre à chaque utilisateur, à un titre
## Memory. Les outils et tout ce qui se trouve au-dessus de ce titre (qui est l’agent, ce qu’il peut et ne peut pas faire dans le cloud) sont identiques pour toutes les conversations de toutes les personnes sur un même modèle : un tout nouveau chat, de n’importe qui, commence donc par les lire. - La fin du prompt système. Le deuxième point d’arrêt ajoute la mémoire de la personne et une ligne de date. La ligne de date donne le jour, pas l’heure : elle ne modifie donc pas le préfixe d’un appel à l’autre.
- Le dernier bloc pouvant être mis en cache du message utilisateur précédent. C’est exactement là que l’appel précédent a écrit : le lire ne dépend donc pas de la recherche en arrière de l’API. Sans ce point d’arrêt, l’API part du plus récent et remonte à la recherche d’une entrée de cache antérieure, mais seulement jusqu’à un certain point (« La fenêtre de recherche en arrière est de 20 blocs »), et un tour qui comporte de nombreux appels d’outils peut repousser l’écriture précédente hors de portée. La façon de compter ces blocs dépend de l’endroit où vous appelez Claude : l’API d’Anthropic compte une suite de blocs
tool_useoutool_resultconsécutifs comme une seule position, tandis que la page de Bedrock dit seulement « environ 20 blocs de contenu » et ne prévoit pas d’exception de ce genre. - Le dernier bloc pouvant être mis en cache du message le plus récent. C’est l’écriture que lira l’appel suivant.
Les quatre utilisent le même TTL. Bedrock accepte les deux TTL dans une même requête tant que chaque entrée d’une heure vient en premier (« une entrée de cache d’une heure doit apparaître avant toute entrée de cache de 5 minutes »), et un seul TTL pour les quatre garantit cela sans aucune vérification. Les points d’arrêt ne se posent que sur des blocs text, image, document, tool_use et tool_result, c’est-à-dire le contenu de message qu’Anthropic liste comme pouvant être mis en cache.
Le TTL d’une heure ne va qu’aux modèles Claude que le tableau de Bedrock liste avec « Supported TTL: 5 minutes, 1 hour ». Bedrock avertit qu’envoyer ce champ à un modèle qui ne prend en charge que cinq minutes « peut entraîner une ValidationException » : les autres modèles Claude reçoivent donc les mêmes quatre points d’arrêt sans ttl. Nous laissons de côté GPT-5.6 et les versions suivantes sur Bedrock : ils utilisent leur propre champ prompt_cache_breakpoint et, selon la même page, un « TTL minimum de 30 minutes ».
// the marker on each of the four blocks, on a model that takes it
"cache_control": { "type": "ephemeral", "ttl": "1h" }
Il existe aussi une taille minimale. Bedrock ne met un checkpoint en cache que si tout ce qui le précède atteint la longueur minimale du modèle : 512 tokens sur les modèles 5.5, et 1 024 ou 4 096 sur certains modèles plus anciens. En dessous du minimum, « votre inférence réussit quand même, mais votre préfixe n’est pas mis en cache ». Sur un modèle dont le minimum est de 4 096 tokens, un prompt de 3,6 k tokens laisse les points d’arrêt des outils et du système sans rien mettre en cache tant que la conversation elle-même n’a pas fait passer le préfixe au-delà du minimum : vérifiez donc le tableau pour chaque modèle que vous servez.
Un cache d’une heure coûte-t-il plus qu’il ne fait économiser ?
Aux prix d’Anthropic, une écriture de cinq minutes coûte 1,25 fois le prix de base de l’entrée, une écriture d’une heure 2 fois, et une lecture 0,1 fois (0,05 fois sur Opus 5.5 et Sonnet 5.5). Une écriture d’une heure coûte donc 0,75 fois le prix de base de plus qu’une écriture de cinq minutes. Vous payez ce supplément sur le préfixe une fois par heure, et sur le nouveau contenu de chaque appel à chaque fois. En échange, une pause de plus de cinq minutes ne réécrit plus tout le préfixe à 1,25 fois : le préfixe est lu à la place.
Pour le mesurer, nous avons fait tourner le code de production de l’agent cloud via une copie locale de notre relais, contre le vrai Bedrock. Le scénario est un chat de quatre tours (un plan suivi avec un outil, une relance, l’enregistrement d’un fichier, puis une question sur le premier tour 6,5 minutes plus tard), suivi d’un nouveau chat. Cela fait neuf appels au modèle sur Sonnet 5.5, puisqu’un tour qui utilise un outil fait plus d’un appel. L’utilisation a été lue dans le flux renvoyé par Bedrock, et la colonne des coûts applique les prix par token propres à Foxl pour Sonnet 5.5.
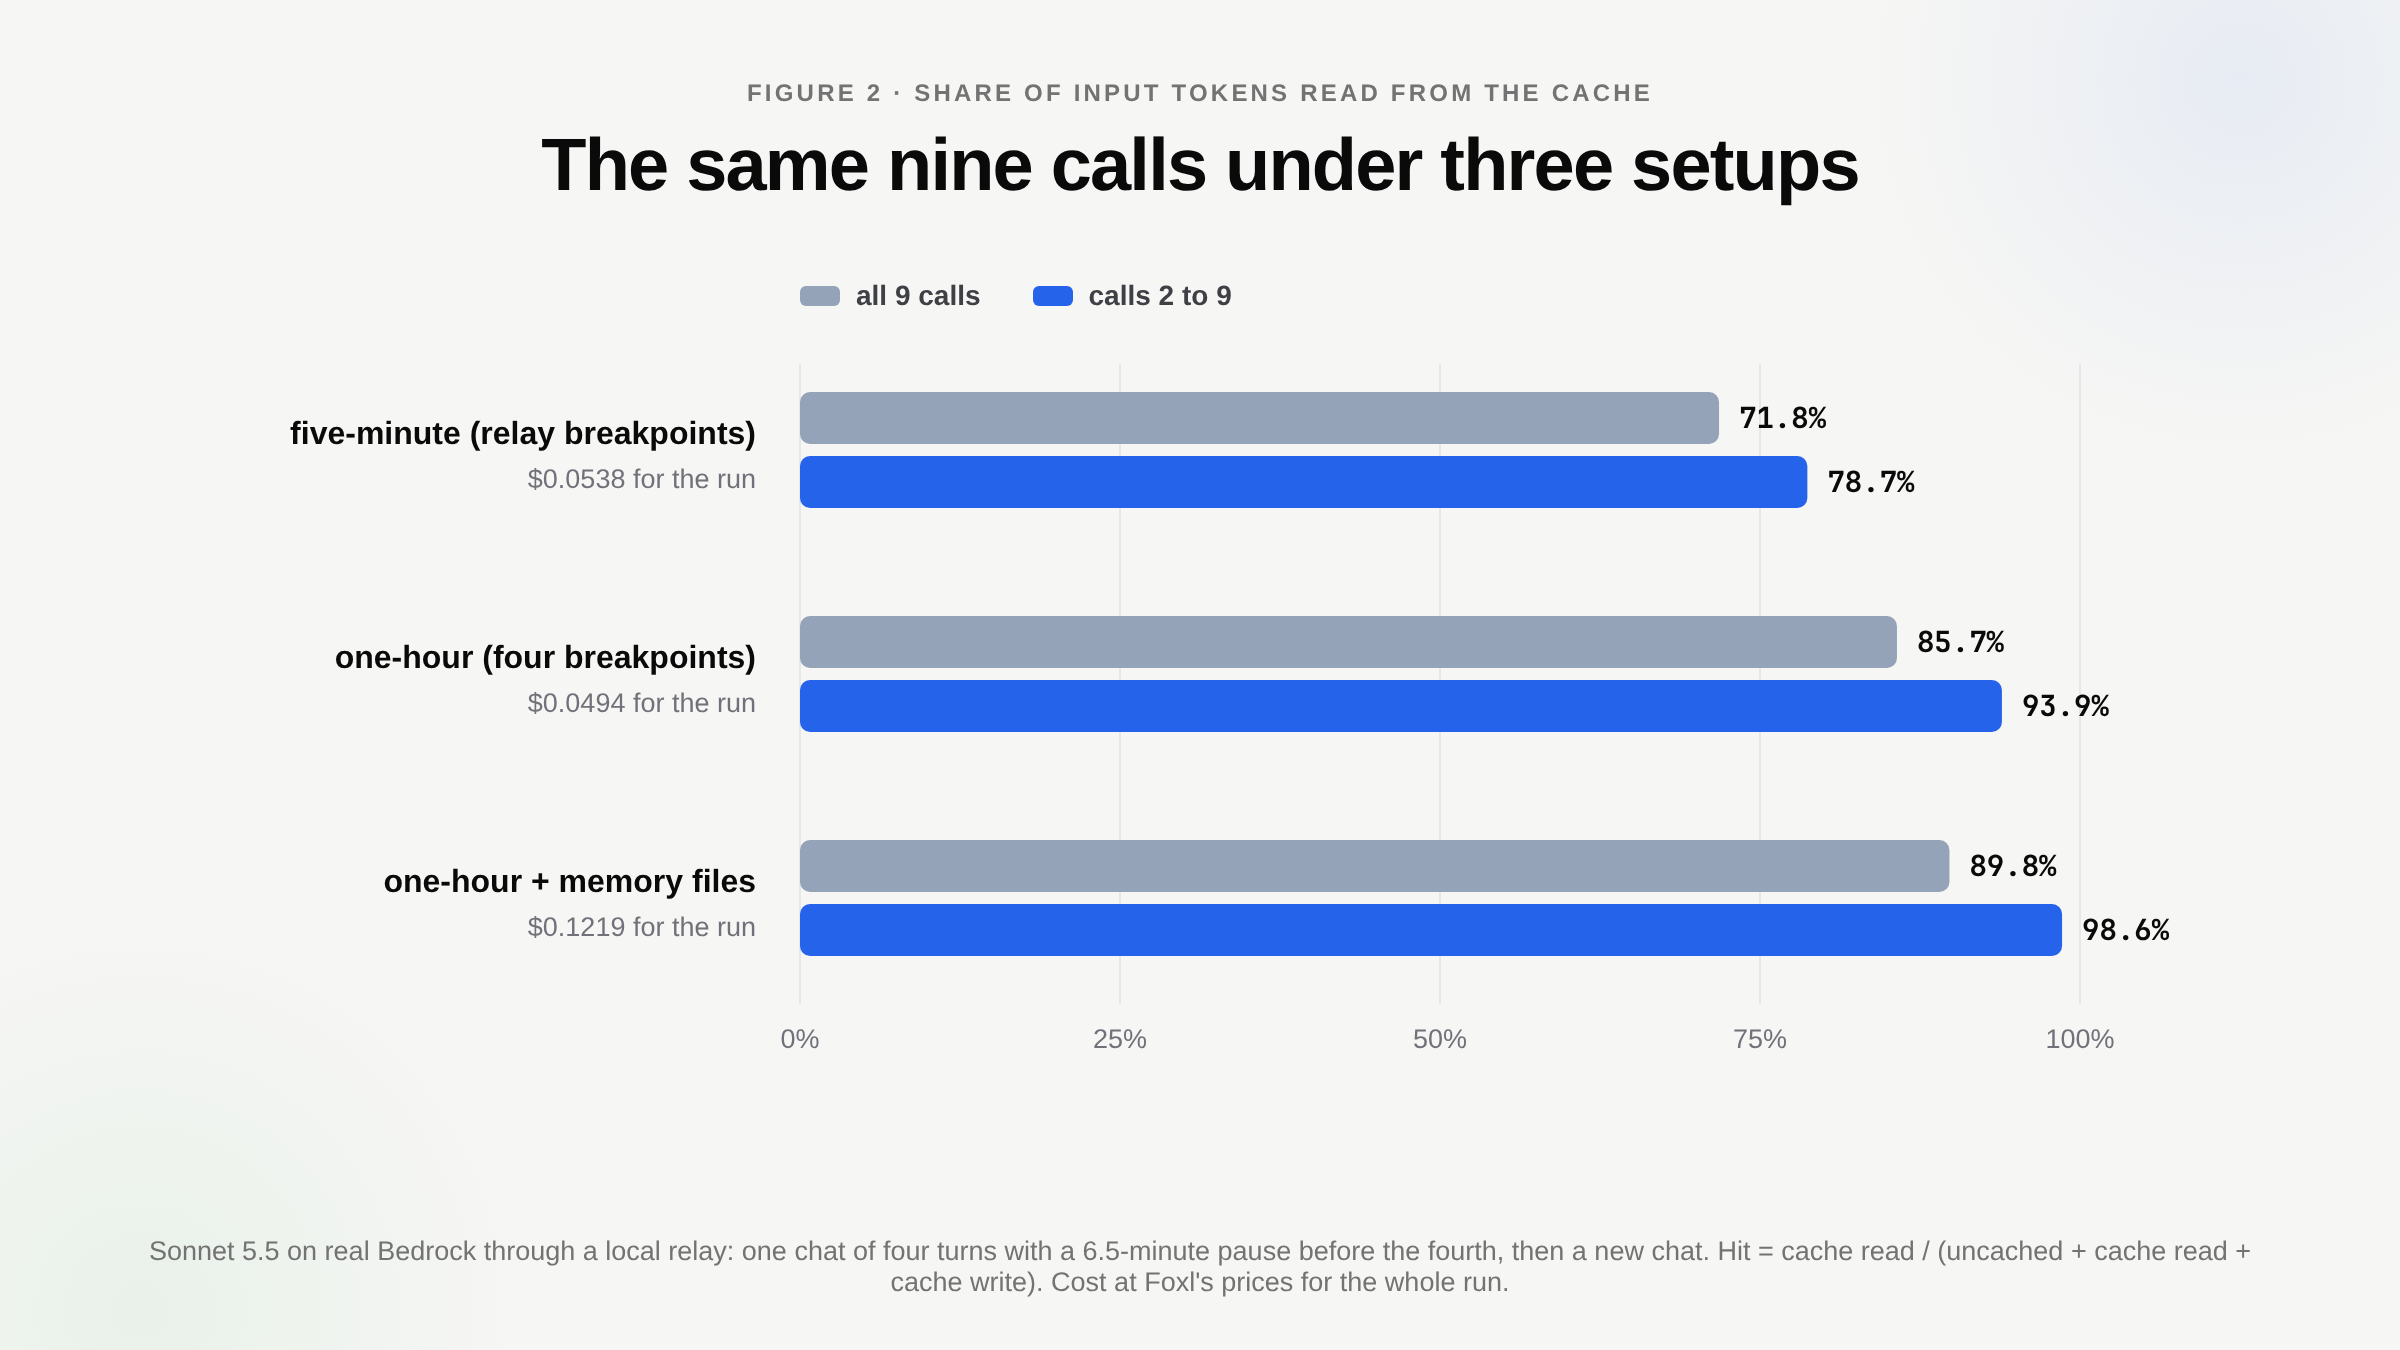
| configuration | lecture du cache | écriture du cache | succès, les 9 appels | succès, appels 2 à 9 | coût de l’exécution |
|---|---|---|---|---|---|
| cinq minutes (les points d’arrêt du relais) | 29 979 | 11 755 (5 min) | 71,8 % | 78,7 % | 0,0538 $ |
| une heure (quatre points d’arrêt) | 35 859 | 5 974 (1 h) | 85,7 % | 93,9 % | 0,0494 $ |
| une heure, avec les fichiers de mémoire (expliqué plus bas) | 177 347 | 20 108 (1 h) | 89,8 % | 98,6 % | 0,1219 $ |
Presque toute la différence vient de l’appel qui suit la pause de 6,5 minutes. Avec des entrées de cinq minutes, il a réécrit son préfixe de 5 873 tokens. Avec des entrées d’une heure, il a lu 5 750 tokens et en a écrit 133, et Bedrock a déclaré chaque écriture sous ephemeral_1h_input_tokens : c’est ainsi que nous savons que le TTL plus long a bien été appliqué et n’a pas été ignoré en silence. L’exécution à une heure a lu 5 880 tokens de plus que celle à cinq minutes (35 859 moins 29 979) ; 5 750 venaient de ce seul appel, et les quelque 130 autres du déplacement des points d’arrêt. Le scénario ne comportait aucun tour avec de nombreux appels d’outils, le cas pour lequel existe le troisième point d’arrêt. L’entrée non mise en cache était de 28 tokens dans chaque exécution.
La configuration à cinq minutes obtient 71,8 % dans ce test contre 42,6 % en production, parce que le test comporte un seul intervalle de 6,5 minutes, alors que les 19 tours de la production étaient répartis sur 8 conversations, avec des intervalles de 26 minutes et de deux heures. Le même code obtient des scores très différents selon le trafic : ne comparez donc des taux de succès qu’entre des exécutions du même scénario.
Sans la pause, le résultat s’inverse. Retirez-la des mêmes mesures et la configuration à cinq minutes ne réécrit jamais son préfixe : c’est donc elle la moins chère. L’exécution à une heure coûte environ 23 % de plus au total et environ 48 % de plus en entrée, parce qu’elle a payé deux fois le prix de base pour chaque écriture et que rien ne les a relues après la cinquième minute.
Pour votre propre trafic sur Sonnet 5.5 ou Opus 5.5, comparez deux chiffres :
- L’économie : chaque token de préfixe qu’une pause vous aurait obligé à réécrire fait économiser environ 1,2 fois le prix de base (une réécriture à 1,25 remplacée par une lecture à 0,05).
- Le supplément : chaque token écrit pendant cette heure coûte 0,75 fois le prix de base de plus (2 au lieu de 1,25).
Le TTL d’une heure l’emporte quand l’économie est la plus grande. Un chat avec une pause de cinq à soixante minutes y parvient généralement, tout comme un deuxième chat commencé dans l’heure ; un chat terminé en moins de cinq minutes, sans rien d’autre dans l’heure, n’y parvient pas. Pour des personnes qui répondent depuis un téléphone, nous avons choisi une heure. Pour un agent dont les appels arrivent à quelques secondes d’intervalle, cinq minutes est le meilleur réglage.
Si vous réservez du crédit avant chaque appel, le TTL change aussi la réservation. Le relais de Foxl réserve pour le pire cas : une requête qui demande un TTL d’une heure est donc réservée au tarif d’écriture d’une heure. Ce tarif (2 fois) vaut 1,6 fois le tarif à cinq minutes (1,25 fois) : un appel Sonnet 5.5 avec 100 000 tokens de contexte réserve donc environ 0,40 $ d’entrée au lieu de 0,25 $. Le montant facturé reste ce que l’appel a consommé, mais un solde presque vide peut être refusé un appel plus tôt.
Ce qui fixe le plafond
Le nouveau contenu. Chaque nouveau message de l’utilisateur et chaque réponse sont écrits une fois dans le cache avant de pouvoir être lus : aucun placement de points d’arrêt ne permet donc à un appel de lire les tokens qu’il ajoute. Dans l’exécution à une heure, le premier appel n’a rien lu, car les entrées de cinq minutes de l’exécution précédente avaient expiré : les 35 859 tokens lus venaient donc tous des appels 2 à 9, soit 93,9 % des quelque 38 200 tokens d’entrée qu’ils ont consommés. Les quelque 2 300 restants étaient les nouveaux messages et réponses de cette exécution, ce qui fait de 93,9 % le plafond de ce scénario. Un chat plus long porte plus d’historique par nouveau token : son plafond est donc plus élevé.
Un préfixe stable plus grand fait aussi monter le ratio, sans rien rendre moins cher. Nous l’avons vu quand l’agent cloud a gagné une option pour inclure les fichiers de mémoire de l’utilisateur : quatre fichiers Markdown (SOUL.md, USER.md, MEMORY.md et AGENTS.md) que l’app de bureau de Foxl place dans son propre prompt. Le téléphone ou le navigateur les copie pendant que l’ordinateur est connecté, les tronque avec le même code que l’app de bureau et les envoie avec chaque message cloud. Un vrai jeu de ces fichiers, tronqué de cette façon, faisait environ 41 000 caractères, soit à peu près 14 000 tokens d’entrée par appel ; la troisième exécution a utilisé un fichier de test de la même taille.
Dans cette exécution, le premier appel a écrit 17 619 tokens du prompt de la personne, chaque appel suivant les a lus, et le taux de succès après le premier appel a atteint 98,6 %. L’exécution a aussi coûté 0,1219 $ contre 0,0494 $, parce que le prompt est plusieurs fois plus gros ; sans le cache, les mêmes neuf appels auraient coûté 0,4187 $. Elle avait le meilleur taux de succès des trois exécutions et la facture la plus élevée : c’est pourquoi nous indiquons le coût à côté de chaque taux de succès que nous publions.
Ce que nous n’avons pas mesuré
- La production après le changement. Au 23 octobre 2026, aucun tour cloud n’a tourné en production depuis le déploiement du changement : 42,6 % est donc le seul chiffre de production, et les chiffres d’après viennent du relais local sur le vrai Bedrock.
- Les autres modèles. Nous n’avons testé que Sonnet 5.5. Les autres modèles Claude qui reçoivent le TTL d’une heure le reçoivent sur la foi du tableau de Bedrock et, pour Opus 5.5, d’une mesure antérieure faite via notre relais.
- Les autres scénarios. Neuf appels selon un seul schéma, dont aucun n’est un tour avec de nombreux appels d’outils. Un chat inactif pendant plus d’une heure paie à nouveau la première écriture, et une heure est le TTL le plus long que l’un ou l’autre fournisseur propose pour Claude.
Si vous faites tourner vos propres agents Claude, le taux de succès du cache est la chose la moins chère à vérifier. Additionnez les trois compteurs par appel, divisez les lectures par l’entrée totale, et regardez ce qui a précédé chaque appel qui a écrit un gros préfixe. S’il suivait un intervalle de plus de cinq minutes, un TTL d’une heure règle le problème, comme il l’a fait pour presque tout le gain de ce scénario. S’il suivait un appel passé quelques secondes plus tôt, soit le préfixe a changé entre les deux appels, soit l’écriture précédente était hors de portée de la recherche en arrière, ce que le troisième point d’arrêt évite. Un article précédent explique comment garder un sous-agent sur le cache de son parent (en anglais), la même règle de préfixe à l’intérieur d’un seul tour.