在自己的电脑上本地运行 Gemma 4:免费、离线,不用终端
在 Foxl 的设置里点一下“下载”按钮,就能获取 Google 的 Gemma 4 和运行它的引擎,然后在搭载 Apple silicon 的 Mac 或 x64 的 Windows、Linux 电脑上离线和它聊天,不用终端,也不用 API 密钥。本文介绍 E2B、E4B 和 12B 哪个适合你的内存,以及这个模型在 Foxl 里能做什么、不能做什么,并附上 v0.9.2 的截图。
本页内容
Foxl 可以下载 Google 的 Gemma 4,并在你的电脑上运行它,全程不用终端。打开“设置 > 模型和提供商”,滚动到“在此设备上运行”,在某个 Gemma 4 模型旁边选择“下载”。Foxl 会获取模型和运行它的引擎;等那一行显示“已就绪”,你就可以在 Foxl Agent 里离线和它聊天,不需要 API 密钥,也不需要账户。它支持搭载 Apple silicon 的 Mac,以及 x64 的 Windows 和 Linux 电脑。
关于 Gemma 4
Gemma 4 是 Google 的开放权重模型系列,以 Apache 2.0 许可证发布,所以你可以下载模型本身,在自己的硬件上运行。其中两个小模型 E2B 和 E4B 的体量适合普通电脑。由于模型在你的机器上运行,你输入给它的内容不必离开这台机器。
安装步骤
- 在搭载 Apple silicon 的 Mac,或 x64 的 Windows 或 Linux 电脑上安装 Foxl。
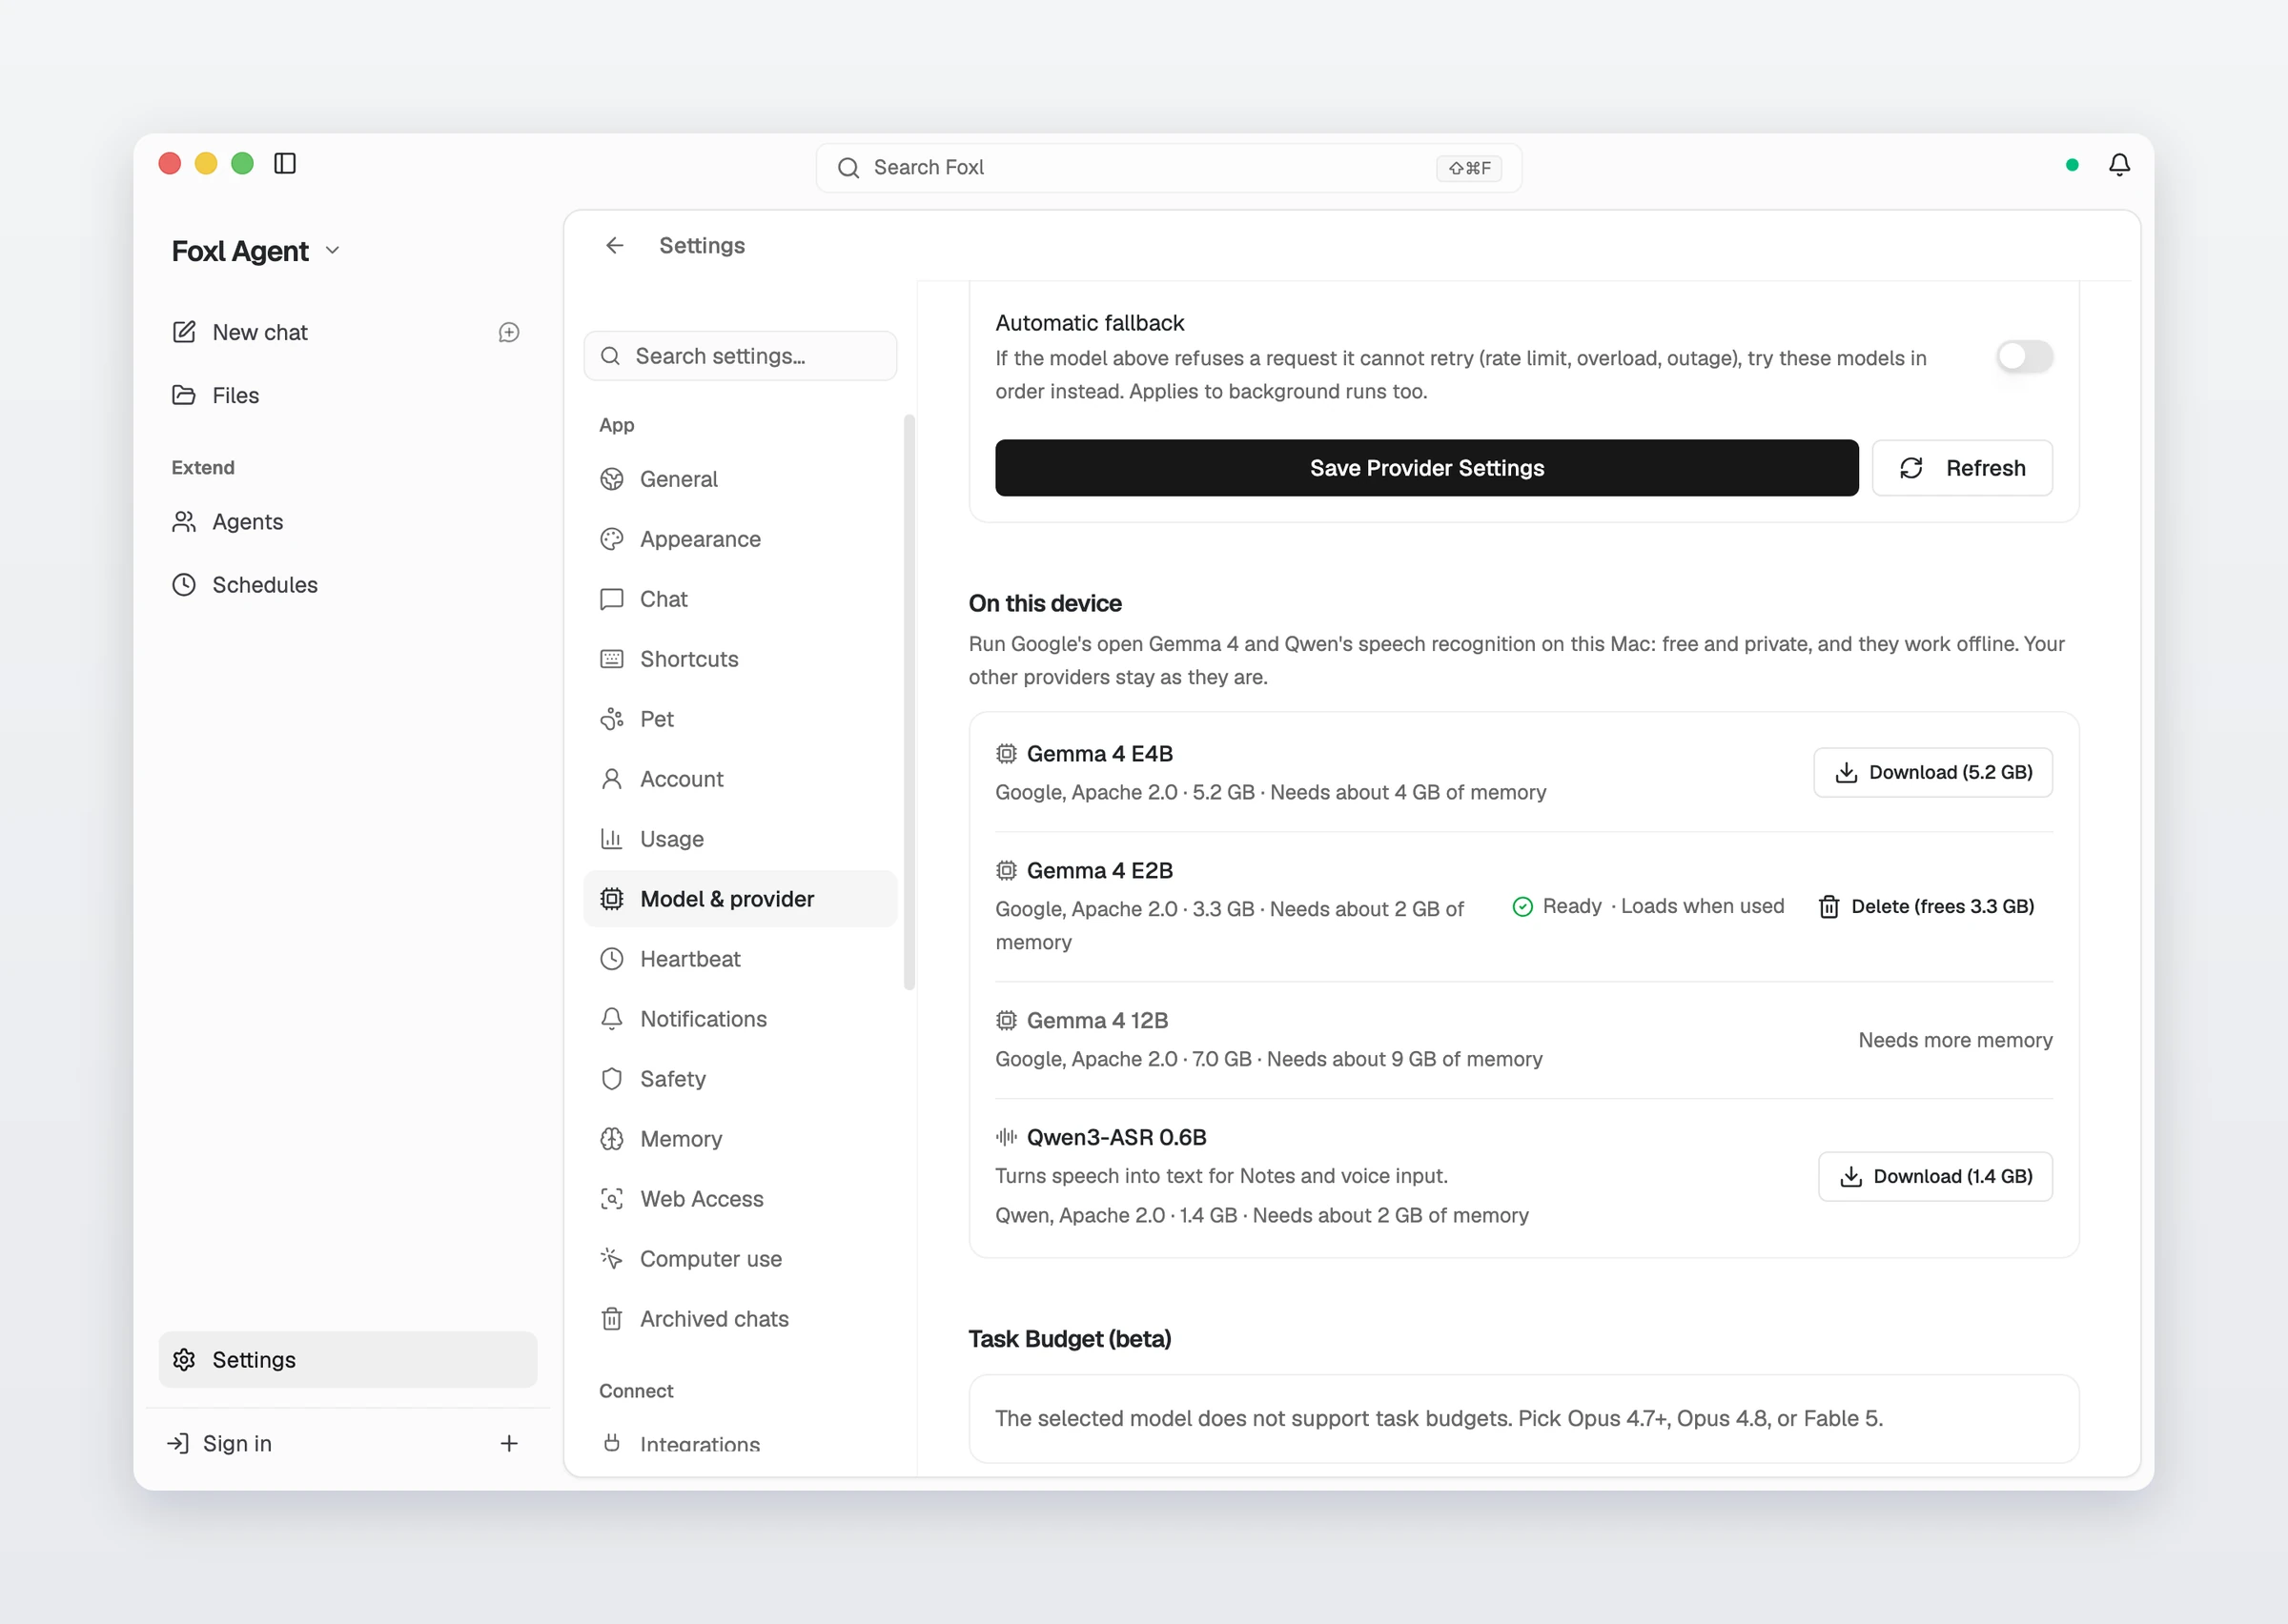
- 打开“设置 > 模型和提供商”,滚动到“在此设备上运行”。
- 在 Gemma 4 E2B 或 Gemma 4 E4B 旁边选择“下载”。按钮上会显示大小。下载可以暂停,之后再继续;下载完成时,Foxl 会校验文件。
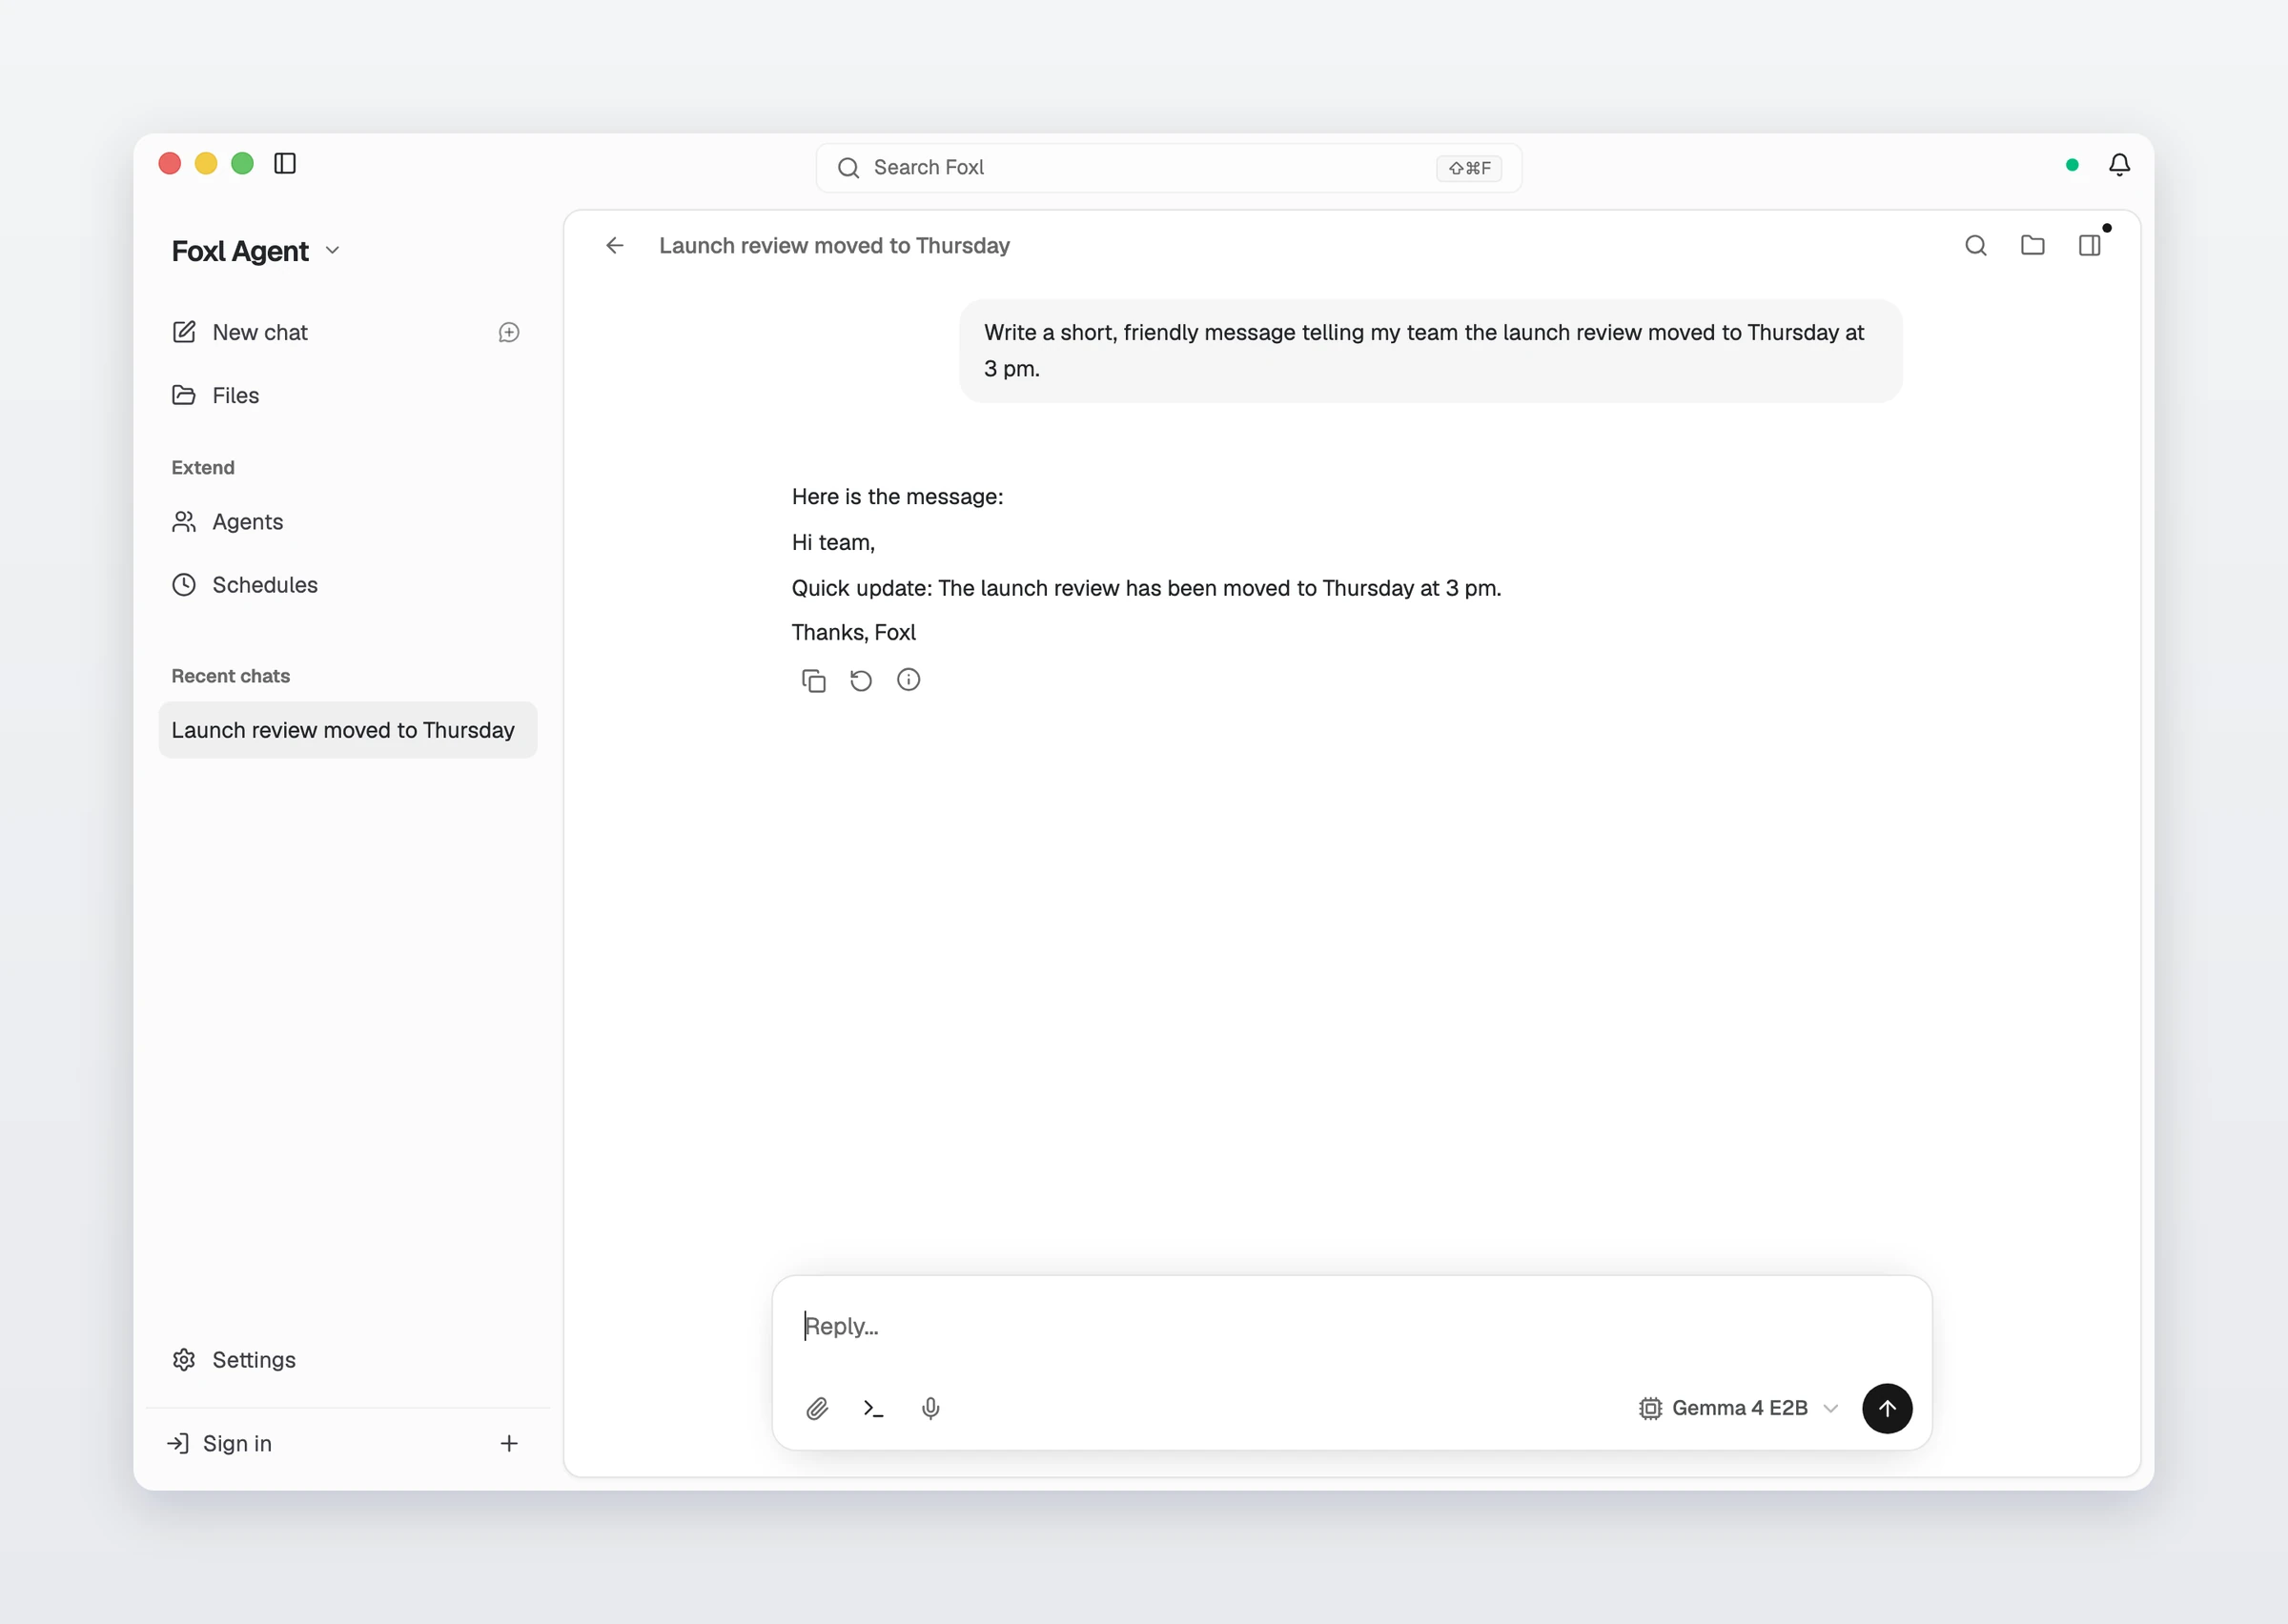
- 那一行显示“已就绪”后,开始一个聊天。如果这台电脑上没有其他能回答聊天的模型,Foxl 会自动选中 Gemma 4;否则,请在消息框下方的模型菜单里选择它。
在还没有设置任何模型时新建聊天,也会看到同样的下载入口,名为“在这台 Mac 上运行 AI”(在 Windows 和 Linux 上是“在这台电脑上运行 AI”)。
哪个模型适合你的电脑?
- Gemma 4 E2B:下载 3.3 GB,适合内存 8 GB 及以上的电脑。
- Gemma 4 E4B:下载 5.2 GB,适合 16 GB 及以上。电脑内存够用时,Foxl 会推荐它。
- Gemma 4 12B:下载 7.0 GB,适合 32 GB 及以上。
如果电脑内存不够运行某个模型,那一行显示的就不是“下载”按钮,而是“需要更多内存”。每个模型一次最多读取 32,768 个 token 的对话,在内存为 32 GB 的电脑上是 65,536 个。
它在 Foxl 里能做什么
除了回答聊天,它还能使用一小组工具:读写文件、运行 shell 命令、联网时读取网页、维护清单,以及回忆之前的对话。Foxl 给设备端模型的工具比云端模型少,这样新建的聊天仍然放得进它的上下文窗口;因此,MCP 服务器、已连接的应用、浏览器、计划任务和子智能体都只留给云端模型。Foxl Notes 也可以用它来写摘要。
确认它一直离线
下载完成后,模型和引擎就是你电脑上的文件,Foxl 在电脑本机上与引擎通信。制作这篇指南时,我们在每次回答的过程中都监视了引擎的网络连接,它唯一的连接对象就是同一台电脑上的 Foxl。读取网页是唯一需要联网的工具。
局限
- 它不能在 Intel Mac 上运行,也不能在 Arm 架构的 Windows 或 Linux 上运行。
- 它是一个小模型。在又长又难的任务上,大型云端模型表现更好,而你的其他提供商仍在同一个菜单里。
- 其他开放模型不在这个列表里。要用它们,Foxl 可以连接 Ollama 和 LM Studio。